
機械学習の評価ではよい点数が出たのに、新しい材料や次の作製バッチでは当たらない。このとき、モデルの種類を変える前に確認したいのが、学習データと評価データの分け方です。
同じ試料の繰り返し測定、同じ作製バッチの試料、近い材料系列が両側に入ると、実際に使いたい場面よりも簡単な課題を評価している可能性があります。一方、分割を厳しくすれば常に正しいわけでもありません。将来、何を新しく予測するのかに合わせて評価を設計することが重要です。
本記事では、交差検証の仕組みを小さな表から説明し、Pythonでランダム分割、バッチ単位の分割、ネスト交差検証を実行します。サンプルデータの生成から評価結果の保存まで、一つのスクリプトで動かせます。使用する条件・特性値は編集部の合成データであり、実在材料の測定値や公開論文の実証結果ではありません。
1.交差検証とは? 学習と評価を小さな表で理解する
学習データと評価データを分ける理由
学習データは、説明変数から目的変数を予測する関係をモデルに覚えさせるためのデータです。評価データは、学習に使っていない記録への予測を確認するためのデータです。例えば、組成比と作製温度から強度を予測するとき、組成比・温度が説明変数、強度が目的変数になります。
学習した記録への当てはまりだけでは、新しい試料でも予測できるとは判断できません。学習では測定ノイズや偶然の関係まで取り込むことがあるためです。少数データでのモデル選択の全体像は、材料開発の少数データで機械学習を使う方法を参照してください。本記事では評価を実際に動かす手順に集中します。
ホールドアウトとK-fold交差検証の違い
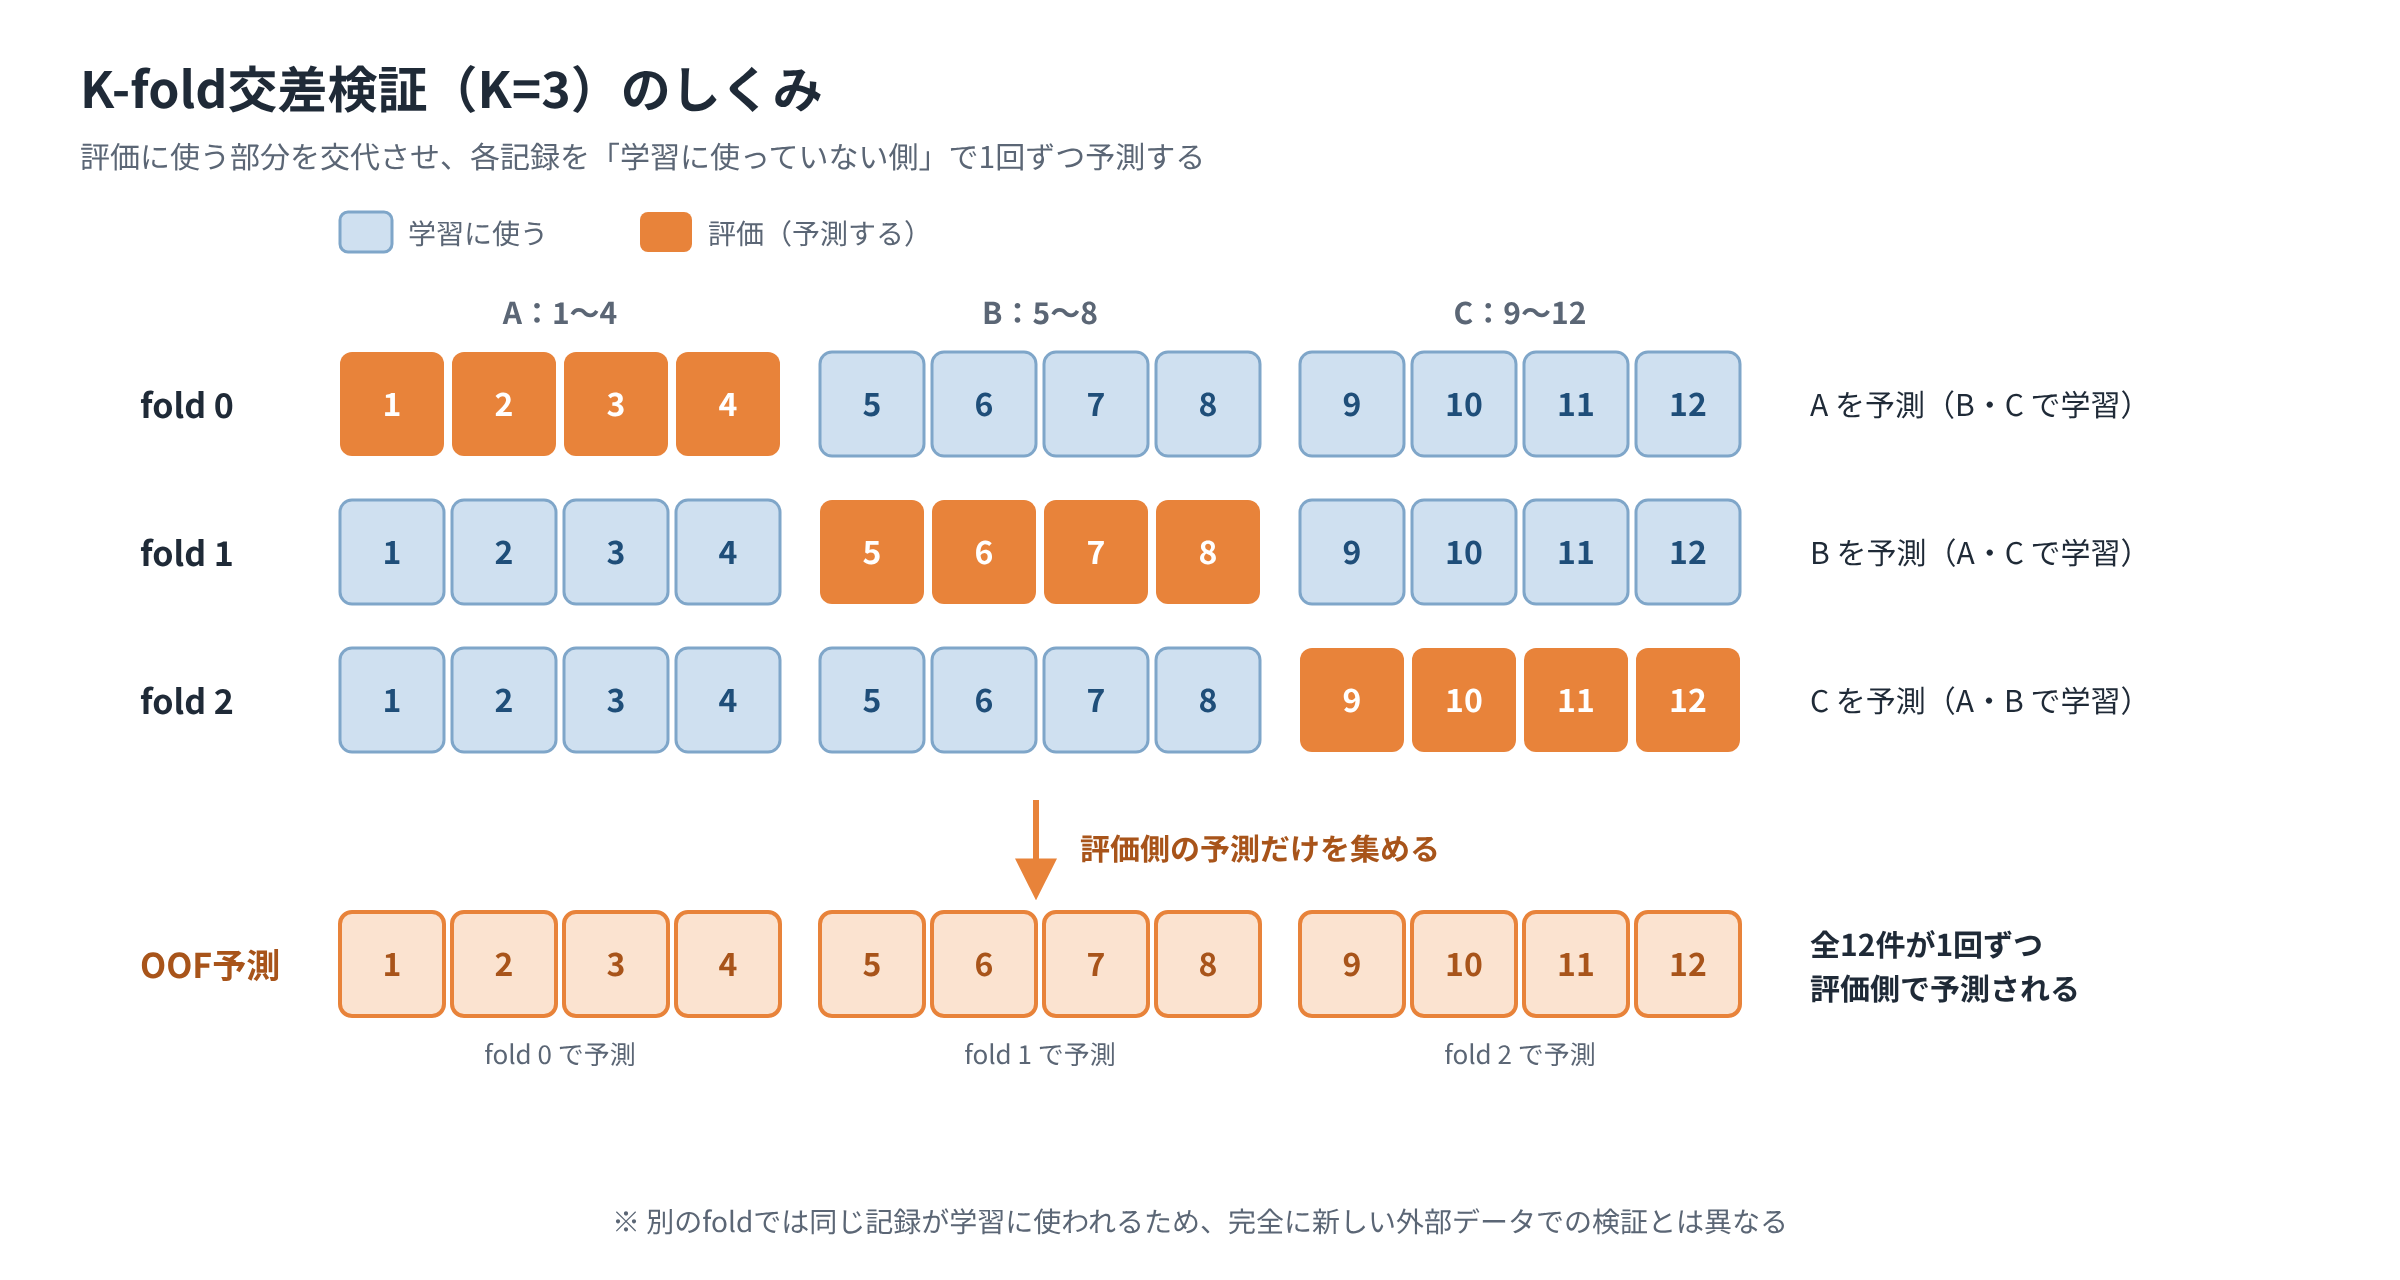
ホールドアウトは、一部を学習用、残りを評価用として一度分ける方法です。K-fold交差検証はデータをK個に分け、評価に使う部分を交代させます。Kは分割数、foldは各分割を指します。
12件をA・B・Cの三つの部分へ分けた例では、次のように三回の学習・評価を行います。
| 回 | 学習する記録 | 評価する記録 |
|---|---|---|
| fold 0 | B:5〜8、C:9〜12 | A:1〜4 |
| fold 1 | A:1〜4、C:9〜12 | B:5〜8 |
| fold 2 | A:1〜4、B:5〜8 | C:9〜12 |
ここでは各記録を一回ずつ、学習に使われていない側で予測します。この予測をout-of-fold(OOF)予測と呼びます。ただし、別foldでは同じ記録が学習に使われます。完全に新しい外部データによる検証と同じではありません。
モデル選択と最終評価を区別する
モデルや設定を比べて選ぶためのデータを、検証用データと呼びます。選択した結果を最後に確認するために温存するデータが、最終評価用データです。交差検証の各評価部分も、設定を選ぶために使えば検証用の役割を持ちます。
「何種類も試して一番よい交差検証スコアを報告する」場合、その数字には選択の影響が含まれます。モデル選択の過適合と評価の偏りは原著論文でも検討されています。[4]選択と評価を分ける方法として、第7章でネスト交差検証を説明します。
2.何を新しく予測するかで分割を選ぶ
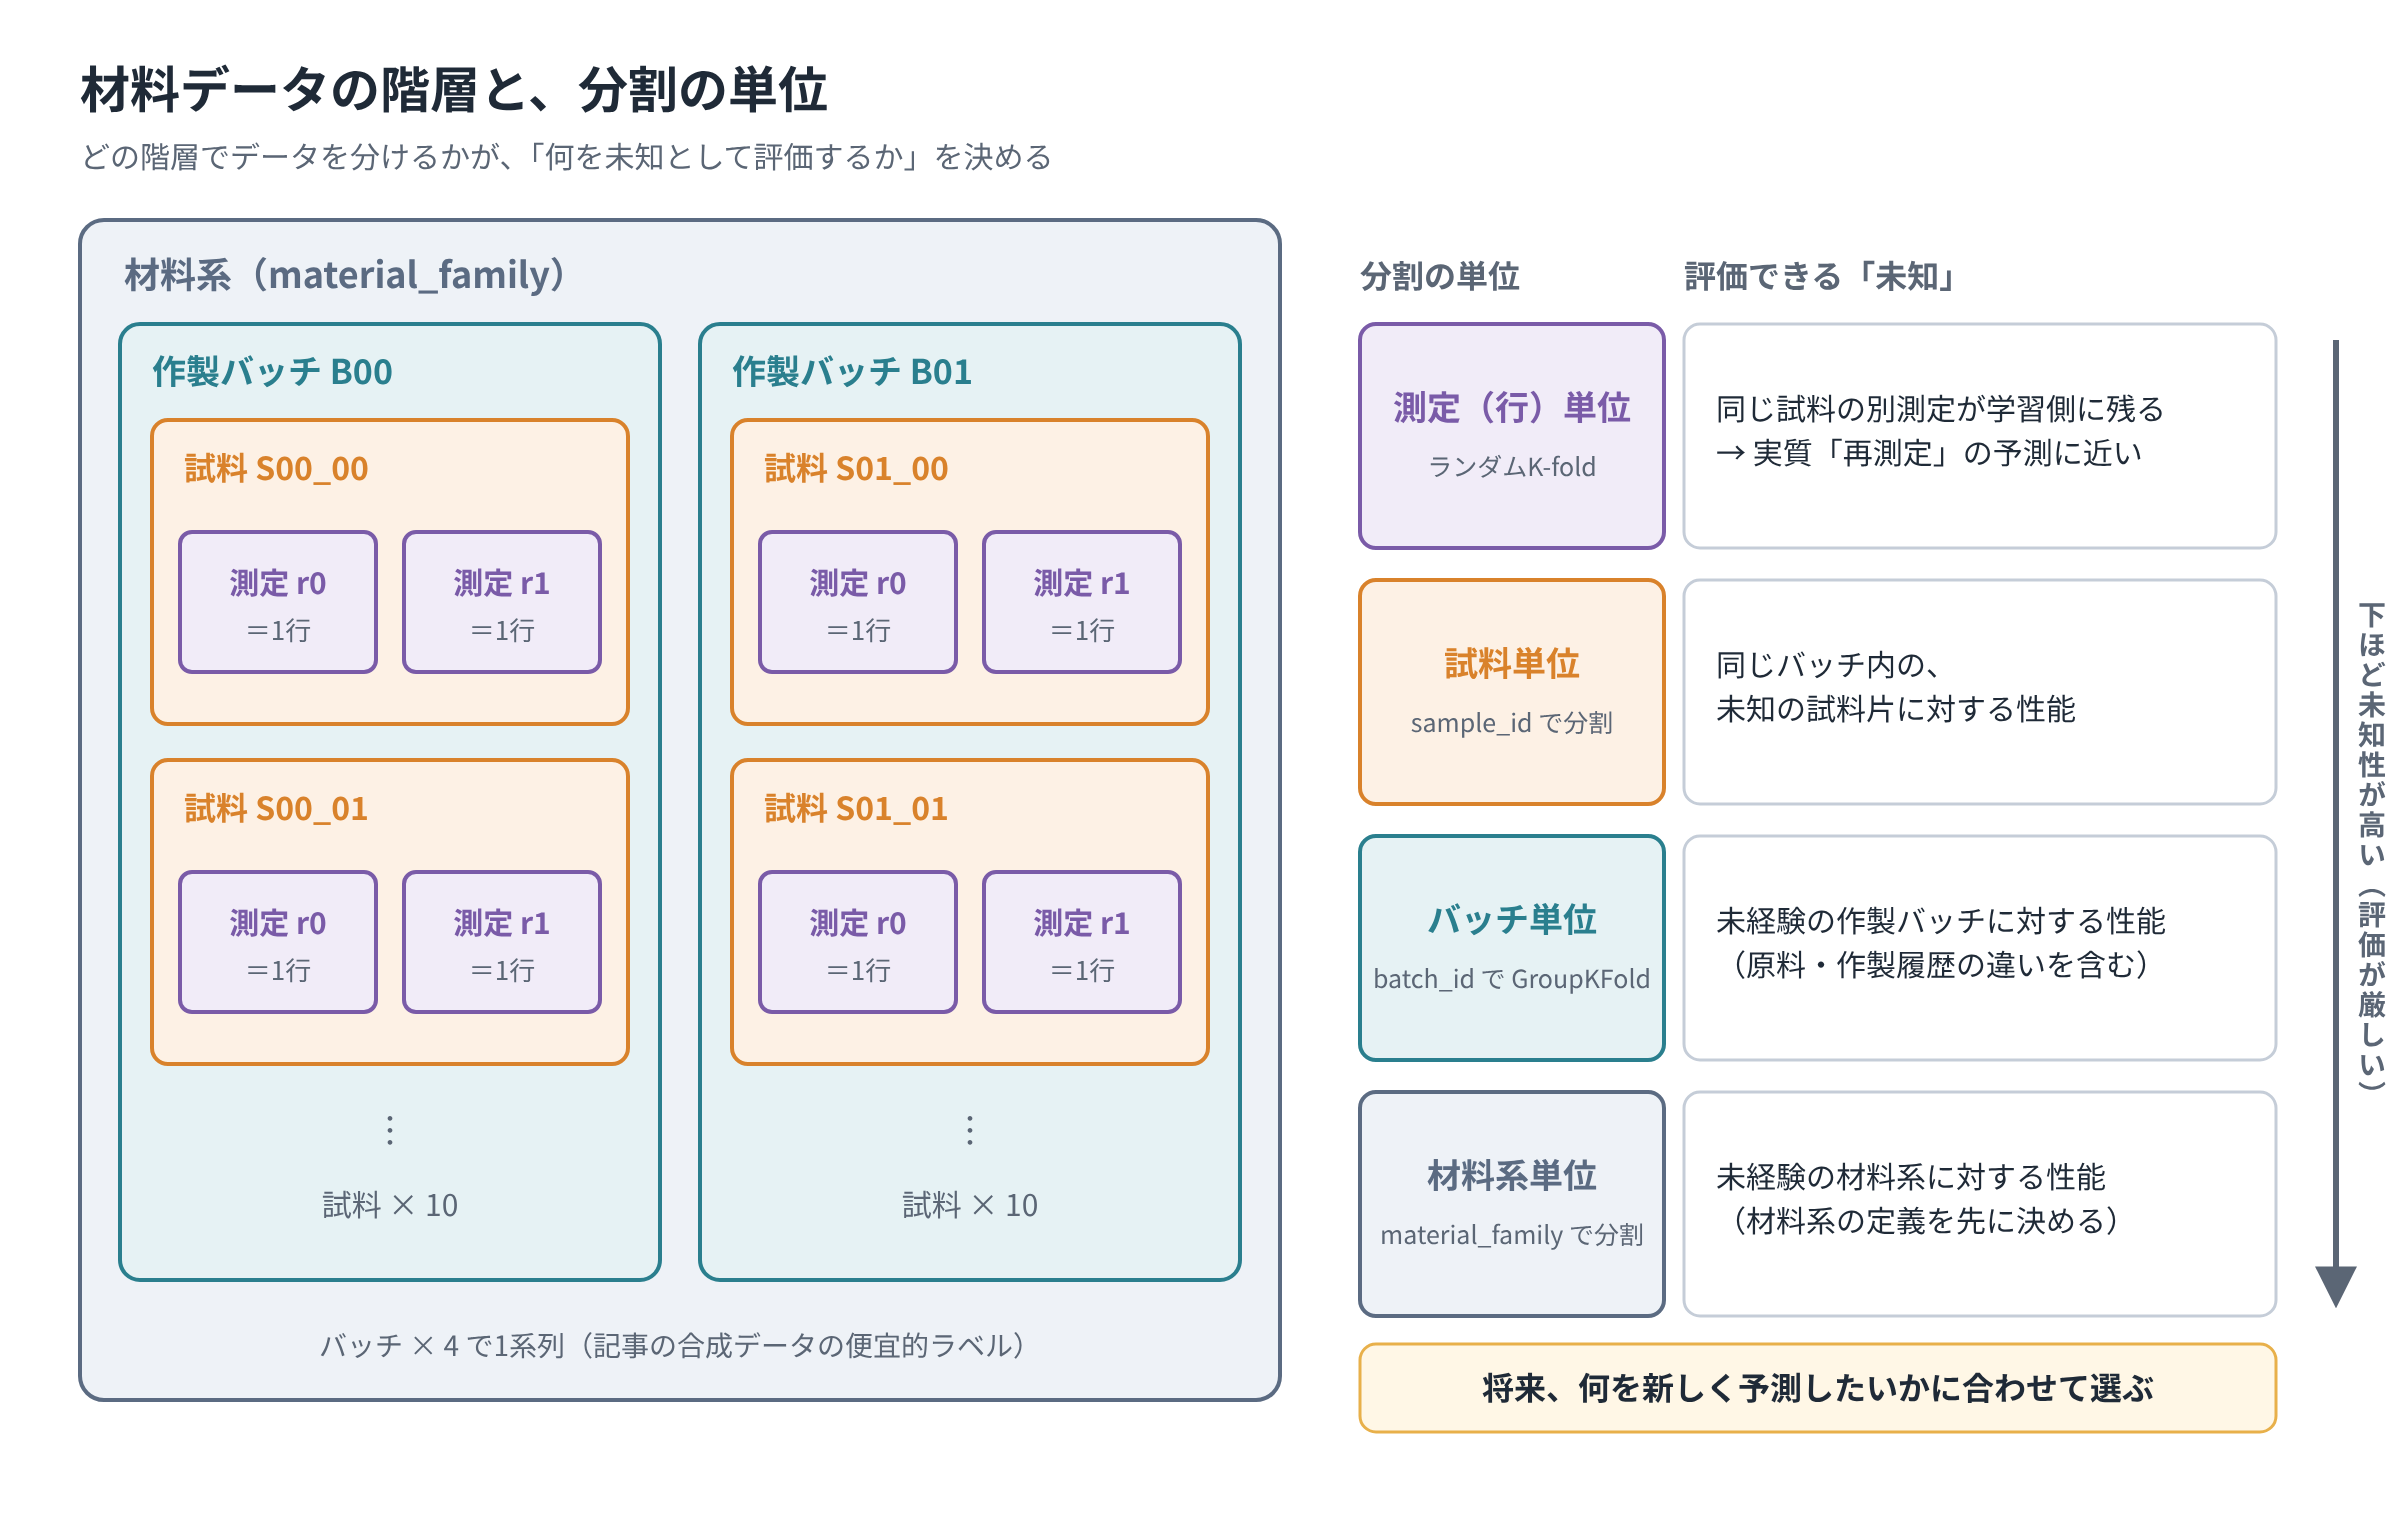
同じ分布の新規試料か、未経験のバッチか
ランダムK-foldは行をランダムに分けます。独立した試料が同じ分布から得られ、将来の使用場面も同じと考えられるなら候補になります。ただし、同じ試料の測定を複数行にした場合、その行同士は独立した試料ではありません。
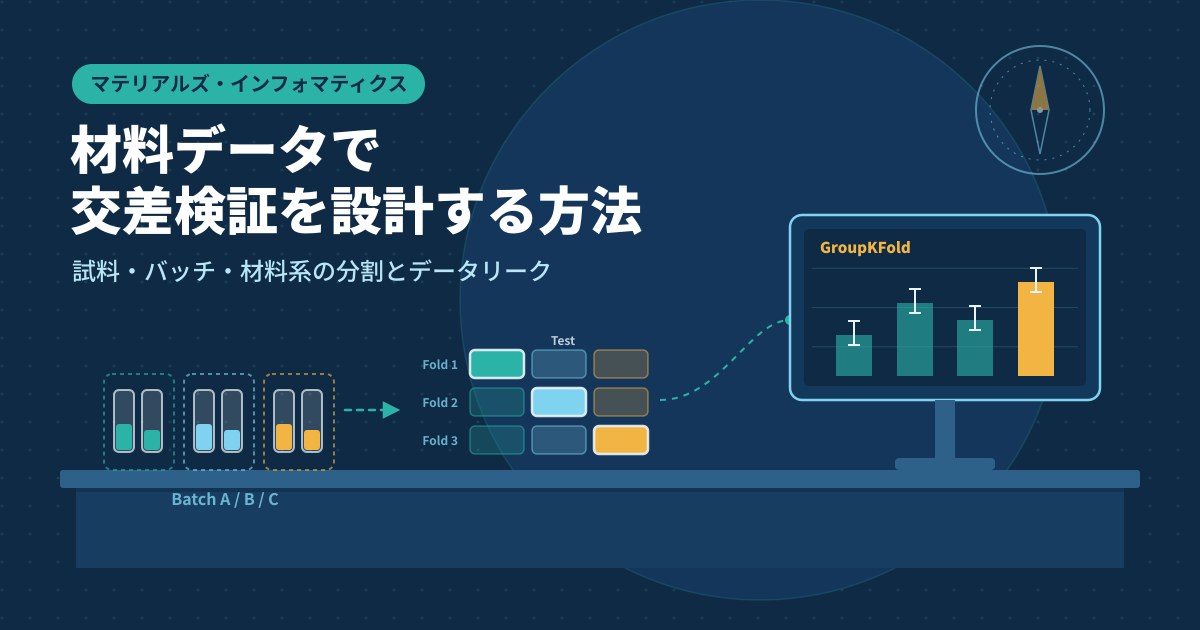
GroupKFoldはグループ単位で分け、各foldの学習側と評価側へ同じグループを入れません。例えばbatch_idを使えば、未経験のバッチに対する評価を組み立てられます。異なるグループの数は分割数以上必要です。[1]
| 将来の予測対象 | 分割候補 | 点検する内容 |
|---|---|---|
| 独立した同一分布の新規試料 | ランダムK-fold | 関連試料や繰り返し測定の混入 |
| 同じ材料系の別試料 | 試料単位のグループ分割 | 同一試料の記録が両側に入らないか |
| 未経験の作製バッチ | バッチ単位のGroupKFold | 共有する原料・作製履歴が残らないか |
| 未経験の材料系 | 材料系単位の分割 | 材料系の定義と対象範囲 |
| 将来の実験・生産 | 時間順の分割 | 未来の情報や同じバッチの混入 |
例えば同じ粉末バッチを複数片に分けて測定する場合、sample_idだけで分けてもバッチの情報は両側に残ります。別バッチへの性能を知りたいなら、より上位のバッチ単位を使います。反対に、同一バッチ内での予測が目的なら、その目的を明示して評価します。
未経験の材料系と時間順の評価
材料系を分ける場合は、化学組成、構造、合成経路など、何を共通性の基準とするかを先に決めます。スコアが高くなるように後から定義を変えると、評価の意味が曖昧になります。GroupKFoldはラベルを守る仕組みであり、科学的に妥当な材料系を自動で見つける機能ではありません。
将来の製造データを予測するなら、過去で学習して後の期間で評価します。時刻が並んでいても、同じバッチが境界をまたぐ場合には追加の整理が必要です。本記事の実行コードはグループ分割が中心で、時間順の分割は判断基準までを扱います。
分割による性能評価と、個々の予測対象が学習データに近いかを判断するADは役割が異なります。モデルの適用範囲(AD)の設定・検証方法と組み合わせて判断します。
3.材料データで起こるデータリーク
関連する記録が混ざる
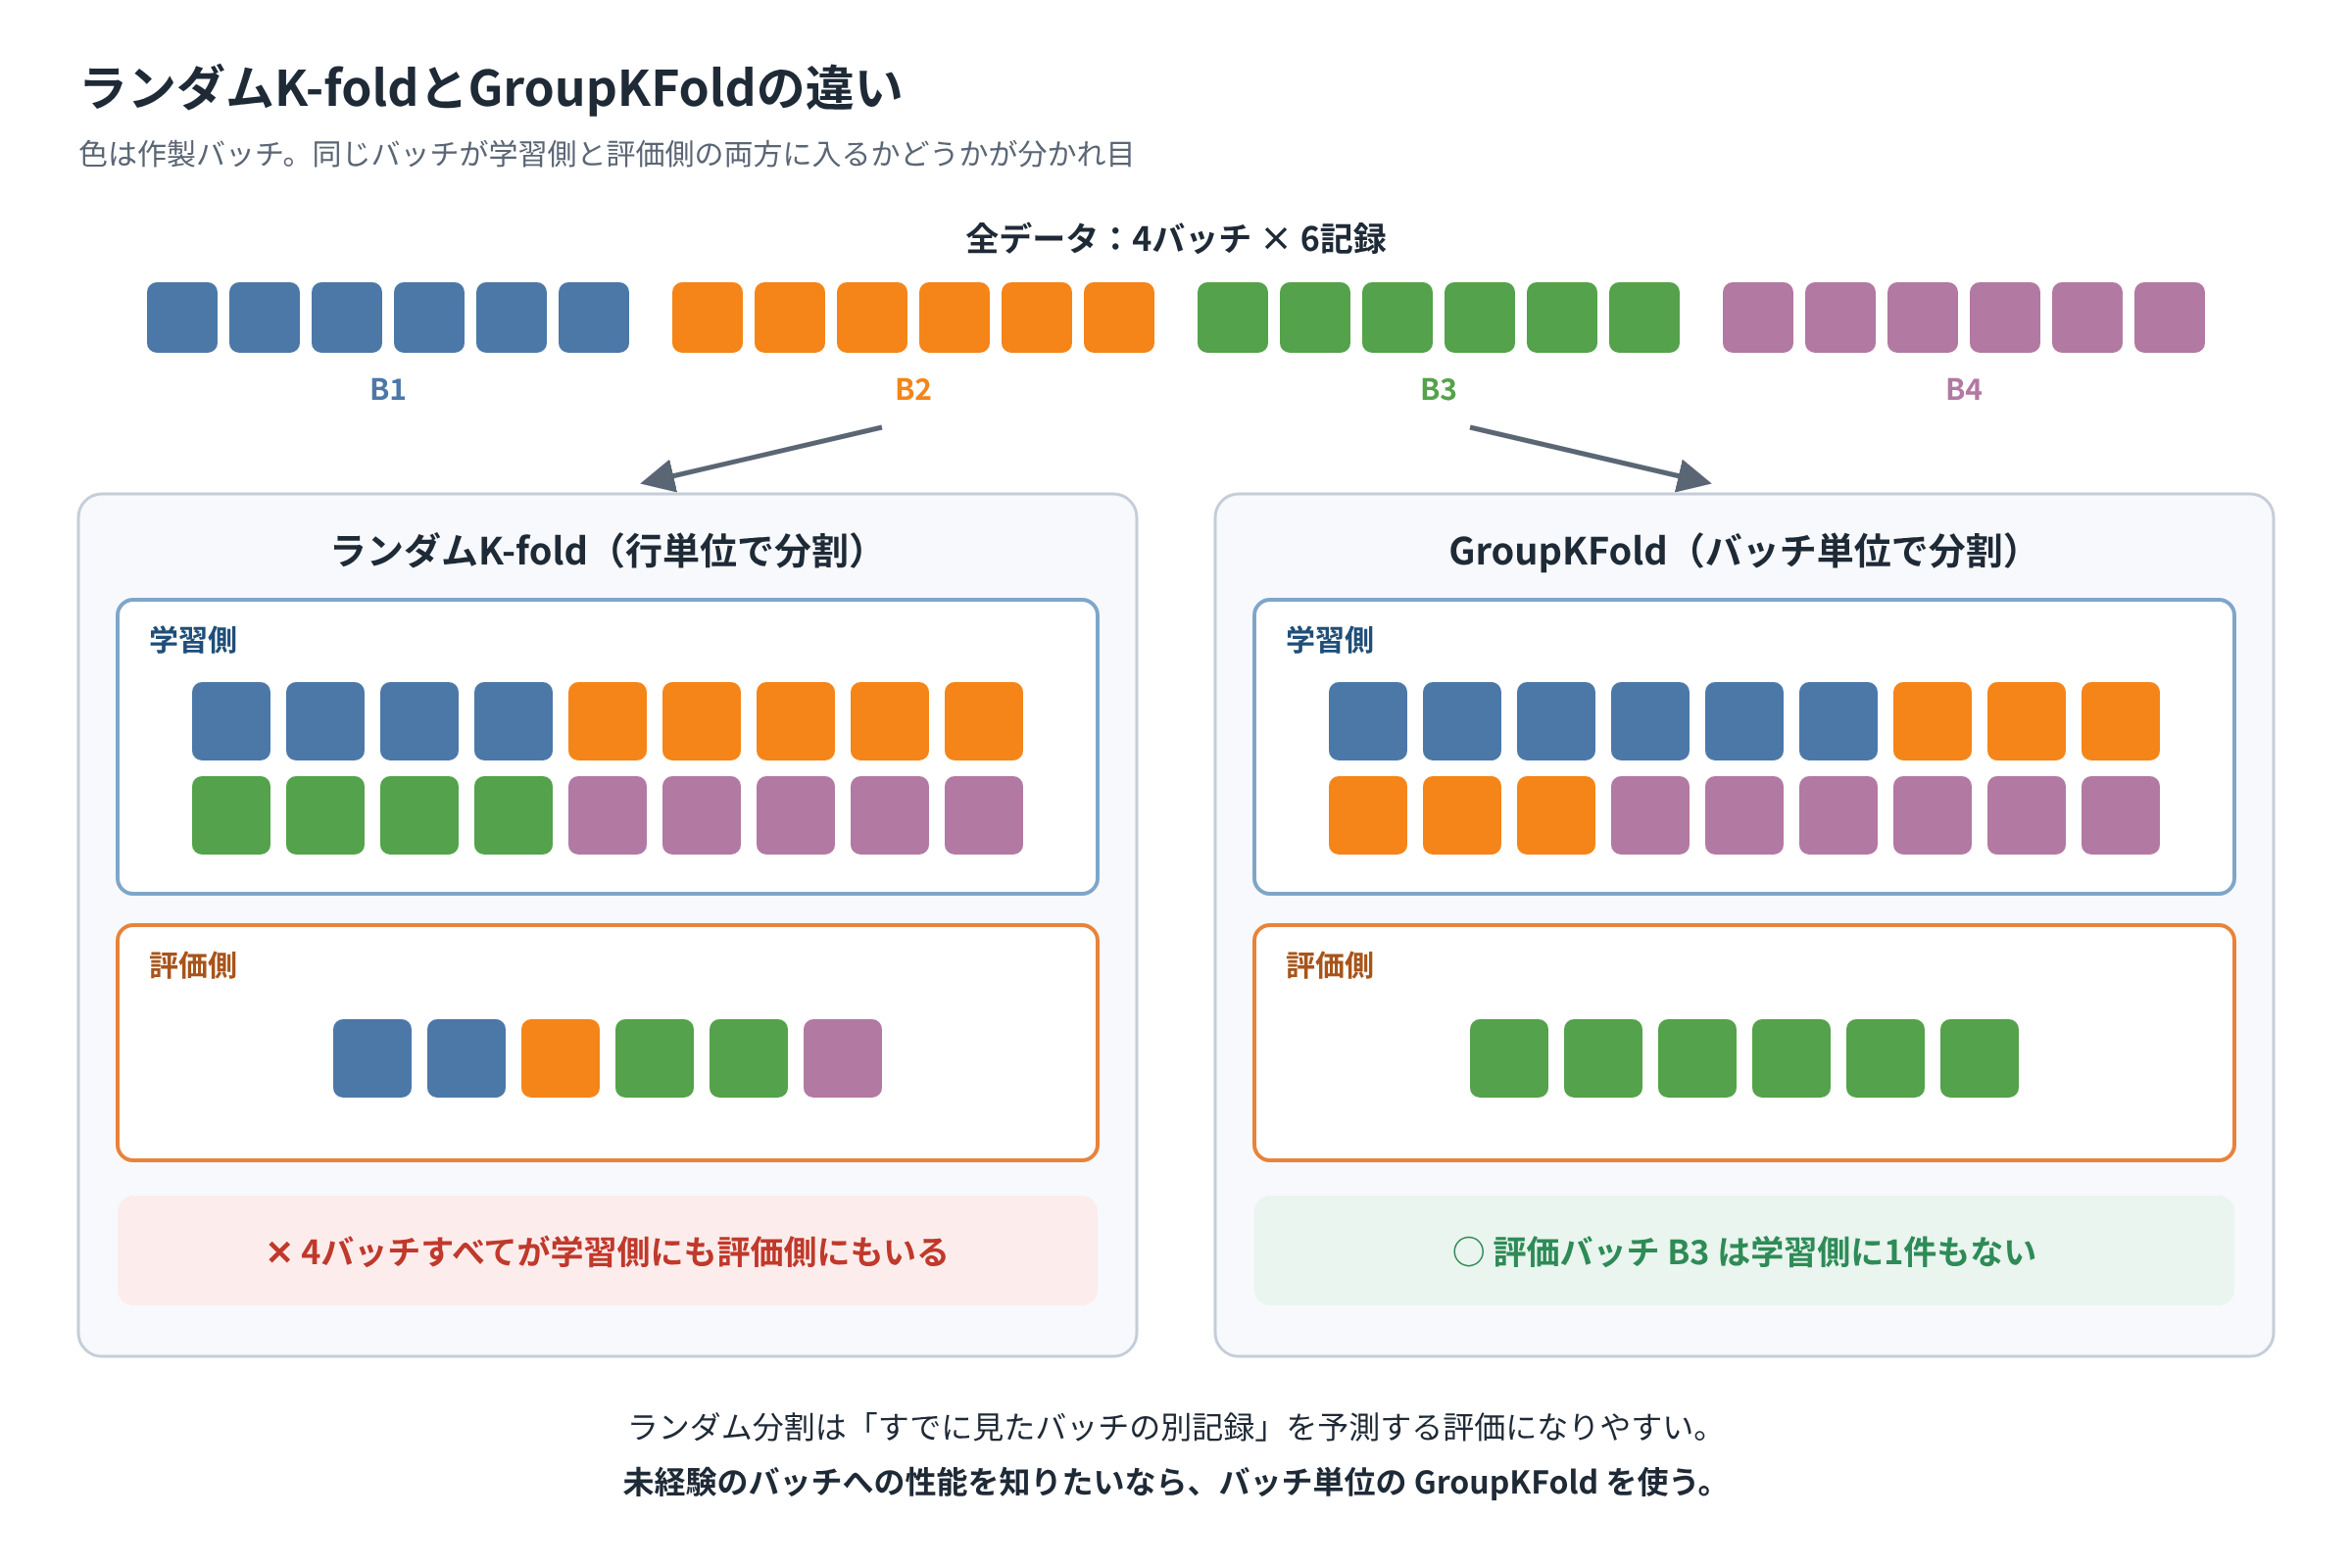
薄膜片S001を二回測った記録を両側に分けると、未知の薄膜片への予測より簡単な評価になり得ます。同じセラミックス作製バッチの試料を分けた場合にも、原料や温度履歴を共有している可能性があります。ここでの例は編集部の仮想例です。
ただし、同じ材料系列が両側に存在するだけで、すべての目的に対するデータリークと断定するのは適切ではありません。同じ系列内の新規試料を予測する目的なら、その評価が必要なこともあります。想定より近い情報が混ざり、意図した未知性を評価できていないかが判断のポイントです。
前処理で評価側の情報を使う
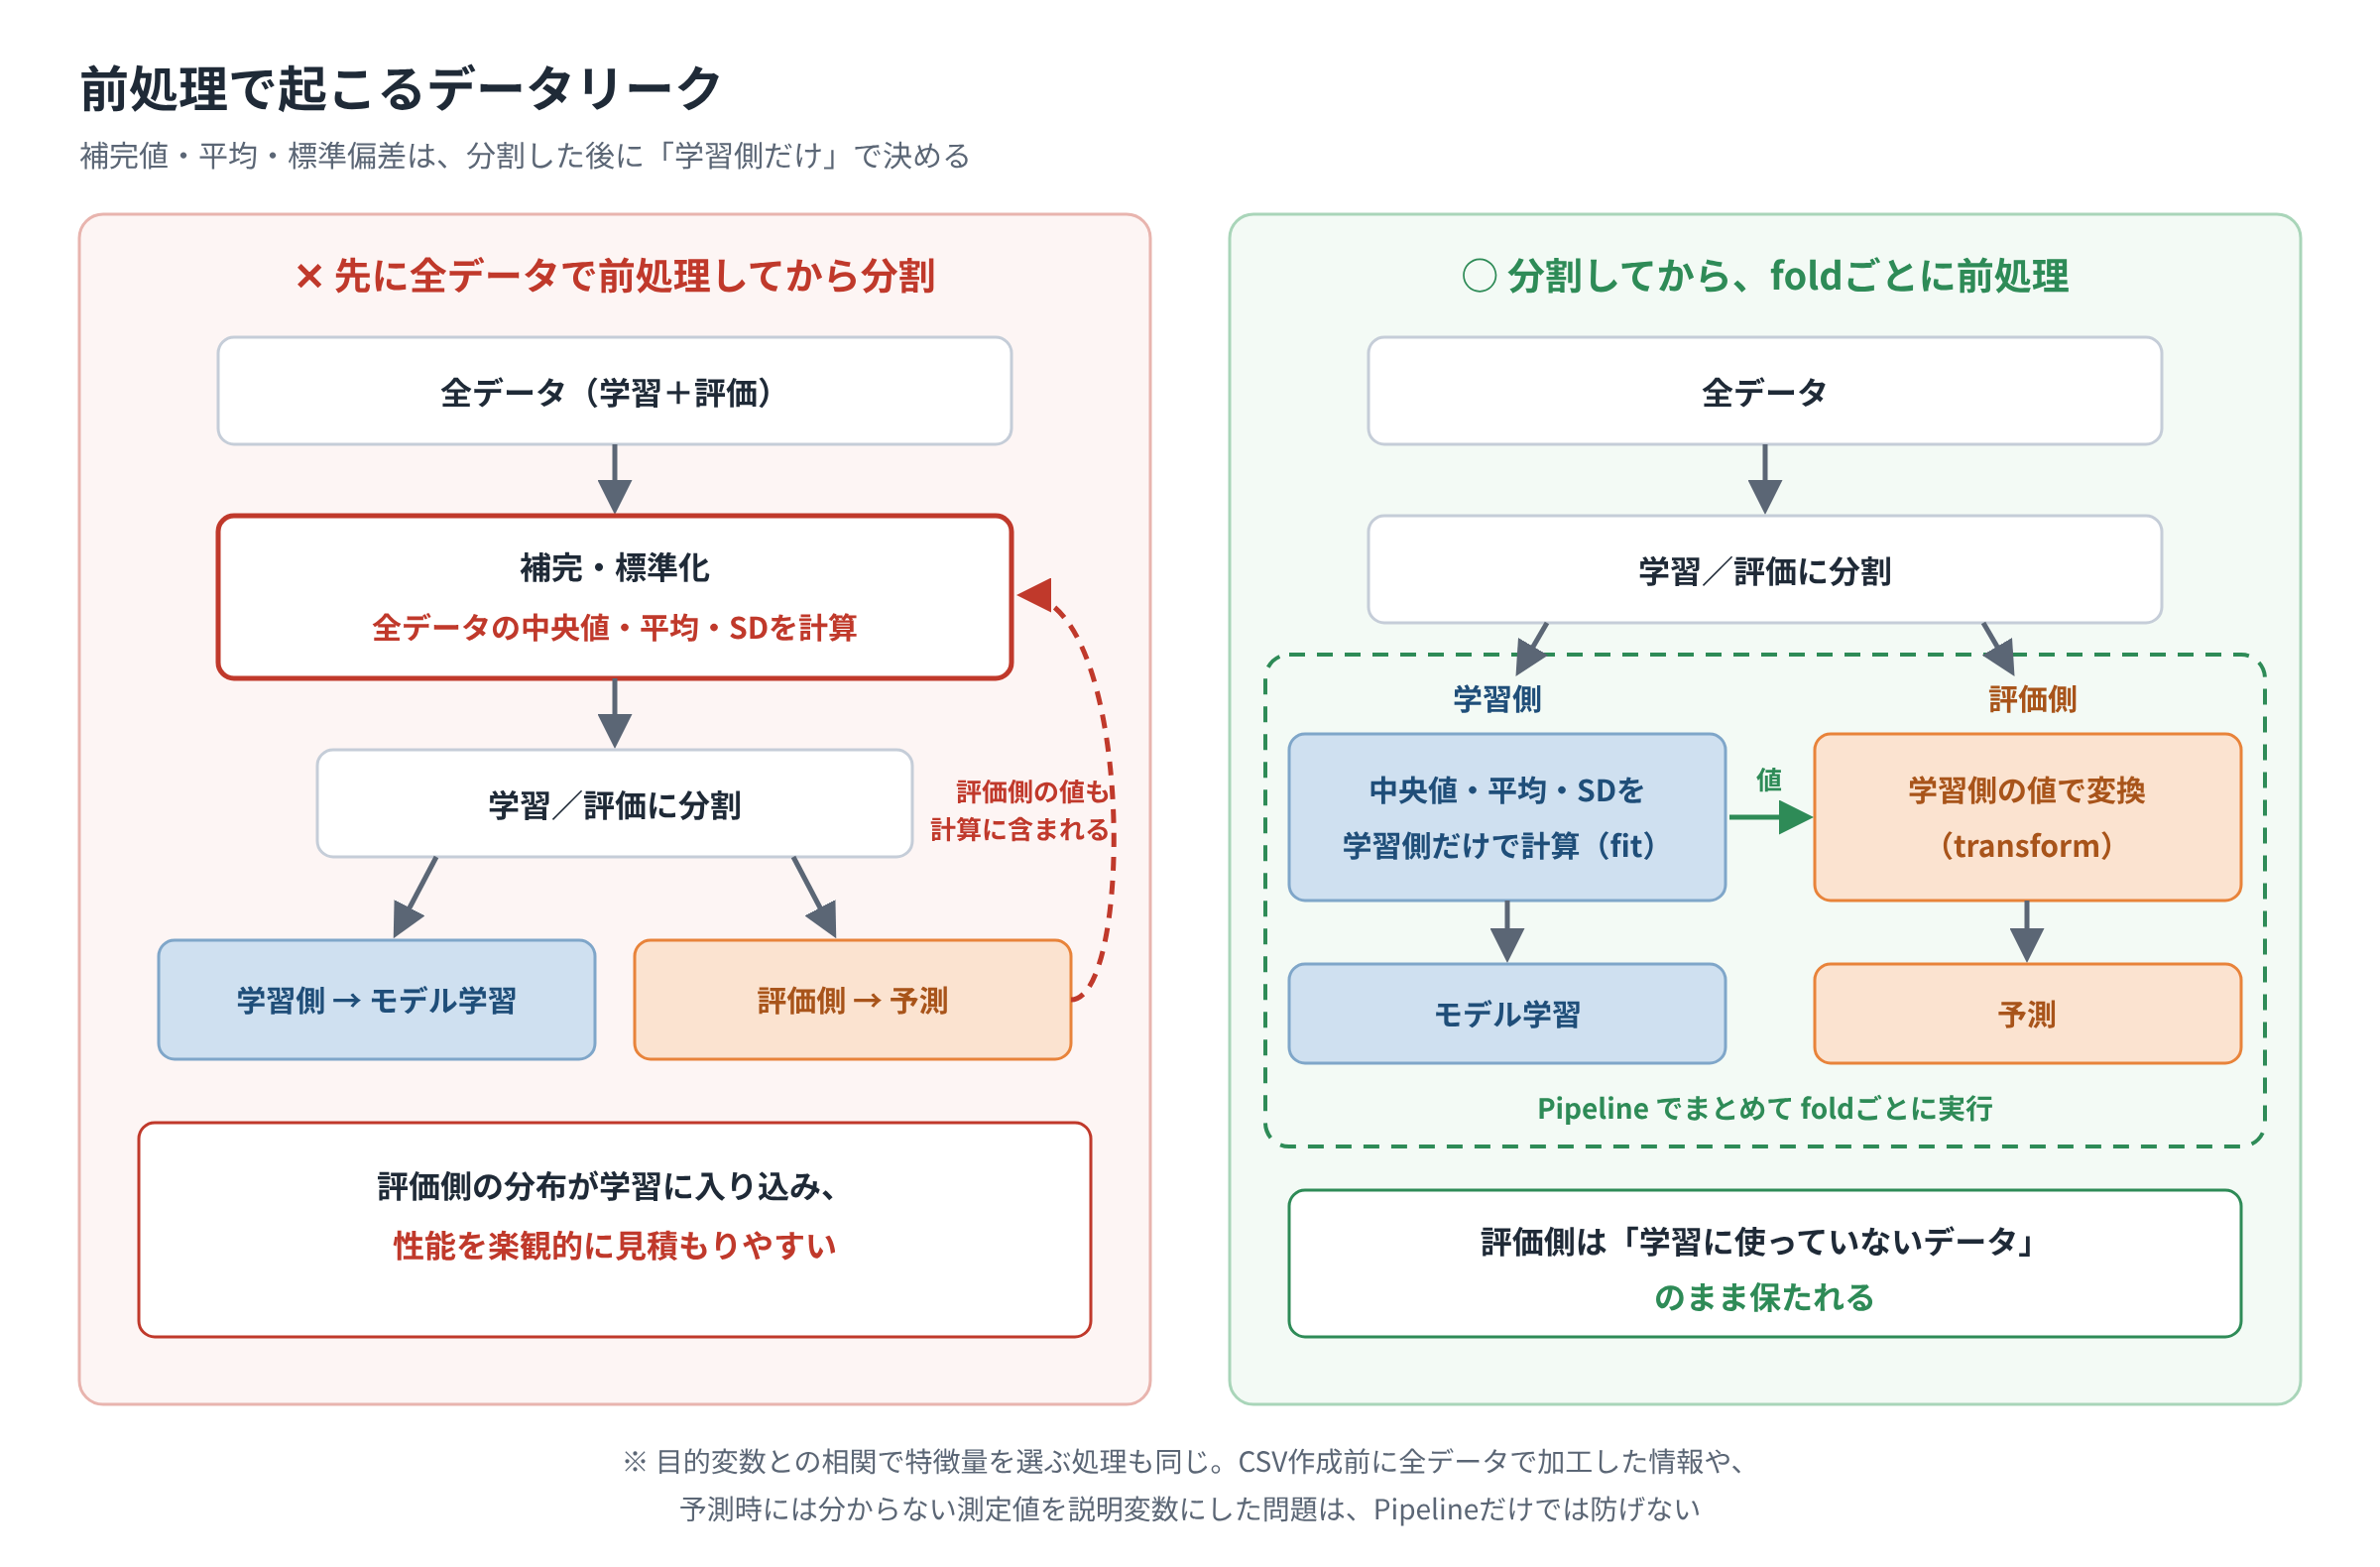
全データの平均や中央値で補完・標準化してから分割すると、評価側の分布を学習側へ持ち込んでしまいます。目的変数との相関で特徴量を選び、その後に交差検証する場合は、評価側の目的変数も選択に使われています。
補完値、標準化の平均・標準偏差、学習を伴う特徴量選択は、各foldの学習側で決めます。Pipelineは、この処理をモデルと一緒に実行する助けになります。[2]ただし、CSVを作る前に全データで処理した情報や、予測時には分からない測定結果を説明変数にした問題は、Pipelineだけでは修正できません。
評価結果を見て判断を繰り返す
最終評価の点数を見て特徴量や分割を変更し続けると、その評価データも開発に使ったことになります。変更すること自体を禁止する必要はありませんが、変更後の評価を完全に独立した最終性能と呼ばないようにします。変更履歴を残し、新しい検証データや外側の評価を用意します。
4.CSVとPythonの環境を準備する
入力の単位と列
主教材は「一行=一回の測定」です。同じsample_idが二行あるのは繰り返し測定を表すためで、誤登録による重複とは区別します。
| 列 | 内容 | モデルへの入力 |
|---|---|---|
| sample_id | 物理的な試料のID | 入れない |
| batch_id | 作製バッチのID | 分割に使う |
| material_family | 仮想の系列ラベル | 分割変更の例に使う |
| repeat_id | 同じ試料の測定番号 | 入れない |
| composition_fraction | 仮想の組成比 | 説明変数 |
| temperature_c | 仮想の作製温度、℃ | 説明変数 |
| target | 仮想の特性値、MPa | 目的変数 |
試料IDを数値へ変換して説明変数に入れても、物理的な意味が生まれるわけではありません。予測時に取得でき、目的に対して妥当な特徴量を選びます。材料表現の考え方は、材料開発における特徴量設計で扱っています。
実行確認した環境
Python 3.12.14、NumPy 2.3.5、pandas 2.2.3、scikit-learn 1.8.0、Matplotlib 3.10.8で実行しました。既存環境との混在を避けたい場合は、新しい仮想環境やノートブック環境を用意します。
python -m pip install numpy==2.3.5 pandas==2.2.3 scikit-learn==1.8.0 matplotlib==3.10.8
コードをmaterials_cross_validation.pyという名前で保存し、保存したフォルダーで実行します。
python materials_cross_validation.py --output cv_results
同じ名前の出力ファイルは上書きされます。条件を変えて比較するときは、出力フォルダー名を変えてください。機密データを扱う場合は、組織で認められた実行環境と保存先を使います。
合成データの生成条件
12バッチ×10試料×2回の測定で240行を生成します。特性値は組成比・温度の線形関係に、バッチ固有のずれ、試料固有のずれ、測定ノイズを加えたものです。温度の12行に欠測を入れます。乱数seedは42です。
material_familyは4バッチずつをまとめた便宜的なラベルです。実在材料の化学的な系列や、系列間の外挿難度を再現していません。合成データは処理の確認用であり、実在材料への予測精度の証拠ではありません。
5.Pythonで分割・学習・評価・保存を実行する
Pipelineで前処理と回帰をまとめる
本教材では中央値による補完、標準化、Ridge回帰を使います。Ridge回帰は、係数が過度に大きくなることを抑える線形回帰です。alphaは抑制の強さを調整する設定で、基本比較では1.0に固定します。
まず同じモデルと特徴量のまま、行単位のランダムK-foldと、バッチ単位のGroupKFoldを比較します。モデルまで同時に変更すると、結果の違いが分割によるものか判断しにくいためです。
実行コード
以下はデータ生成、入力点検、三つの評価、CSV・図の保存を含む完全なスクリプトです。基本比較を先に読み、ネスト交差検証の処理は第7章で確認してください。
"""Educational synthetic materials regression; not measured material properties.
Run: python materials_cross_validation.py --output cv_results
Own CSV: add --csv my_data.csv --group batch_id
"""
import argparse
import json
from pathlib import Path
import platform

import matplotlib
matplotlib.use("Agg")
import matplotlib.pyplot as plt
import numpy as np
import pandas as pd
import sklearn
from sklearn.base import clone
from sklearn.impute import SimpleImputer
from sklearn.linear_model import Ridge
from sklearn.metrics import mean_absolute_error, mean_squared_error, r2_score
from sklearn.model_selection import GroupKFold, KFold, GridSearchCV
from sklearn.pipeline import make_pipeline
from sklearn.preprocessing import StandardScaler

FEATURES = ["composition_fraction", "temperature_c"]
TARGET = "target"
SEED = 42


def make_data():
    rng = np.random.default_rng(SEED)
    rows = []
    for b in range(12):
        offset = rng.normal(0, 6)
        for s in range(10):
            x, temp = rng.uniform(0.1, 0.9), rng.uniform(900, 1100)
            latent = 50 + 35 * x + 0.025 * (temp - 1000) + offset + rng.normal(0, 2)
            for r in range(2):
                rows.append([f"S{b:02d}_{s:02d}", f"B{b:02d}", f"F{b//4}",
                             r, x, temp, latent + rng.normal(0, 1)])
    df = pd.DataFrame(rows, columns=["sample_id", "batch_id", "material_family",
                                    "repeat_id", *FEATURES, TARGET])
    missing = rng.choice(len(df), 12, replace=False)
    df.loc[missing, "temperature_c"] = np.nan
    return df


def prepare(df, group):
    required = ["sample_id", group, *FEATURES, TARGET]
    absent = set(required) - set(df.columns)
    if absent:
        raise ValueError(f"Missing columns: {sorted(absent)}")
    if len(df) < 10 or df[required[:2]].isna().any().any():
        raise ValueError("Need >=10 rows and non-missing sample/group IDs")
    df = df.reset_index(drop=True).copy()
    for col in FEATURES + [TARGET]:
        df[col] = pd.to_numeric(df[col], errors="raise")
    if df[TARGET].isna().any() or not np.isfinite(df[TARGET]).all():
        raise ValueError("Target must be finite; do not impute targets")
    X = df[FEATURES].to_numpy(dtype=float)
    if np.isinf(X).any() or np.isnan(X).all(axis=0).any():
        raise ValueError("Infinite or entirely missing feature")
    g = df[group].astype(str).to_numpy()
    df["sample_id"] = df["sample_id"].astype(str)
    df[group] = g
    if df.groupby("sample_id")[group].nunique().max() > 1:
        raise ValueError("One sample belongs to multiple chosen groups; review grouping")
    return df, X, df[TARGET].to_numpy(dtype=float), g


def metrics(y, p):
    r2 = r2_score(y, p) if len(y) > 1 and np.var(y) > 0 else np.nan
    return {"MAE": mean_absolute_error(y, p),
            "RMSE": float(np.sqrt(mean_squared_error(y, p))), "R2": r2}


def evaluate(df, X, y, groups, splitter, name, out, nested=False, grouped=True):
    pipe = make_pipeline(SimpleImputer(strategy="median"), StandardScaler(), Ridge(alpha=1.0))
    pred = np.full(len(y), np.nan)
    fold_id = np.full(len(y), -1)
    audits, scores = [], []
    splits = list(splitter.split(X, y, groups)) if grouped else list(splitter.split(X, y))
    for k, (tr, te) in enumerate(splits):
        overlap = set(groups[tr]) & set(groups[te])
        sample_overlap = set(df.iloc[tr].sample_id) & set(df.iloc[te].sample_id)
        if grouped:
            assert not overlap and not sample_overlap
        if np.isnan(X[tr]).all(axis=0).any():
            raise ValueError(f"{name} fold {k}: entirely missing training feature")
        model = clone(pipe)
        alpha = 1.0
        if nested:
            n_inner = min(3, len(np.unique(groups[tr])))
            if n_inner < 2:
                raise ValueError("Not enough training groups for inner CV")
            inner = list(GroupKFold(n_splits=n_inner).split(X[tr], y[tr], groups[tr]))
            for a, b in inner:
                assert not (set(groups[tr][a]) & set(groups[tr][b]))
                if np.isnan(X[tr][a]).all(axis=0).any():
                    raise ValueError("Entirely missing feature in inner training fold")
            model = GridSearchCV(model, {"ridge__alpha": [0.1, 1.0, 10.0, 100.0]},
                                 cv=inner, scoring="neg_mean_absolute_error", error_score="raise")
            model.fit(X[tr], y[tr])
            alpha = float(model.best_params_["ridge__alpha"])
        else:
            model.fit(X[tr], y[tr])
        p = model.predict(X[te])
        assert np.all(fold_id[te] == -1)
        pred[te], fold_id[te] = p, k
        audits.append({"fold": k, "train_rows": len(tr), "test_rows": len(te),
                       "train_groups": len(np.unique(groups[tr])), "test_groups": len(np.unique(groups[te])),
                       "overlap_groups": len(overlap), "overlap_samples": len(sample_overlap),
                       "selected_alpha": alpha})
        scores.append({"fold": k, **metrics(y[te], p)})
    assert np.all(fold_id >= 0) and np.isfinite(pred).all()
    result = df.copy()
    result["group_for_cv"], result["fold"] = groups, fold_id
    result["predicted"], result["abs_error"] = pred, np.abs(y - pred)
    result.to_csv(out / f"{name}_predictions.csv", index=False)
    pd.DataFrame(audits).to_csv(out / f"{name}_audit.csv", index=False)
    pd.DataFrame(scores).to_csv(out / f"{name}_fold_metrics.csv", index=False)
    by_group = result.groupby("group_for_cv").agg(rows=("abs_error", "size"), MAE=("abs_error", "mean"))
    by_group.to_csv(out / f"{name}_group_errors.csv")
    return result, {"method": name, **metrics(y, pred), "group_macro_MAE": float(by_group.MAE.mean())}


def main():
    ap = argparse.ArgumentParser()
    ap.add_argument("--csv")
    ap.add_argument("--group", default="batch_id")
    ap.add_argument("--output", default="cv_results")
    args = ap.parse_args()
    out = Path(args.output)
    out.mkdir(parents=True, exist_ok=True)
    raw = pd.read_csv(args.csv) if args.csv else make_data()
    df, X, y, g = prepare(raw, args.group)
    df.to_csv(out / "input_data.csv", index=False)
    n = min(5, len(np.unique(g)))
    if n < 2:
        raise ValueError("Need >=2 groups; nested CV normally requires >=3 groups")
    configs = [("random", KFold(n_splits=n, shuffle=True, random_state=SEED), False, False),
               ("group", GroupKFold(n_splits=n), False, True),
               ("nested_group", GroupKFold(n_splits=n), True, True)]
    results, summaries = {}, []
    for name, split, nested, grouped in configs:
        results[name], summary = evaluate(df, X, y, g, split, name, out, nested, grouped)
        summaries.append(summary)
    table = pd.DataFrame(summaries)
    table.to_csv(out / "summary.csv", index=False)
    print(table.round(4).to_string(index=False))
    fig, axes = plt.subplots(1, 3, figsize=(12, 4), sharex=True, sharey=True)
    low = min(y.min(), *(v.predicted.min() for v in results.values()))
    high = max(y.max(), *(v.predicted.max() for v in results.values()))
    for ax, (name, res) in zip(axes, results.items()):
        ax.scatter(res[TARGET], res.predicted, c=res.fold, cmap="viridis", s=12, alpha=.7)
        ax.plot([low, high], [low, high], "k--", lw=1)
        ax.set(title=name, xlabel="Observed target (synthetic MPa)")
    axes[0].set_ylabel("OOF predicted target (synthetic MPa)")
    fig.tight_layout()
    fig.savefig(out / "oof_predictions.png", dpi=160)
    plt.close(fig)
    fig, ax = plt.subplots(figsize=(8, 4))
    for name, res in results.items():
        e = res.groupby("group_for_cv").abs_error.mean()
        ax.plot(e.index, e.values, marker="o", label=name)
    ax.set(xlabel="Group ID", ylabel="MAE (synthetic MPa)")
    ax.legend()
    fig.tight_layout()
    fig.savefig(out / "group_mae.png", dpi=160)
    plt.close(fig)
    versions = {"python": platform.python_version(), "numpy": np.__version__,
                "pandas": pd.__version__, "sklearn": sklearn.__version__,
                "matplotlib": matplotlib.__version__, "seed": SEED,
                "features": FEATURES, "target": TARGET, "group": args.group}
    (out / "versions.json").write_text(json.dumps(versions, indent=2), encoding="utf-8")


if __name__ == "__main__":
    main()
コードが点検すること
選んだグループとsample_idが欠測していないこと、目的変数が有限な数値であること、説明変数が数値であることを確認します。目的変数の欠測を補完して学習には使いません。前処理に回す説明変数の欠測とは区別します。
グループ分割では、学習側と評価側に共通するグループ・試料がないことをassertで確認します。同じ試料が選んだ複数グループにまたがる場合も停止します。ただし、IDの付け方自体が間違っている場合には、コードだけで科学的な同一性を判定できません。材料データの品質を高める方法も併せて確認してください。
各行が評価側で一回だけ予測され、予測値がすべて有限であることも点検します。説明変数の列全体が欠測している場合や、学習fold内で列が全欠測になる場合は、結果を黙って出すのではなく停止します。
保存されるファイル
| ファイル | 確認する内容 |
|---|---|
| input_data.csv | 実際に評価に使ったデータ |
| summary.csv | 全OOF予測による指標、グループを等重みで見たMAE |
| 各方式のpredictions.csv | 実測値、予測値、fold、グループ、絶対誤差 |
| 各方式のaudit.csv | 件数、グループ数、重複数、選択したalpha |
| 各方式のfold_metrics.csv | foldごとのMAE・RMSE・R² |
| 各方式のgroup_errors.csv | グループ別の件数とMAE |
| oof_predictions.png、group_mae.png | 予測とグループ別誤差の図 |
| versions.json | 実行環境、乱数seed、列とグループの設定 |
6.実行結果をどう読むか
MAE・RMSE・R²の意味
MAEは絶対誤差の平均です。実測値が10・20、予測値が12・17なら、絶対誤差は2・3、MAEは2.5です。RMSEは誤差を二乗して平均し、平方根を取った値で、この例では√6.5、約2.55になります。大きな誤差の影響を受けやすい点がMAEとの違いです。
R²は、実測値の平均からのばらつきに対して予測誤差がどれくらい小さいかを表します。上の例では1−13/50=0.74です。負の値になることもあり、評価対象のばらつきが小さいと不安定になります。実測値が一定、または評価記録が一件だけの部分では、本コードはR²を欠測として扱います。
今回の実行結果
| 評価方式 | 全OOF MAE(仮想MPa) | 全OOF RMSE(仮想MPa) | 全OOF R² |
|---|---|---|---|
| ランダムK-fold | 4.3723 | 5.5704 | 0.7181 |
| バッチGroupKFold | 4.4046 | 5.7725 | 0.6973 |
| ネスト・バッチGroupKFold | 4.4013 | 5.7832 | 0.6962 |
2026年10月7日の上記環境・seedで得た、合成データの計算結果です。丸め前の値はsummary.csvに保存されます。foldごとの指標の単純平均ではなく、240行のOOF予測をまとめて計算した数字です。

図1:横軸は仮想の実測値、縦軸はOOF予測値。破線は両者が一致する位置です。色は各方式の評価foldを示し、方式間で同じ色が同じグループを表すわけではありません。図の軸ラベルは表示の互換性のため英語にしています。
ランダム分割の五つのfoldでは、両側に共通する試料が34〜46個、バッチは毎回12個ありました。バッチ分割では試料・バッチの重複がすべてゼロでした。今回、誤差差は小さく、グループ分割で大幅に悪化したという結果ではありません。
線形モデルが入力特徴量から試料固有のノイズを細かく覚えられるとは限らないため、関連記録の混入があっても、指標に大きな差が出ないことがあります。モデルの柔軟性やグループの特徴、データ量で結果は変わります。点数が近いことは、分割の妥当性が同じことの証明にはなりません。
fold別・グループ別の誤差を確認する

図2:横軸はバッチID、縦軸は各バッチのMAEです。平均値だけでなく、特定のバッチで誤差が大きくないか確認します。この図も合成データの結果です。
全行のMAEでは測定数が多いバッチの影響が大きくなります。group_macro_MAEは、各グループのMAEを等重みで平均した値です。今回は各バッチが20行ずつなので両者が一致しますが、実データの件数が異なれば一致しません。繰り返し測定が多い試料の影響も考え、試料単位の集約や重み付けが必要かを判断します。
fold間の標準偏差を計算しても、それをそのまま将来性能の信頼区間とは呼べません。foldは学習データを共有し、独立した実験の繰り返しではないためです。分布の確認には役立ちますが、不確かさの評価は別に設計します。
7.調整するなら、モデル選択と評価を分ける
ネスト交差検証の内側と外側
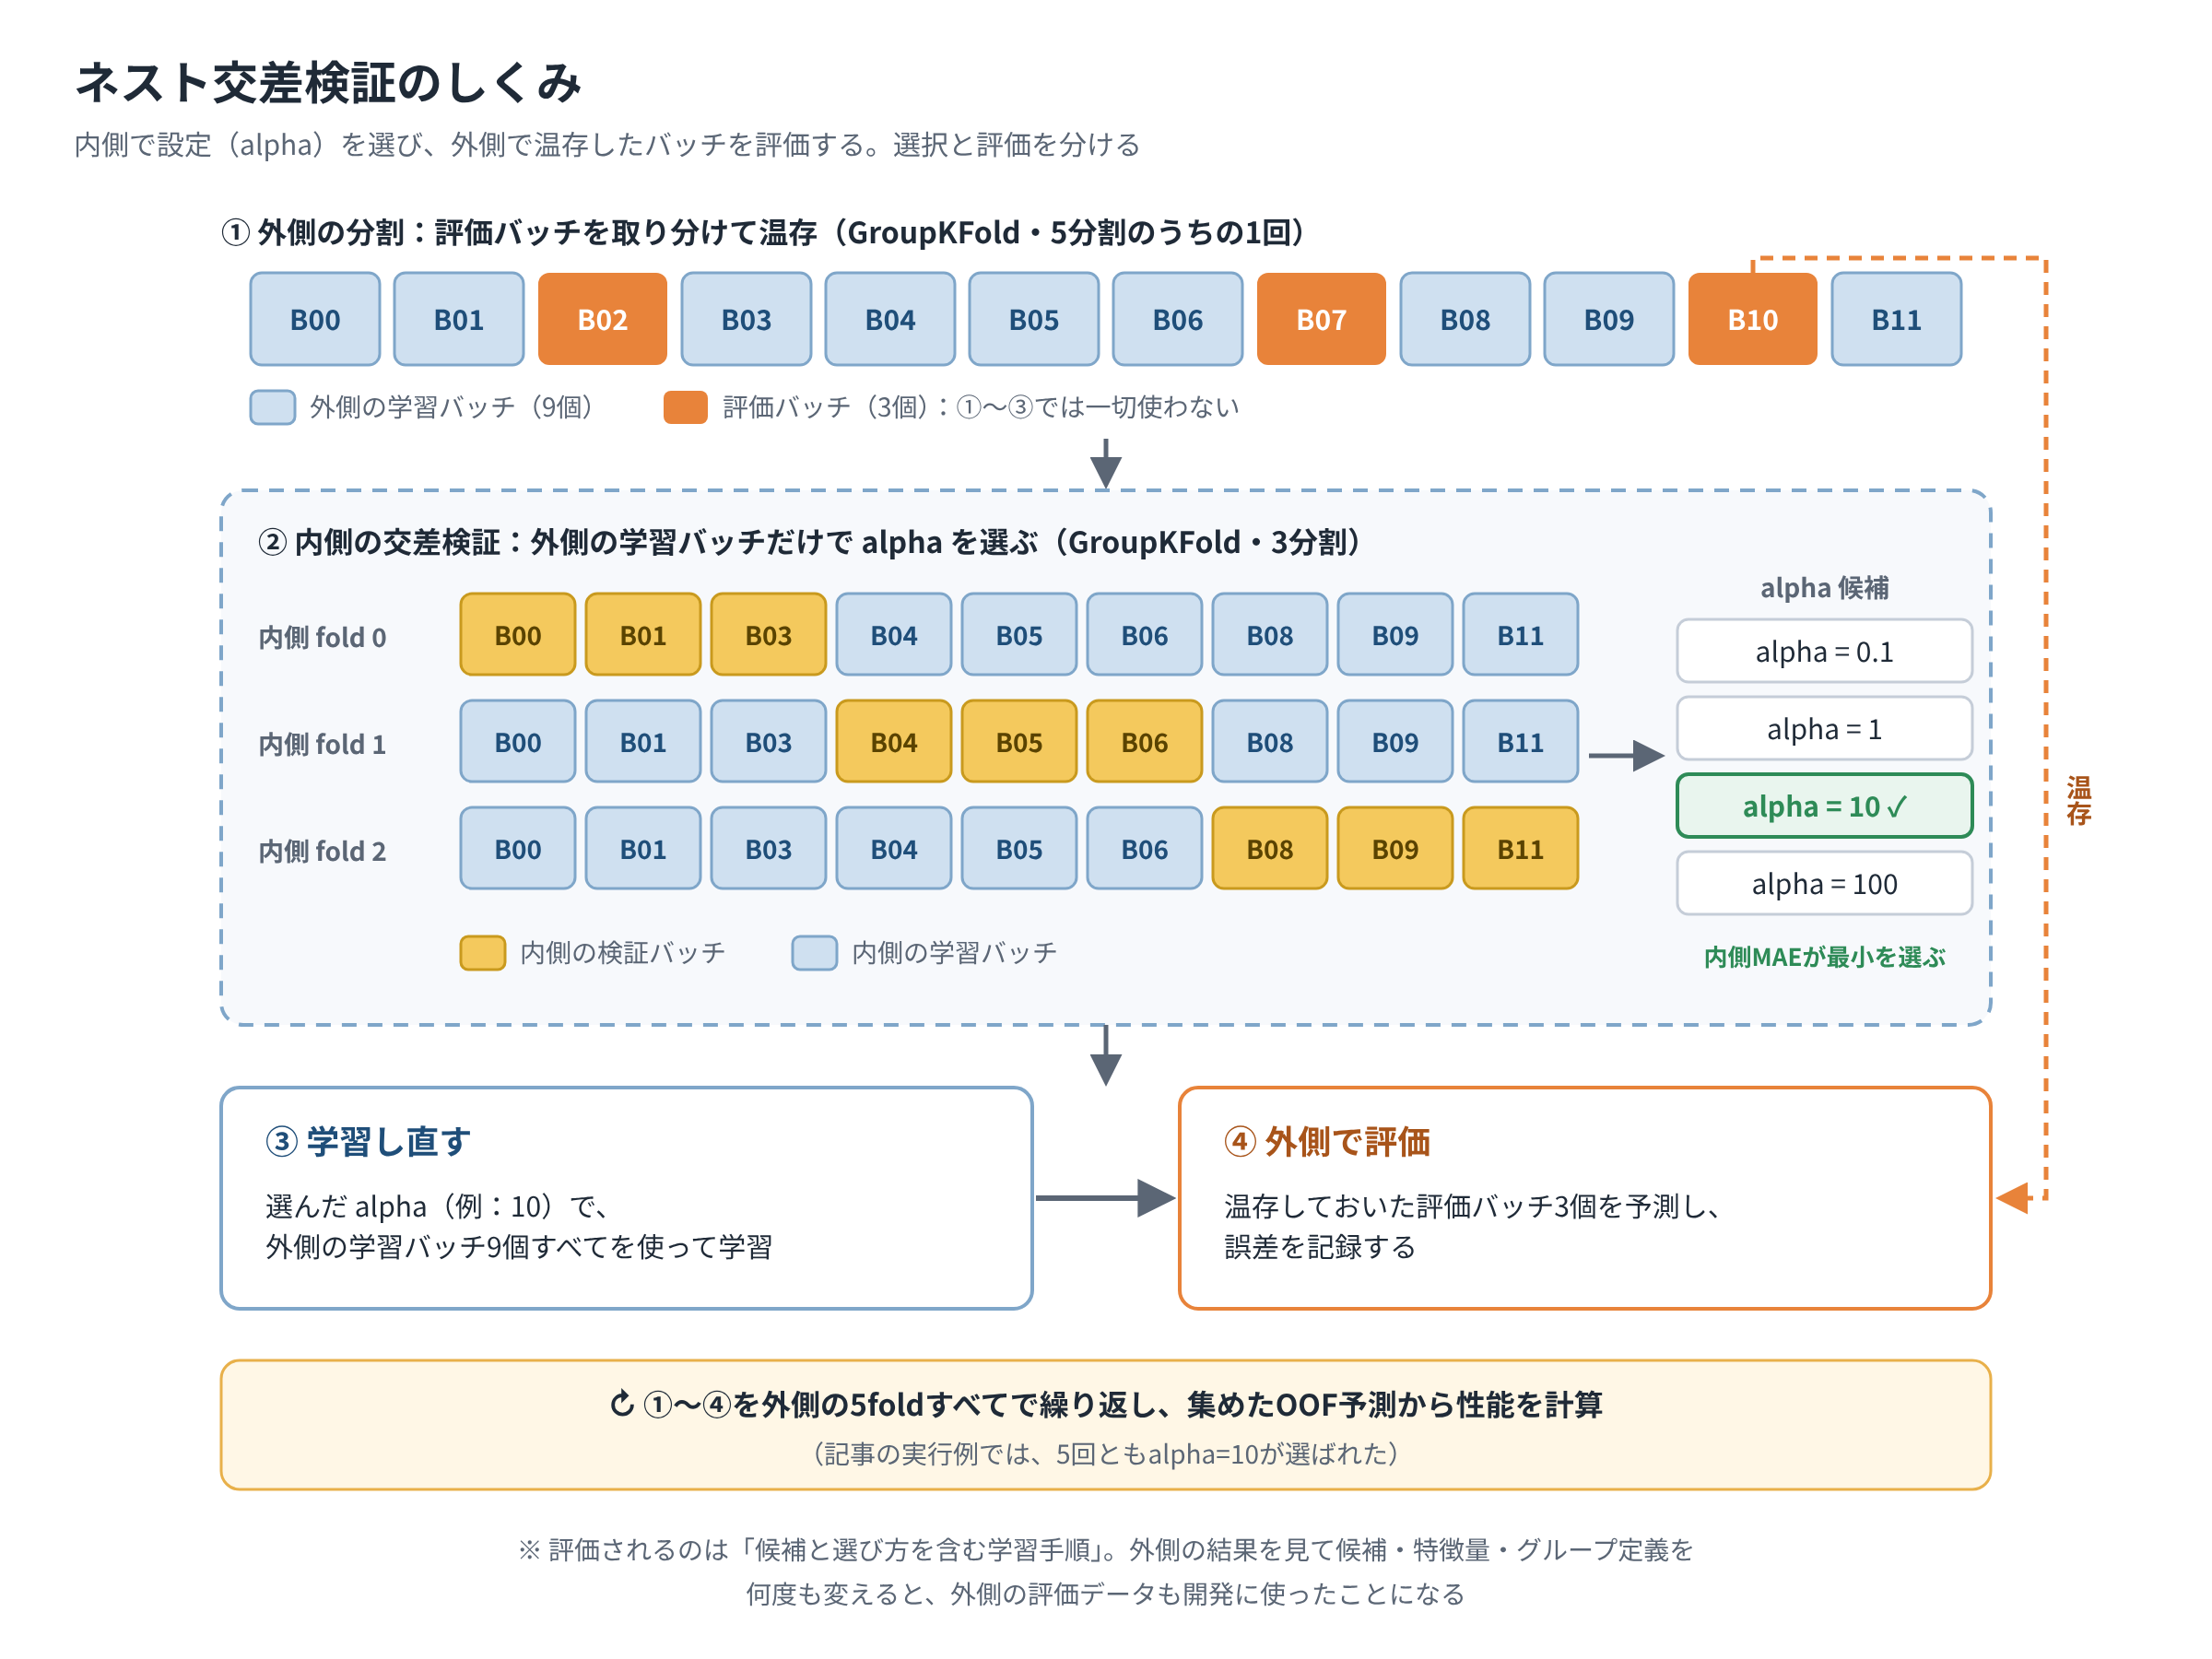
ネスト交差検証では、外側で評価用グループを取り分け、残った学習データの中だけで内側の交差検証を行います。内側で設定を選び、選んだ設定で外側の学習データを学習し直して、外側の評価データを予測します。この仕組みは公式の実装例でも示されています。[3]
| 段階 | 使用するデータ | 作業 |
|---|---|---|
| 外側の分割 | 全データ | 評価バッチを温存 |
| 内側の選択 | 外側の学習バッチのみ | alpha候補を交差検証で比較 |
| 学習し直す | 外側の学習バッチ全体 | 選んだalphaで学習 |
| 外側の評価 | 温存した評価バッチ | 予測し、誤差を記録 |
本コードではalpha=0.1、1、10、100を内側のMAEで比較します。内側の分割もGroupKFoldにし、グループ重複がないことを点検します。GridSearchCVへ内側の分割インデックスを渡しているので、グループ情報の受け渡しが見えやすい構成です。
今回の調整結果と注意点
五つの外側foldで選ばれたalphaはすべて10でした。ただし、基本のalpha=1と比べたMAE改善は小さく、RMSE・R²はわずかに異なる方向へ変化しています。この結果を、調整すれば必ずよくなる証拠とは扱いません。
ネスト交差検証が評価するのは、指定した候補と選択手順を含む学習プロセスです。外側の結果を見て候補、特徴量、グループの定義を何度も変えれば、外側も開発に使ったことになります。事前に決めた判断基準と変更履歴を残してください。
基本比較の固定alphaの結果と、設定選択を含む結果は、評価する手順が異なります。最終的に全データでモデルを作る場合でも、その学習済みモデルの将来性能を保証する数字として過大解釈しないことが必要です。
8.自分のCSVへ置き換える手順とエラー対応
変更する場所を限定する
コード先頭のFEATURESとTARGETを自分の列名に変更します。sample_idとグループ列は必須です。以下は、作製バッチ単位の評価を実行する例です。
python materials_cross_validation.py --csv my_data.csv --group batch_id --output my_cv_results
材料系単位で分けるなら–group material_familyへ変更します。ただし、同じ物理試料が複数のラベルを持つ場合は、先に分類の整合性を確認します。IDの先頭のゼロを意味として使うCSVでは、pd.read_csvのdtype指定でID列を文字列として読み込むよう変更してください。
最初に予測時に入手できる特徴量だけを選び、単位と条件を確認します。次に、試料・バッチ・材料系の関係を整理し、分割後のaudit.csvを見ます。その後に誤差と予測図を確認します。数値の改善だけを先に追わない順序が実務上のポイントです。
よくあるエラー
| 症状 | 原因候補 | 対応 |
|---|---|---|
| Missing columns | 列名の違い・空白 | CSVの列名と設定を照合 |
| 数値変換で停止 | 数値欄に単位や文字が混在 | 値と単位を分け、元記録を確認 |
| Target must be finite | 目的変数に欠測・無限大 | 原因を確認し、使用対象を決める |
| グループ数不足 | バッチが一つしかない等 | その未知性を評価できるか再検討 |
| Entirely missing feature | 学習側で列全体が欠測 | 測定・欠測構造と特徴量の必要性を確認 |
| 外側は動くが内側で停止 | 内側に十分なグループがない | 分割数・評価設計を見直す |
グループ数が少ない場合、行数を増やすために同じ試料の測定を複製しても、独立したグループは増えません。本コードは可能な範囲で外側を最大5分割、内側を最大3分割にしますが、分割数の自動調整が統計的な十分性を保証するわけではありません。
実務に移す前の追加確認
バッチと材料系が交差する場合、単純に二つのIDを連結して一つのグループにしても、同じバッチが両側に残ることがあります。両方の共有を避けたいなら、関係をたどったまとまりで分割する、共有する記録を評価対象から除くなどの設計が必要です。本スクリプトは単一のグループ列を守る教材であり、複雑な共有関係を自動で解決しません。
また、数値特徴量だけの回帰を想定しています。文字列のカテゴリ特徴量、分類、不均衡なクラス、時系列の間隔・遅れなどは、それぞれ前処理と分割を追加設計します。
9.限界・チェックリスト・FAQ
計算で確認できることと、実験で確認すること
交差検証で確認できるのは、持っているデータと指定した分割に基づく予測性能です。新しい装置、新しい工程、新しい材料系が過去データと大きく異なる場合、その性能を保証できません。少数グループでは評価結果も不安定になります。
実務では、業務で許容できる誤差、失敗したときの影響、予測から実験へ進む条件を決めます。研究者は試料の意味と実験条件、解析担当者は前処理・分割・集計、運用担当者はデータ更新や環境変更を確認します。モデルの評価点だけで、実験結果の妥当性や研究判断の責任を置き換えることはできません。
チェックリスト
- 将来、何を新しく予測するか説明できる。
- 一行の単位と、試料・バッチ・材料系の関係が明確である。
- 予測時に取得できる特徴量だけを使っている。
- 学習・評価間の共有グループと共有試料を点検した。
- 補完・標準化・特徴量選択を学習側で行っている。
- 設定を選ぶ場合は内側でも適切な分割を守っている。
- OOF予測、fold別、グループ別の結果を保存した。
- 記録数とグループ数、評価単位による重みの違いを確認した。
- 評価結果を見た後の変更を記録している。
- 別の実験や新しいデータで確認する計画がある。
FAQ
Q.何分割がよいですか?
A.記録数だけでなく、独立したグループ数と利用目的で判断します。分割数が多いほどよいとは限りません。各学習・評価側に、意味のあるデータが残るかを点検します。
Q.LOOCVなら安心ですか?
A.一行ずつ除くLOOCVでも、その試料の別測定が学習側に残ることがあります。一つのグループを除く評価とも異なります。何を未知として評価するかが先です。
Q.グループ分割で性能が下がったら、モデルは使えませんか?
A.その利用場面では予測が難しい可能性があります。グループの違い、特徴量不足、分布の偏りを確認し、許容誤差と比較します。点数を戻すためだけにランダム分割へ変更しないようにします。
Q.同じ試料の測定は平均すべきですか?
A.試料特性の平均を予測したいのか、測定ごとの値を扱いたいのかで判断します。平均するなら、測定法・条件が比較可能か、ばらつきや測定回数も残すかを確認します。原測定の記録は保持してください。
まとめ
交差検証は、単にデータを何分割かにする作業ではありません。将来の予測対象を決め、関連する記録を適切にまとめ、前処理とモデル選択の情報を評価側へ漏らさず、結果を読める形で保存する作業です。
まずサンプルコードを実行し、audit.csvで重複の違いを確認してください。その後、自分のデータのFEATURES、TARGET、グループ列を設定し、想定する使用場面に合う評価へ置き換えてください。
参考文献
[1]scikit-learn developers. GroupKFold; Cross-validation: evaluating estimator performance. GroupKFold公式仕様、交差検証ガイド。グループの非重複、分割数の条件を参照。DOIなし。
[2]scikit-learn developers. Common pitfalls and recommended practices. 公式文書。データリーク、学習側だけで行う前処理、Pipelineを参照。DOIなし。
[3]scikit-learn developers. Nested versus non-nested cross-validation. 公式実装例。内側のモデル選択と外側の評価の仕組みを参照。本記事のグループ回帰コードは編集部による実装であり、公式例の実験結果とは区別する。DOIなし。
[4]Cawley, G. C., & Talbot, N. L. C. (2010). On Over-fitting in Model Selection and Subsequent Selection Bias in Performance Evaluation. Journal of Machine Learning Research, 11(70), 2079–2107. 論文掲載ページ、原著本文PDF。モデル選択による過適合と評価の偏りを参照。DOIは掲載情報で確認できないため記載しない。
参考資料の確認・コード実行日:2026年10月7日。合成データ、条件表、コード、指標計算例、実務上の手順とチェックリストは編集部による教材です。