
この記事でわかること
- モデルの適用範囲(AD)とは何か、補間・外挿・不確かさとの違い
- 学習データとの近さを、標準化とk近傍距離で計算する方法
- しきい値を調整し、採用割合と予測誤差を独立データで確認する方法
- 保存済みモデルで、新しい候補だけを予測・AD判定する方法
- AD内外・検証状態・近傍試料から、利用判断と追加実験へつなげる方法
機械学習モデルが新しい材料へ予測値を返しても、その予測を利用できるとは限りません。学習データに近い条件と、情報の乏しい条件を区別するために、モデルの適用範囲・適用領域(Applicability Domain:AD)を設定します。
本記事では、k近傍距離によるADをPythonで計算し、新候補の判定と独立データによる検証まで実施します。読み終えると、候補ごとの予測値、近傍距離、AD内外、近い学習試料をCSVに出力できます。不確かさ推定や予測区間の校正は別の論点として、ここではADの実装に集中します。
例題は高分子膜の乾燥条件と強度を想定した編集部作成の合成データです。実測の材料性能、公開論文の追試、実機の推奨条件を表すものではありません。
まず第1〜3章で考え方、第4〜5章で入力と実装、第6〜7章で結果と検証を確認します。学習済みモデルを使う手順は第8章です。
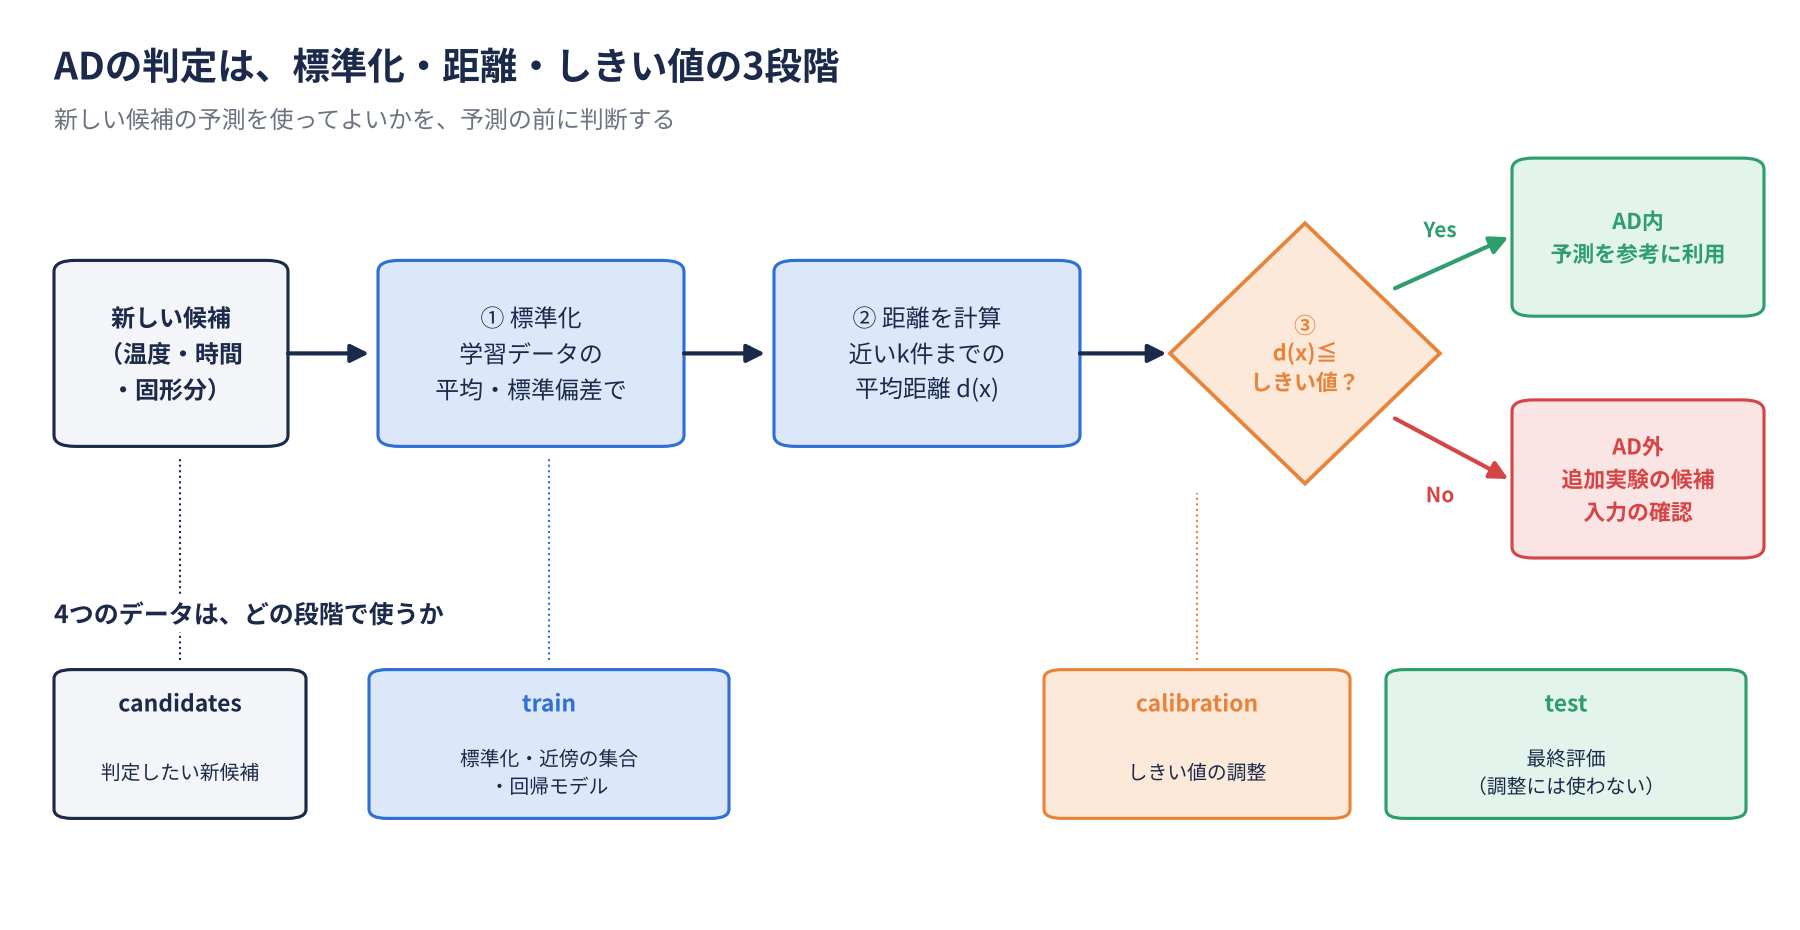
1.ADとは?補間・外挿・不確かさとの違い
なぜ予測値だけでは判断しにくいのか
高分子膜の乾燥条件から強度を予測する場面を考えます。学習に使った条件が70〜110℃なら、90℃の候補には比較できる記録が多い一方、140℃の候補では乾燥中の状態が変わる可能性があります。どちらにも数値は返りますが、利用の裏づけは同じではありません。
ADは、モデルの入力と既知の記録の関係を調べ、検証した用途で予測を参考にできる領域を整理するための道具です。領域外の条件も、追加実験から新しい情報を得る候補として扱えます。
ADは、モデルが利用目的に必要な性能を発揮できると考える入力データ領域です。距離や密度で境界を設定する場合、その境界が予測誤差と対応するかを検証して初めて、利用判断の裏づけになります。金子弘昌先生の公開資料でも、回帰・分類モデルを利用する際の重要な概念として説明されています[1]。
例えば、学習データの温度と時間が(800℃,1h)、(900℃,2h)、(1,000℃,3h)に並ぶ場合、(950℃,2.5h)はその並びに近い点です。一方、(1,000℃,1h)は各変数の最小・最大以内でも、観測された組合せから離れています。各項目の範囲内というだけでは、AD内とは判断できません。
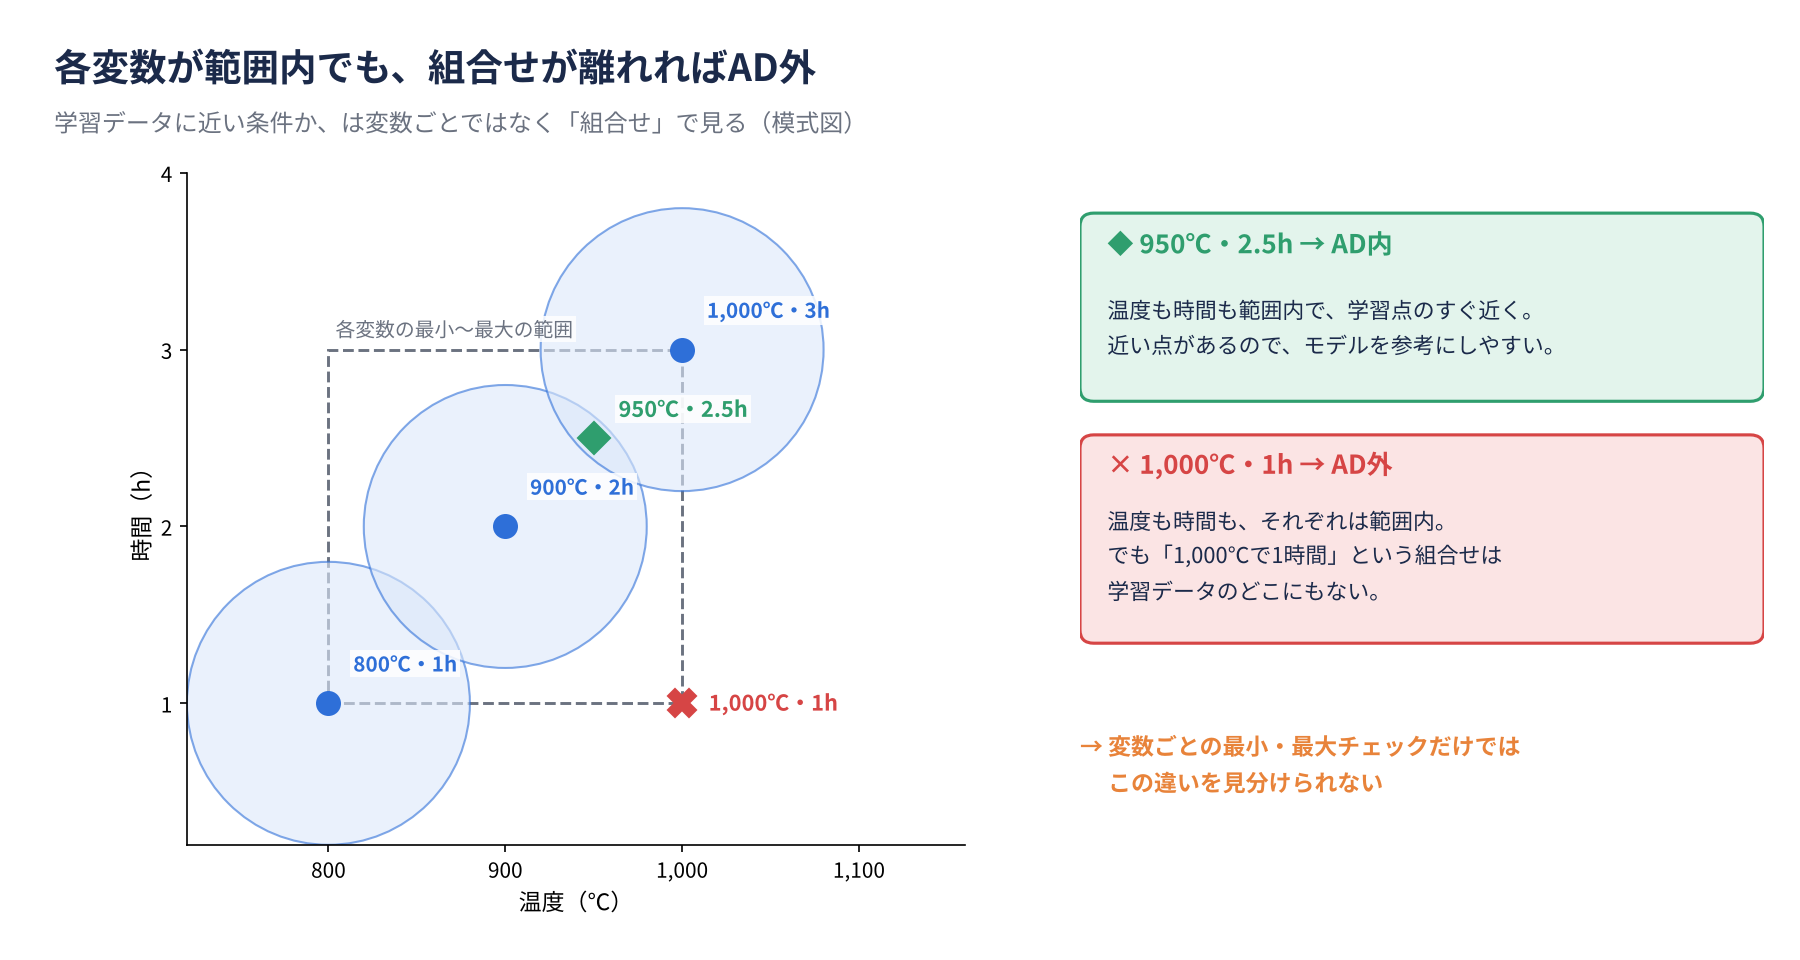
補間・外挿は既知領域の内外への推定を指し、ADは採用した基準による利用領域です。両者は同義ではなく、境界近くの外挿が定義したAD内になる場合もあります[2]。またADスコアは予測区間でも成功確率でもありません。AD内でも大きく外れる試料はあり得ます。
2.どの特徴量でADを設定するか
基本は、予測モデルに使った特徴量と同じ前処理でADを設定することです。特徴量選択を行う場合、学習用データ内で選択し、選択後の列をADにも用います。金子先生の解説では、定数のため削除した変数が新試料で変化する場合の確認も扱われています[3]。
標準化は学習データの平均・標準偏差を保存して使います。検証データや新候補を加えて計算し直すと、距離の意味が変わります。本例のStandardScalerは標準偏差をddof=0で計算します。手計算の標本標準偏差ddof=1と数値が異なる点にも注意してください[5]。
- 材料系列、装置、雰囲気が学習時と変わる場合は、数値距離とは別に確認する。
- 未知カテゴリーを全ゼロに符号化できても、既知条件として扱わない。
- 学習時に変化しなかった変数は、削除後も変更監視項目として残す。
- 同一バッチ由来の試片や繰り返し測定は、データ分割前に関連づける。
特徴量の選び方は材料開発における特徴量設計、単位・測定条件の整理は材料データの品質を高める方法を参照してください。
3.k近傍距離でADを設定する仕組み
各特徴量を標準化し、新候補から学習試料までのユークリッド距離を計算します。近い順にk個を選び、その平均をADスコアにします。最も近い1点だけを使う方法よりも、周囲の複数試料を参照できます。ただし、密な重複測定に引っ張られる問題は別途対処が必要です。
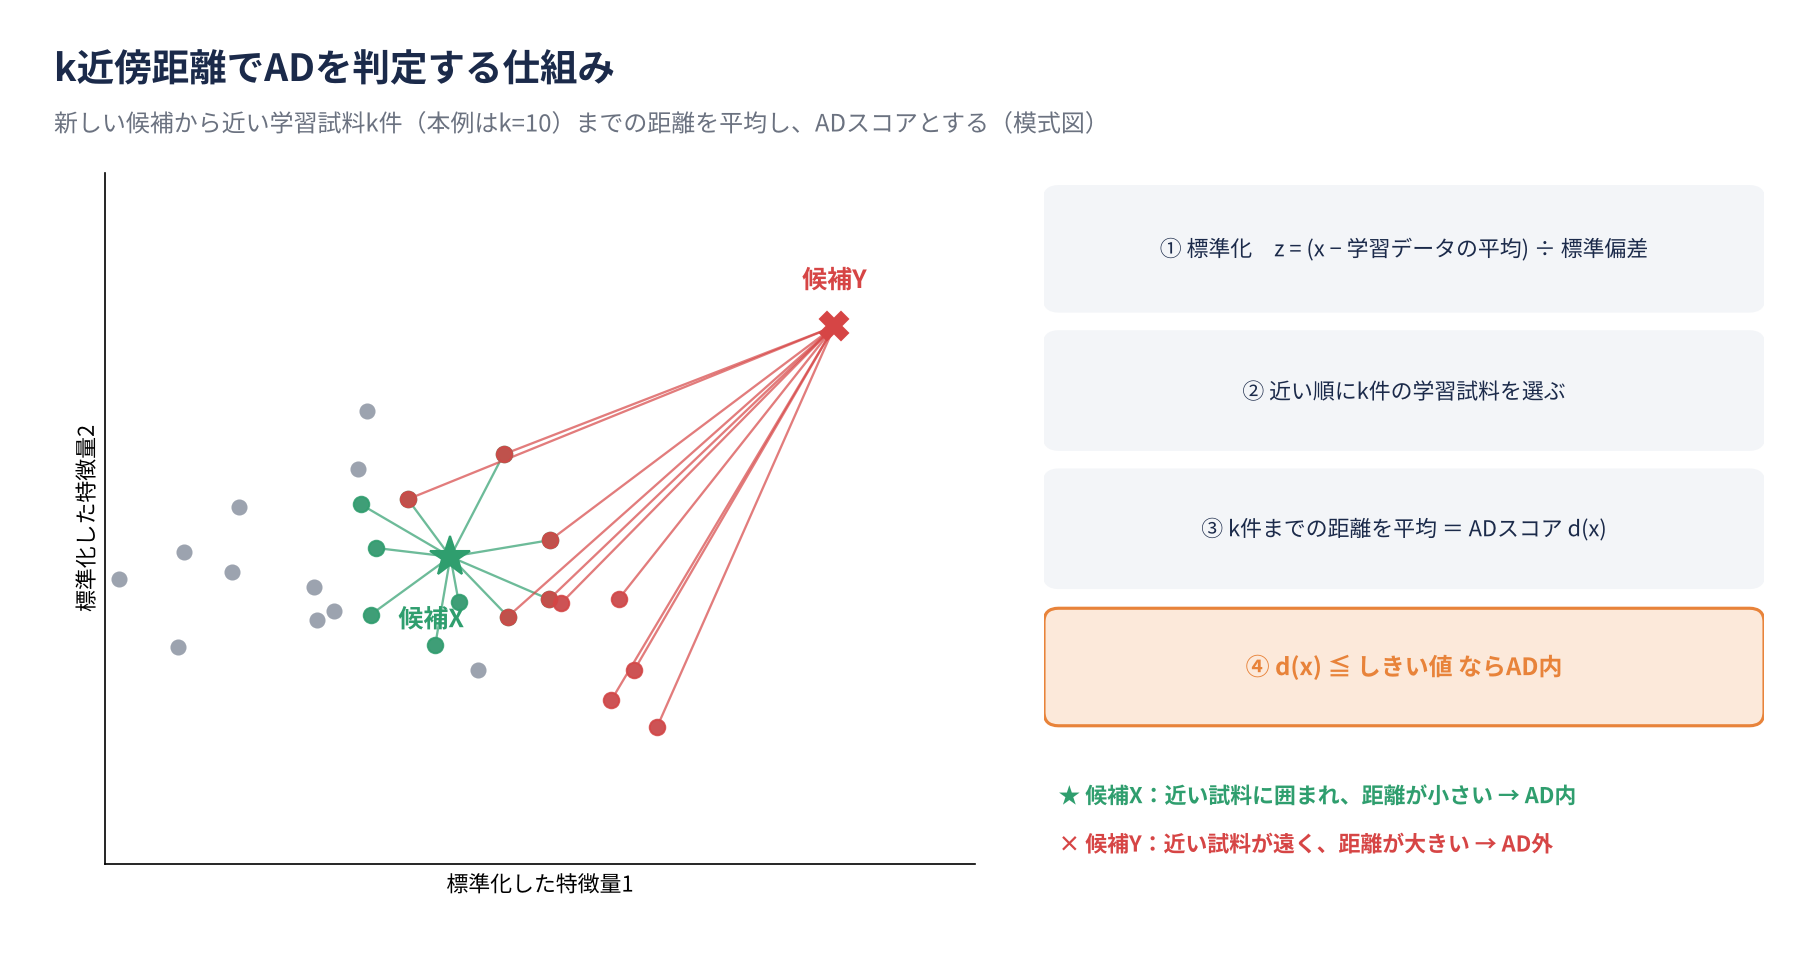
z_j = (x_j - mean_train_j) / std_train_j
d(x) = mean(distance(z, each of k nearest training samples))
AD_inside = d(x) <= threshold
本例ではk=10を使います。金子先生は簡便な出発点としてk-NNを紹介していますが、kを普遍的な最適値とは扱いません。5・10・20などを比較する場合は、データ数、局所密度、調整用データでの誤差との対応を確認します[4]。
標準化を、小さな数値例で理解する
説明用に、学習温度の平均90℃・標準偏差10℃、時間の平均30分・標準偏差5分とします。候補が100℃・35分なら、標準化した値は温度1、時間1です。
| 項目 | 学習平均 | 学習標準偏差 | 候補 | 標準化後 |
|---|---|---|---|---|
| 温度[℃] | 90 | 10 | 100 | (100−90)/10=1 |
| 時間[分] | 30 | 5 | 35 | (35−30)/5=1 |
標準化後の平均点(0,0)からの距離は√(1²+1²)=約1.414です。標準化前の数値で計算すると√(10²+5²)=約11.18ですが、時間を秒へ変更すると数値が大きく変わります。学習分布の尺度でそろえることで、単位の数値的な大きさだけに引っ張られにくくします。
ここでは平均点で説明しましたが、実際のADスコアは近い学習試料k件への距離の平均です。標準化だけで特徴量の重要度や相関が解決するわけではなく、距離と誤差の対応を別途確認します。
学習試料の距離は、自分自身を除外する
学習試料を学習集合へ照合すると、自分自身との距離0が含まれる場合があります。これを含めてしきい値を設定すると、距離が過小になります。scikit-learnのNearestNeighborsでは、引数Xを省略したkneighborsで各学習行自身を除外できます。新候補にはXを渡して検索します[6]。
scaler = StandardScaler().fit(X_train)
Z_train = scaler.transform(X_train)
Z_new = scaler.transform(X_new)
nn = NearestNeighbors(n_neighbors=10).fit(Z_train)
train_distances, _ = nn.kneighbors(n_neighbors=10)  # 自身を除外
new_distances, new_indices = nn.kneighbors(Z_new)
train_scores = train_distances.mean(axis=1)
new_scores = new_distances.mean(axis=1)
しきい値は暫定設定と性能検証を分ける
学習側スコアの95パーセンタイルを暫定しきい値にできます。これは学習配置に対する境界の目安で、95%の予測精度や95%の成功確率を保証しません。本例では、さらに調整用データでしきい値を選びます。これによって「学習分布への近さ」と「用途に許容できる誤差」を区別して確認します。
| 境界の種類 | 決め方 | この例 | 読み方 |
|---|---|---|---|
| 暫定の距離境界 | 学習試料の自己除外距離の95%点 | 0.901 | 学習分布への近さの目安 |
| 誤差基準から選んだ利用境界 | 調整用データの採用件数とRMSE | 2.761 | 採用集団の性能から選んだ境界 |
二つは目的が異なります。後者が大きくなっても学習済みモデルの予測値は変わりません。調整用・独立評価の構成が想定する利用場面を代表しているかを確認した上で、その境界を利用します。
4.データの役割とCSV形式
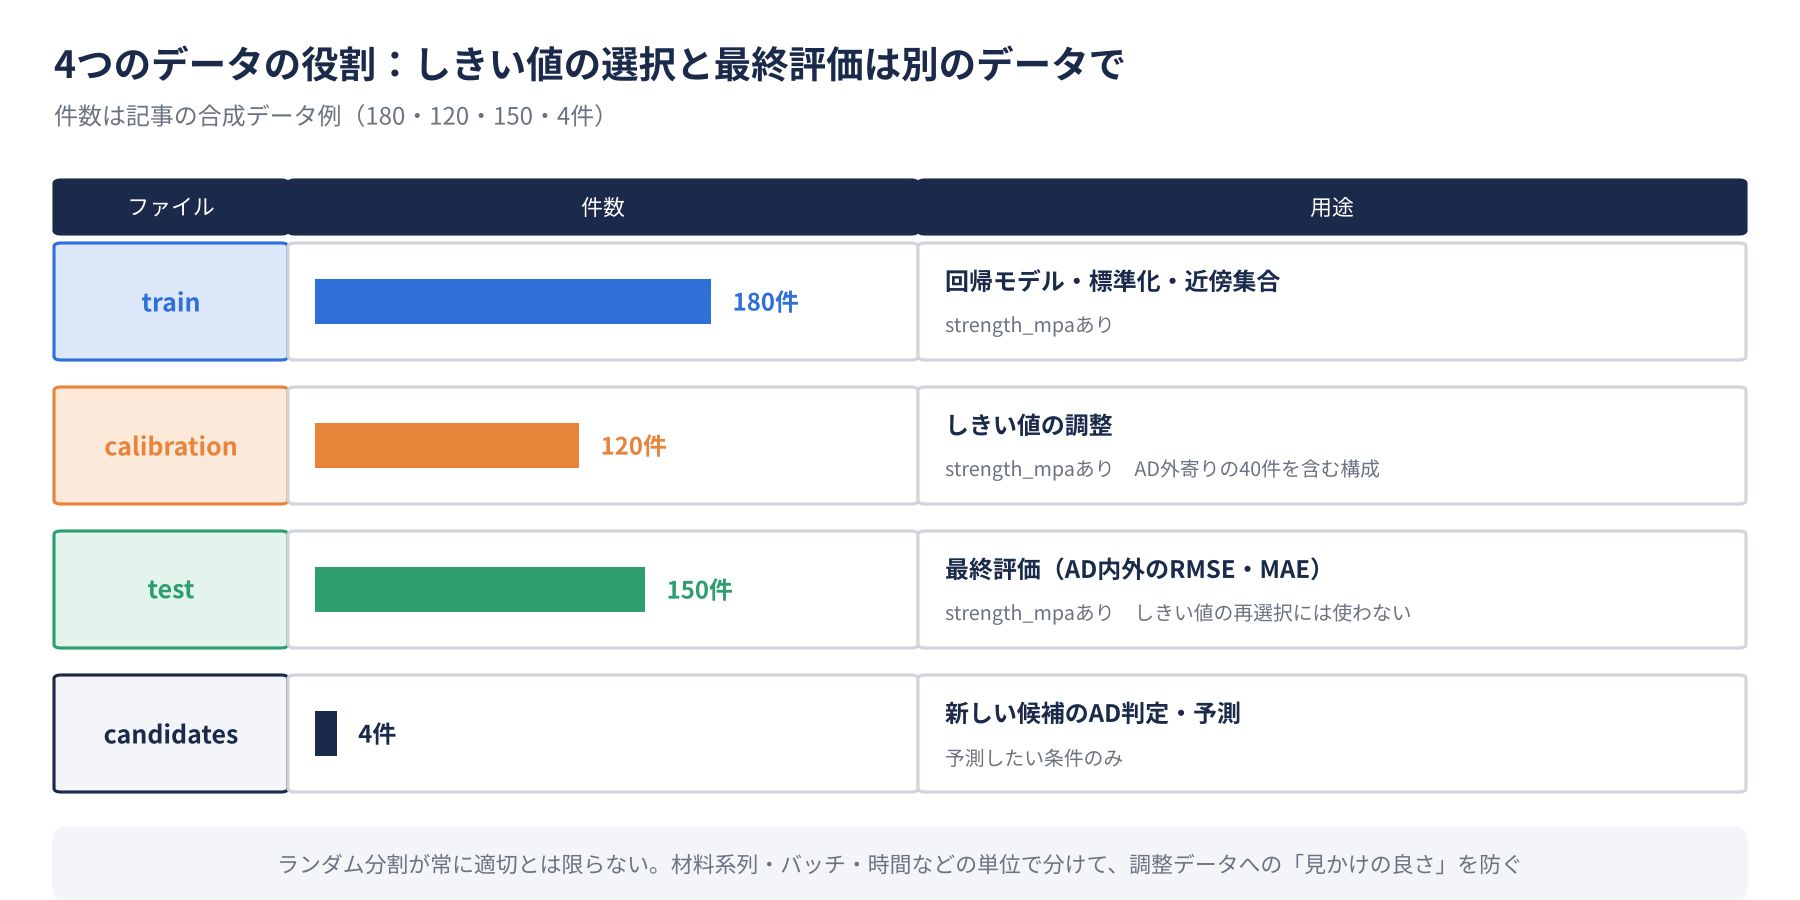
本例は一つの回帰モデル・kを固定してADのしきい値を調整します。実データでは材料系列・バッチ・時間など、将来の利用場面に対応する単位で分けてください。ランダム分割が適切とは限りません。
| ファイル | 役割 | 合成データの件数 |
|---|---|---|
| train.csv | 回帰モデル、標準化、近傍集合を作る | 180 |
| calibration.csv | ADしきい値を調整する。予測区間の校正とは別 | 120 |
| test.csv | 固定したモデル・ADを最終評価する | 150 |
| candidates.csv | 実測値のない新候補を判定する | 4 |
必須の入力列はsample_id、temperature_c、time_min、solids_pctです。前の三ファイルには目的変数strength_mpaも必要です。sample_idは特徴量に入れません。値は数値、列順はコードのFEATURESで固定します。
sample_id,temperature_c,time_min,solids_pct,strength_mpa
TR000,100.95824194223853,41.72377472635574,38.62472471380204,43.17842218791044
TR001,87.5551375900821,41.80339919093589,22.394671770022455,32.472839402569775
TR002,104.34391679645529,30.56575081159347,22.342071318002212,34.303411894434404
合成データでは、学習温度を70~110℃、時間を15~45分、固形分を20~40%とし、調整・評価データには115~145℃の候補も加えています。高温側で強度が低下する架空の関係を入れ、学習領域から離れた候補で誤差が増える例を作りました。ADが実材料でも同じように働くことを示す検証ではありません。
5.Pythonコード:データ生成からAD判定まで
以下をad_practical.pyとして保存します。Python 3.12.14、scikit-learn 1.8.0で実行確認しました。まず必要なライブラリを導入し、合成データで動作を確認します。バージョンが異なると数値が多少変わる場合があります。
python -m pip install numpy pandas scikit-learn matplotlib joblib
python ad_practical.py --demo --data ad_demo_data_v2 --out ad_output_v2
–demoはad_demo_dataフォルダに説明用CSVを生成します。既存のデータフォルダーがある場合は停止します。–dataで新しいフォルダー名を指定してください。出力フォルダーも新規作成のみとし、既存結果を上書きしません。ご自身のCSVをmy_dataに置く場合は、次のように実行します。
python ad_practical.py --data my_data --out my_results以下は一連の処理を含む完全なコードです。予測モデルは説明用のランダムフォレストで、回帰モデル自体の最適化は行いません。ADのしきい値を変更しても、モデルの予測値そのものは変わりません。
完全なPythonコードを開く(ad_practical.py)
"""Reproducible numeric-feature AD tutorial; all demo observations are synthetic.
Run: python ad_practical.py --demo --out ad_output
Real CSV: python ad_practical.py --data my_data --out my_results
Required: train.csv, calibration.csv, test.csv, candidates.csv.
"""
from pathlib import Path
import argparse
import json
import numpy as np
import pandas as pd
import sklearn
import joblib
import matplotlib
matplotlib.use("Agg")
import matplotlib.pyplot as plt
from sklearn.preprocessing import StandardScaler
from sklearn.neighbors import NearestNeighbors
from sklearn.ensemble import RandomForestRegressor
from sklearn.svm import OneClassSVM
from sklearn.metrics import mean_squared_error, mean_absolute_error

FEATURES = ["temperature_c", "time_min", "solids_pct"]
TARGET = "strength_mpa"
K = 10
TOLERANCE = 2.5  # illustrative engineering requirement, not a universal value
MIN_CALIBRATION = 25
ABS_ERROR_LIMIT = 2.5  # separate per-observation error limit, illustrative only

def demo(folder):
    rng = np.random.default_rng(42)
    folder.mkdir(parents=True, exist_ok=False)
    def observations(n_inside, n_outside, prefix):
        n = n_inside + n_outside
        temp = np.r_[rng.uniform(70, 110, n_inside), rng.uniform(115, 145, n_outside)]
        time = rng.uniform(15, 45, n)
        solids = rng.uniform(20, 40, n)
        # Fictional polymer-film relationship and iid observation noise.
        strength = (35 + .18*(temp-90) + .12*(time-30) + .30*(solids-30)
                    - .018*np.maximum(temp-110, 0)**2
                    + .002*(temp-90)*(time-30) + rng.normal(0, 1.2, n))
        return pd.DataFrame({"sample_id": [f"{prefix}{i:03d}" for i in range(n)],
            FEATURES[0]: temp, FEATURES[1]: time, FEATURES[2]: solids, TARGET: strength})
    observations(180, 0, "TR").to_csv(folder/"train.csv", index=False)
    observations(80, 40, "CA").to_csv(folder/"calibration.csv", index=False)
    observations(100, 50, "TE").to_csv(folder/"test.csv", index=False)
    pd.DataFrame({"sample_id": ["A", "B", "C", "D"],
        "temperature_c": [90, 140, 75, 105], "time_min": [30, 30, 44, 18],
        "solids_pct": [30, 30, 39, 23]}).to_csv(folder/"candidates.csv", index=False)

def validate_frame(frame, features, target=None):
    required = ["sample_id", *features] + ([target] if target else [])
    missing = set(required) - set(frame.columns)
    if missing:
        raise ValueError(f"Missing columns: {missing}")
    if frame.empty or frame.sample_id.isna().any():
        raise ValueError("Empty data or missing sample_id")
    frame = frame.copy()
    frame["sample_id"] = frame.sample_id.astype(str).str.strip()
    if frame.sample_id.eq("").any() or frame.sample_id.duplicated().any():
        raise ValueError("Blank or duplicate sample_id")
    numeric = features + ([target] if target else [])
    frame[numeric] = frame[numeric].apply(pd.to_numeric, errors="raise")
    if not np.isfinite(frame[numeric].to_numpy(dtype=float)).all():
        raise ValueError("Numeric columns contain missing/infinite values")
    return frame


def add_decision_columns(result, metadata):
    # Aggregate validation evidence is separate from each candidate's distance.
    confirmed = (metadata["calibration_criterion_met"] and
                 metadata["test_inside_criterion_met"])
    result = result.copy()
    result["validation_status"] = "criterion_met" if confirmed else "provisional"
    result["review_reason"] = np.select(
        [np.full(len(result), not confirmed), ~result.ad_inside,
         result.outside_any_feature_range],
        ["validation_not_established", "outside_distance_boundary",
         "outside_feature_range_check"],
        default="check_material_and_measurement_context")
    return result


def predict_saved(bundle_path, candidate_path, out):
    # Load only trusted bundles produced by your own workflow.
    bundle = joblib.load(bundle_path)
    metadata = bundle["metadata"]
    if metadata["sklearn_version"] != sklearn.__version__:
        raise ValueError("Use the recorded scikit-learn version for this saved bundle")
    features = metadata["features"]
    frame = validate_frame(pd.read_csv(candidate_path, dtype={"sample_id": str}), features)
    z = bundle["scaler"].transform(frame[features])
    distances, indices = bundle["neighbors"].kneighbors(z)
    result = frame.copy()
    result["prediction_mpa"] = bundle["regression_model"].predict(z)
    result["knn_distance"] = distances.mean(axis=1)
    result["threshold"] = metadata["selected_threshold"]
    result["ad_inside"] = result.knn_distance <= result.threshold
    ids = np.asarray(bundle["training_sample_ids"])
    result["nearest_sample_id"] = ids[indices[:, 0]]
    result["neighbor_ids"] = [";".join(ids[ix]) for ix in indices]
    result["outside_any_feature_range"] = (
        (frame[features] < pd.Series(metadata["training_min"])) |
        (frame[features] > pd.Series(metadata["training_max"]))).any(axis=1)
    result = add_decision_columns(result, metadata)
    out.mkdir(parents=True, exist_ok=False)
    result.to_csv(out/"candidates_results.csv", index=False)
    print(result.to_string(index=False))
    return result


def load(folder):
    frames = {name: pd.read_csv(folder/f"{name}.csv", dtype={"sample_id": str, "batch_id": str})
              for name in ["train", "calibration", "test", "candidates"]}
    for name, frame in frames.items():
        frames[name] = validate_frame(frame, FEATURES, None if name == "candidates" else TARGET)
    # If batch IDs are supplied, all labeled files must include them.
    labeled = [frames[n] for n in ["train", "calibration", "test"]]
    if any("batch_id" in frame for frame in labeled):
        if not all("batch_id" in frame for frame in labeled):
            raise ValueError("batch_id must appear in all three labeled files")
        for frame in labeled:
            if frame.batch_id.isna().any():
                raise ValueError("Missing batch_id")
            frame["batch_id"] = frame.batch_id.astype(str).str.strip()
            if frame.batch_id.eq("").any():
                raise ValueError("Blank batch_id")
        for i, j in [(0, 1), (0, 2), (1, 2)]:
            if set(labeled[i].batch_id) & set(labeled[j].batch_id):
                raise ValueError("Batch IDs overlap across labeled files")
    for first, second in [("train", "calibration"), ("train", "test"), ("calibration", "test")]:
        if set(frames[first].sample_id) & set(frames[second].sample_id):
            raise ValueError(f"{first}/{second}: sample IDs overlap")
    if len(frames["train"]) <= K:
        raise ValueError("Training count must exceed K for self-excluded distances")
    if (frames["train"][FEATURES].nunique() < 2).any():
        raise ValueError("Constant training features: remove with a separate change check")
    if frames["train"].duplicated(FEATURES).any():
        raise ValueError("Duplicate training feature rows: review independent batches/replicates")
    return frames

def metrics(y, prediction, mask, label):
    count = int(mask.sum())
    return {"subset": label, "n": count,
        "rmse_mpa": float(np.sqrt(mean_squared_error(y[mask], prediction[mask]))) if count else None,
        "mae_mpa": float(mean_absolute_error(y[mask], prediction[mask])) if count else None,
        "error_limit_mpa": ABS_ERROR_LIMIT,
        "error_exceedance_fraction": float((np.abs(y[mask]-prediction[mask]) > ABS_ERROR_LIMIT).mean()) if count else None}

def main():
    parser = argparse.ArgumentParser()
    parser.add_argument("--demo", action="store_true")
    parser.add_argument("--data", default="ad_demo_data")
    parser.add_argument("--out", default="ad_output")
    parser.add_argument("--bundle", help="Trusted saved bundle; use with --candidates")
    parser.add_argument("--candidates", help="New candidate CSV; no strength labels required")
    args = parser.parse_args()
    if args.bundle:
        if not args.candidates or args.demo:
            parser.error("--bundle requires --candidates and cannot combine with --demo")
        predict_saved(args.bundle, args.candidates, Path(args.out))
        return
    if args.candidates:
        parser.error("--candidates requires --bundle")
    folder, out = Path(args.data), Path(args.out)
    if args.demo:
        demo(folder)  # generate only in a new folder
    frames = load(folder)
    out.mkdir(parents=True, exist_ok=False)
    train = frames["train"]
    scaler = StandardScaler().fit(train[FEATURES])  # train only
    z = {name: scaler.transform(frame[FEATURES]) for name, frame in frames.items()}
    nn = NearestNeighbors(n_neighbors=K).fit(z["train"])
    # X=None queries training samples and excludes each row itself.
    train_distances, _ = nn.kneighbors(n_neighbors=K)
    train_scores = train_distances.mean(axis=1)
    preliminary = float(np.quantile(train_scores, .95))
    model = RandomForestRegressor(n_estimators=200, min_samples_leaf=3,
                                  random_state=42, n_jobs=1).fit(z["train"], train[TARGET])
    predictions = {name: model.predict(z[name]) for name in ["calibration", "test", "candidates"]}
    distances, indices, scores = {}, {}, {}
    for name in ["calibration", "test", "candidates"]:
        distances[name], indices[name] = nn.kneighbors(z[name])
        scores[name] = distances[name].mean(axis=1)
    # Calibrate using only calibration labels, with fixed K/model/tolerance.
    cal_y = frames["calibration"][TARGET].to_numpy()
    grid = np.unique(np.r_[np.quantile(train_scores, [.5, .75, .9, .95, .99]),
                           np.quantile(scores["calibration"], [.5, .6, .7, .8, .9, 1])])
    rows = []
    for threshold in grid:
        mask = scores["calibration"] <= threshold
        row = metrics(cal_y, predictions["calibration"], mask, "calibration")
        row.update(threshold=float(threshold), accepted_fraction=float(mask.mean()))
        rows.append(row)
    tuning = pd.DataFrame(rows)
    eligible = tuning[(tuning.n >= MIN_CALIBRATION) & (tuning.rmse_mpa <= TOLERANCE)]
    if eligible.empty:
        chosen, established = preliminary, False
    else:
        chosen = float(eligible.sort_values(["accepted_fraction", "threshold"]).iloc[-1].threshold)
        established = True
    tuning.to_csv(out/"calibration_thresholds.csv", index=False)
    result_tables = {}
    for name in ["calibration", "test", "candidates"]:
        result = frames[name].copy()
        result["prediction_mpa"] = predictions[name]
        result["knn_distance"] = scores[name]
        result["threshold"] = chosen
        result["ad_inside"] = scores[name] <= chosen
        result["nearest_sample_id"] = train.sample_id.iloc[indices[name][:, 0]].to_numpy()
        result["neighbor_ids"] = [";".join(train.sample_id.iloc[ix]) for ix in indices[name]]
        result["outside_any_feature_range"] = (
            (result[FEATURES] < train[FEATURES].min()) |
            (result[FEATURES] > train[FEATURES].max())).any(axis=1)
        if name != "candidates":
            result["absolute_error_mpa"] = np.abs(result[TARGET] - result.prediction_mpa)
        result.to_csv(out/f"{name}_results.csv", index=False)
        result_tables[name] = result
    test_y = frames["test"][TARGET].to_numpy()
    inside = scores["test"] <= chosen
    summary = [metrics(test_y, predictions["test"], np.ones(len(test_y), dtype=bool), "all"),
               metrics(test_y, predictions["test"], inside, "AD_inside"),
               metrics(test_y, predictions["test"], ~inside, "AD_outside")]
    pd.DataFrame(summary).to_csv(out/"test_summary.csv", index=False)
    # Final-test diagnostic curve only. Never use it to tune/reselect the threshold.
    order = np.argsort(scores["test"])
    curve = []
    for n in range(min(25, len(order)), len(order)+1):
        ids = order[:n]
        curve.append({"n": n, "accepted_fraction": n/len(order),
                      "rmse_mpa": float(np.sqrt(mean_squared_error(test_y[ids], predictions["test"][ids])))})
    pd.DataFrame(curve).to_csv(out/"test_coverage_rmse.csv", index=False)
    # Illustrative alternative, not optimized and not used for threshold selection.
    oc = OneClassSVM(kernel="rbf", gamma="scale", nu=.05).fit(z["train"])
    comparison = frames["candidates"][["sample_id"]].copy()
    comparison["knn_inside"] = scores["candidates"] <= chosen
    comparison["ocsvm_inside"] = oc.predict(z["candidates"]) == 1
    comparison["ocsvm_score"] = oc.decision_function(z["candidates"])
    comparison.to_csv(out/"ocsvm_comparison.csv", index=False)
    metadata = {"features": FEATURES, "k": K, "preliminary_threshold": preliminary,
        "training_min": train[FEATURES].min().to_dict(),
        "training_max": train[FEATURES].max().to_dict(),
        "absolute_error_limit_mpa": ABS_ERROR_LIMIT,
        "selected_threshold": chosen, "calibration_criterion_met": established,
        "tolerance_rmse_mpa": TOLERANCE, "min_calibration_n": MIN_CALIBRATION,
        "scaler_mean": scaler.mean_.tolist(), "scaler_scale": scaler.scale_.tolist(),
        "sklearn_version": sklearn.__version__, "demo": args.demo,
        "test_inside_fraction": float(inside.mean()),
        "test_inside_criterion_met": bool(inside.sum() >= MIN_CALIBRATION and
            summary[1]["rmse_mpa"] <= TOLERANCE)}
    for name, result in result_tables.items():
        result_tables[name] = add_decision_columns(result, metadata)
        result_tables[name].to_csv(out/f"{name}_results.csv", index=False)
    group_rows = []
    for column in ["batch_id", "material_family", "measurement_date"]:
        if column in frames["test"]:
            groups = frames["test"][column].fillna("<missing>").astype(str)
            for group in sorted(groups.unique()):
                mask = (groups == group).to_numpy() & inside
                row = metrics(test_y, predictions["test"], mask, "AD_inside")
                row.update(group_column=column, group_value=group)
                group_rows.append(row)
    if group_rows:
        pd.DataFrame(group_rows).to_csv(out/"test_group_summary.csv", index=False)
    (out/"metadata.json").write_text(json.dumps(metadata, ensure_ascii=False, indent=2))
    joblib.dump({"scaler": scaler, "regression_model": model, "neighbors": nn,
                 "ocsvm": oc, "training_sample_ids": train.sample_id.tolist(),
                 "metadata": metadata}, out/"ad_bundle.joblib")
    fig, ax = plt.subplots(figsize=(6, 3.5))
    ax.scatter(scores["test"], np.abs(test_y-predictions["test"]), s=14, alpha=.7)
    ax.axvline(chosen, color="red", linestyle="--", label="Frozen threshold")
    ax.set(xlabel="Mean k-neighbor distance", ylabel="Absolute error (MPa)")
    ax.legend(); fig.tight_layout(); fig.savefig(out/"distance_error.svg")
    fig.savefig(out/"distance_error.png", dpi=180)
    plt.close(fig)
    fig, ax = plt.subplots(figsize=(6, 3.5))
    ax.plot([r["accepted_fraction"] for r in curve], [r["rmse_mpa"] for r in curve])
    ax.axhline(TOLERANCE, color="red", linestyle="--", label="Illustrative tolerance")
    ax.set(xlabel="Accepted fraction (final test)", ylabel="RMSE (MPa)")
    ax.legend(); fig.tight_layout(); fig.savefig(out/"coverage_rmse.svg")
    fig.savefig(out/"coverage_rmse.png", dpi=180)
    plt.close(fig)
    print(json.dumps(metadata, ensure_ascii=False, indent=2))
    print(pd.DataFrame(summary).round(3).to_string(index=False))
    print(result_tables["candidates"][["sample_id", "prediction_mpa", "knn_distance", "ad_inside",
                                     "nearest_sample_id"]].round(3).to_string(index=False))

if __name__ == "__main__":
    main()
6.実行結果の読み方:AD内外と近傍試料
今回の実行では、暫定しきい値は0.901、調整後は2.761でした。調整後の値が大きいのは、学習分布の境界ではなく、設定した用途の誤差基準を満たす範囲まで利用対象を広げたためです。この値を他のデータへ流用してはいけません。
| sample_id | prediction_mpa | knn_distance | ad_inside | nearest_sample_id |
|---|---|---|---|---|
| A | 34.585 | 0.642 | True | TR143 |
| B | 37.620 | 3.008 | False | TR005 |
| C | 35.121 | 1.134 | True | TR098 |
| D | 34.330 | 0.813 | True | TR169 |
候補Bは140℃で、平均近傍距離3.008がしきい値2.761を超えています。予測値37.620 MPaは計算できますが、今回のAD外です。追加実験の候補として検討し、性能を確認してからモデルへ戻します。A・C・DはAD内ですが、個々の予測が正しいことを保証しません。
nearest_sample_idは最も近い学習試料のIDです。CSVにはvalidation_status、review_reasonと、k個のneighbor_idsも出力するため、原料・装置・測定条件を照合できます。outside_any_feature_rangeは各列の範囲逸脱であり、AD内外とは別の列として残しています。
validation_statusはモデル・境界全体の検証状態です。criterion_metは調整と独立評価の件数・RMSE基準を満たしたこと、provisionalはどちらかが未成立であることを示します。criterion_metでも、AD外の候補の性能や個別候補の仕様適合を保証する意味ではありません。
7.ADが機能しているかを独立データで検証する
しきい値選択と最終評価を分ける
本例では調整データで「採用件数25件以上、採用群のRMSEが2.5 MPa以下」を満たす候補しきい値のうち、採用割合が最大のものを選びます。25件、2.5 MPa、候補しきい値の生成法は編集部の説明用設定です。用途・件数・ばらつきに合わせて決めます。平均RMSEの基準であり、各試料の最大誤差を制限する基準ではありません。
基準を満たすしきい値がない場合、コードは暫定値を使いますが、metadataのcalibration_criterion_metをfalseにします。その場合、各候補のvalidation_statusをprovisional、review_reasonをvalidation_not_establishedにします。ad_insideがTrueでも、検証済みの利用領域とは扱いません。最終評価でも件数とRMSEの基準を確認し、test_inside_criterion_metを記録します。
| subset | n | rmse_mpa | mae_mpa |
|---|---|---|---|
| all | 150 | 4.058 | 2.463 |
| AD_inside | 135 | 2.062 | 1.524 |
| AD_outside | 15 | 11.241 | 10.918 |
最終評価では150件のうち135件、90%がAD内となりました。AD内のRMSEは2.062 MPa、AD外15件は11.241 MPaです。これは合成データの一回の結果で、実材料での改善率を表すものではありません。AD内の誤差が小さくても、多くの候補を除外しているなら使える場面は限られます。件数・採用割合・誤差を必ず一組で報告します。
平均誤差と、許容誤差を超えた割合を区別する
| 対象 | 件数 | RMSE[MPa] | MAE[MPa] | 絶対誤差2.5 MPa超過率 |
|---|---|---|---|---|
| all | 150 | 4.058 | 2.463 | 28.7% |
| AD_inside | 135 | 2.062 | 1.524 | 20.7% |
| AD_outside | 15 | 11.241 | 10.918 | 100.0% |
AD内のRMSEは2.062 MPaで基準2.5 MPa以下ですが、135件中28件(20.7%)は絶対誤差が2.5 MPaを超えています。集団のRMSEと個々の誤差は別の基準です。コードのTOLERANCEは集団RMSE、ABS_ERROR_LIMITは個別誤差の超過率を報告するための値です。この例では同じ2.5を置きましたが、目的に応じて別々に決めます。
超過率は診断として報告しており、今回のしきい値選択には使っていません。超過率も採用基準にするなら、最終評価を見る前に条件を決め、調整用データで選びます。少数件から安定した割合を断定せず、群別の件数も確認してください。
距離と絶対誤差の関係を描く
以下は最終評価データの平均近傍距離と絶対誤差です。赤い縦線は調整データで決めて固定した境界です。まず赤い線の左右で誤差の分布を比べ、次に左側にも大きく外れる点がないかを確認します。近い点でも誤差はゼロにならず、距離と誤差が一対一に対応するわけでもありません。

採用割合とRMSEの曲線を見る
試料をADスコアの小さい順に並べ、採用する試料を増やしながらRMSEを計算します。金子先生の公開解説では、この関係を使ってADの手法・パラメータを比較する考え方が示されています[4]。横軸が右へ進むほど多くの候補を残し、縦軸が上がるほど採用集団の誤差が増えます。件数を減らして誤差だけを小さくしていないかを見る図です。本例の最終評価曲線は診断用です。これを見てしきい値を選び直した場合、そのデータは最終評価用ではなくなります。

kや手法を選ぶ際は、調整データまたは適切な入れ子の交差検証で比較します。学習データの当てはめ誤差を使うと楽観的になります。交差検証でADを評価する場合、各評価試料の距離も、その試料が除外された学習集合から計算してください。特徴量選択・標準化・予測モデルの調整も各学習側に閉じ込めます。
AD内の残った試料について、材料系列・日・装置ごとの誤差も確認します。全体RMSEが小さくても一群だけ外れることがあります。評価件数が少ない群は暫定評価とし、追加実験へつなげます。
8.保存済みモデルで新候補だけを判定する
構築と利用を分けます。構築時は学習・調整・最終評価を行い、ad_bundle.joblibに前処理・モデル・近傍集合・しきい値・検証状態を保存します。利用時はそのファイルと新候補CSVだけを読み、再学習も再調整もしません。
python ad_practical.py --bundle ad_output_v2/ad_bundle.joblib --candidates new_candidates.csv --out new_predictions_v2new_candidates.csvの例は以下です。実測strength_mpaは不要です。列名・単位は学習時とそろえます。
sample_id,temperature_c,time_min,solids_pct
NEW001,90,30,30
NEW002,140,30,30
出力はnew_predictions_v2/candidates_results.csvです。prediction_mpa、knn_distance、ad_inside、nearest_sample_id、neighbor_idsに加え、validation_statusとreview_reasonを確認します。保存済みモデルを用いた結果が構築時の候補判定と一致することを確認しています。
| review_reason | 意味 | 次の確認 |
|---|---|---|
| validation_not_established | 調整・独立評価の基準が未成立 | 用途・特徴量・境界を再検討 |
| outside_distance_boundary | 距離が採用境界を超える | 近傍の確認と追加実験 |
| outside_feature_range_check | 距離内でも単変数の学習範囲外 | 範囲逸脱の内容を確認 |
| check_material_and_measurement_context | 距離内で数値範囲内 | 材料系列・装置・測定条件を照合 |
review_reasonは優先する確認理由を一つ表示します。範囲逸脱の全情報はoutside_any_feature_rangeとad_insideにも残ります。材料系列・装置・雰囲気の適合性をコードが自動保証するわけではありません。
既存の古いad_bundle.joblibには今回追加した保存項目がありません。更新版コードで構築し直したファイルを使ってください。保存時と同じscikit-learnバージョンで利用し、他の依存ライブラリの版も記録します。外部の未信頼joblibは読み込まないでください。
9.自分の材料データへ置き換える際の注意点
| 変更箇所 | 実務での確認 |
|---|---|
| FEATURES・TARGET | 予測モデルと同じ入力列・定義。単位、列順、前処理を固定する |
| 分割 | 同一試料・バッチをまたがせない。未知系列への利用なら系列単位で評価する |
| 欠損 | 本コードは停止する。補完するなら学習側で学習した補完器を全体に適用し、欠損発生も監視する |
| カテゴリ | 本コードは数値専用。別途符号化と未知カテゴリ検出を追加し、数値距離との重みを検討する |
| 重複 | 本コードは学習特徴量の重複で停止する。独立反復か繰り返し測定かを確認し、集約・群別設計を判断する |
| しきい値・k | AD内の精度だけでなく採用割合を確認。最終評価データで再調整しない |
| 保存 | ad_bundle.joblibに前処理・モデル・近傍集合・基準を保存。外部の未信頼joblibを読み込まない |
本コードはsample_idの重複・集合間の重なりを検出しますが、別IDで同じバッチを登録した場合までは分かりません。実データにはbatch_id、material_family、測定日などを保持し、分割の妥当性を人が確認してください。
多数の相関した記述子では、同じ情報を距離で重複評価することがあります。また高次元では距離の差が小さくなります。予測に必要な特徴量へ絞る、次元削減を検討する場合も、選択・変換を学習側で行い、ADの有効性を再評価します。
バッチをまたがせない三分割の例
未経験バッチへの利用を評価する場合は、以下のようにバッチ単位で分けられます。十分な独立バッチと各集合の測定件数があることを確認してください。割合はバッチ数に対する指定なので、行数が厳密に60/20/20%になるわけではありません。
from pathlib import Path
import pandas as pd
from sklearn.model_selection import GroupShuffleSplit

# sample_id, batch_id, FEATURES, strength_mpaを持つ実測データ。
df = pd.read_csv("measurements.csv", dtype={"sample_id": str, "batch_id": str})
if df.batch_id.isna().any() or df.batch_id.str.strip().eq("").any():
    raise ValueError("batch_idを確認してください")
df["batch_id"] = df.batch_id.str.strip()
outer = GroupShuffleSplit(n_splits=1, test_size=0.2, random_state=42)
dev_ix, test_ix = next(outer.split(df, groups=df.batch_id))
dev, test = df.iloc[dev_ix].copy(), df.iloc[test_ix].copy()
inner = GroupShuffleSplit(n_splits=1, test_size=0.25, random_state=43)
train_ix, cal_ix = next(inner.split(dev, groups=dev.batch_id))
train, calibration = dev.iloc[train_ix], dev.iloc[cal_ix]
out = Path("my_data")
out.mkdir(exist_ok=False)
for name, frame in [("train", train), ("calibration", calibration), ("test", test)]:
    frame.to_csv(out / f"{name}.csv", index=False)
my_dataへ候補のcandidates.csvを別途置き、–data my_dataで構築します。更新コードは三つのラベル付きCSVにbatch_idがある場合、欠測と集合間の重複を検査します。ただしIDが違っても同じ試料・作製に由来する場合は、人が対応を確認する必要があります。
将来の測定日に使いたいなら時間順、未知材料系列なら系列単位など、評価したい未知に合わせて分けます。調整や最終評価に十分なバッチが取れない場合は、材料データの交差検証を参照して、入れ子の評価を検討します。
test.csvにbatch_id、material_family、measurement_dateがあれば、AD内の群別件数・RMSE・MAE・超過率をtest_group_summary.csvへ出力します。全体基準を満たしても、ある群だけ精度が低い場合は、その群の利用を別途検討します。群別の採用条件は自動設定していません。
10.発展:One-Class SVMで領域を推定する
One-Class SVMは、学習試料の分布を囲む境界をカーネルで推定する選択肢です。以下ではk-NNと同じ標準化済み入力を使います。gammaとnuは説明用で、最適化済みの設定ではありません[7]。
oc = OneClassSVM(kernel="rbf", gamma="scale", nu=0.05).fit(Z_train)
ocsvm_inside = oc.predict(Z_new) == 1
ocsvm_score = oc.decision_function(Z_new)| sample_id | knn_inside | ocsvm_inside | ocsvm_score |
|---|---|---|---|
| A | True | True | 0.149 |
| B | False | False | -1.277 |
| C | True | False | -0.167 |
| D | True | True | 0.025 |
decision_functionの値は境界に対するスコアで、予測成功確率ではありません。nuは学習誤り割合の上限とサポートベクトル割合の下限に関係するパラメータで、未来の候補の5%をAD外にする指定ではありません。k-NNと判定が一致しても、独立データで予測誤差との対応を検証する必要があります[7]。
手法比較では、同じ調整・評価データ、同じ回帰モデル、同程度の採用割合で比べると解釈しやすくなります。OCSVMが常にk-NNより優れるという結論にはしません。マハラノビス距離は共分散推定、多峰性に注意し、KDEはバンド幅・高次元での疎さを確認します。最初からすべて実装するより、k-NNで検証の流れを確立してから必要な手法を追加します。
11.AD内外の候補を利用判断と追加実験へつなげる
AD外は「悪い材料」でも「必ず予測が外れる材料」でもありません。今回のモデル・特徴量・基準では利用の裏づけが不足するという意味です。既知領域の性能比較に使う候補と、新しい情報を得る探索候補を分けます。
| 状態 | 実務での扱い |
|---|---|
| AD内・検証基準成立・条件整合 | 検証した用途で候補比較の参考にする |
| AD内・材料系列や装置が変更 | 条件変更を照合して追加評価 |
| AD外 | 情報価値のある追加実験候補として検討 |
| 検証基準未成立 | 暫定判定として基準・データ・モデルを見直す |
- 近傍試料と実測条件を照合し、単位・入力・カテゴリの誤りを確認する。
- 未経験の材料系列・装置・条件があるかを確認する。
- 実験可能性を確認し、情報価値のあるAD外候補を少数測定する。
- 新しい結果を保存し、モデル・標準化・AD基準をまとめて再学習・再検証する。
本コードはAD内の性能を集団として評価しています。個別候補の仕様適合や工程品質をAD判定だけで保証しません。予測区間やアクティブラーニングを追加する場合も、ADの代替とはせず、異なる情報として利用します。
12.よくある実装ミスとチェックリスト
- 学習・調整・最終評価に同一バッチが混ざっていないか。
- 標準化・特徴量選択に評価用データを使っていないか。
- 学習側の近傍距離から自分自身を除外したか。
- 重複測定で近傍が埋まっていないか。
- しきい値を調整したデータで最終性能を報告していないか。
- AD内の件数・採用割合・RMSE・MAEを併記したか。
- 定数だった変数の変化や未知カテゴリーを別途確認したか。
- AD外を実行不能・低性能と取り違えていないか。
- モデル更新時にAD・前処理も更新し、版を記録したか。
AD内なのに予測が外れるのはなぜですか?
入力にない材料状態、測定ばらつき、モデルの偏りなどは、近傍距離だけでは検出できません。ADは利用判断の補助であり、全予測の正しさを保証しません。
距離が近いほど必ず誤差が小さくなりますか?
必ずではありません。独立評価で関係が弱ければ、特徴量、距離、対象群、予測モデルを見直します。距離の計算ができたことと、有効なADを設定できたことは別です。
データが少ない場合は三分割できません
系列・バッチを考慮した交差検証や入れ子の交差検証を検討します。ただし、前処理やADの計算も各学習集合に閉じ込めます。単純な三分割のコードをそのまま流用して、数件の評価から境界を断定しないでください。少数データでの機械学習も参考になります。
まとめ:ADを計算し、誤差との対応まで確認する
実務で重要なのは、ADスコアを出すだけでなく、モデルと同じ入力・前処理で計算し、調整と最終評価を分け、採用割合と予測誤差を確認することです。まずk近傍距離で新候補の近い試料を調べ、AD内外の実測誤差を比較してください。その結果から、利用できる領域と追加実験が必要な領域を具体化できます。
参考文献・公式資料
研究室資料は2026年10月6日参照。コード・追加図表は2026年10月9日更新。概念・手法の根拠を以下に示します。コード、合成データ、誤差基準、図表は編集部作成で、金子研究室のコードを転載したものではありません。
- 金子弘昌/明治大学データ化学工学研究室. モデルの適用範囲・モデルの適用領域(Applicability Domain, AD).
- 同研究室. 内挿・外挿は、モデルの適用範囲内・適用範囲外と違いますので注意が必要です.
- 同研究室. モデルの適用範囲はモデルを構築した特徴量xで設定しよう!.
- 同研究室. モデルの適用範囲の手法やハイパーパラメータの選び方.
- scikit-learn developers. StandardScaler.
- scikit-learn developers. NearestNeighbors.
- scikit-learn developers. OneClassSVM.