
この記事で学べること
- 実験装置、LIMS、データベースの役割と、CSV・API・SiLA 2の選び方
- 測定結果を試料に結び付けるIDと、列名・単位・日時の決め方
- Pythonで測定CSVを検証し、SQLiteへ保存する手順
- 同じCSVの再処理と、実際に測り直した結果を区別する方法
- 問題のある行を保留し、原データと登録履歴を残す方法
- LIMSへ渡す承認待ちのJSONを作り、実接続に必要な確認を整理する方法
「装置からCSVは出せる。でも、結果を試料台帳へ転記する作業が残る」「同じファイルを取り込むと、測定件数が増えてしまう」。こうした課題は、装置と情報システムの間の小さな処理から改善できます。
最初の目標は、すべての装置を一度につなぐことではありません。一つの測定CSVについて、試料ID、単位、必須項目を確認し、原ファイルと登録履歴を残すところから始めましょう。本記事では、仮想の粉体試料の質量測定を題材に、読者がPythonで一連の処理を動かせる形にします。
実機を動かすコードや、市販LIMSへ送信するコードは含みません。まず測定後の結果連携をローカルで試し、実接続へ進む際の確認事項も説明します。実験自動化の全体像は、実験自動化とは?導入手順・装置連携・データ基盤・費用対効果を参照してください。
1.装置・LIMS・データベースは何を担当するか
三つの役割を分けると、連携の目的が見える
実験装置は、測定や操作を行い、値、波形、画像、実行ログなどを出力します。LIMSはLaboratory Information Management Systemの略で、試料、測定依頼、進捗、結果、承認などを管理する情報システムです。データベースは、記録を整理して保存し、条件を指定して取り出す仕組みです。
この三つは、必ず別製品で用意するという意味ではありません。LIMSの内部でデータベースを使うこともあり、製品によって管理範囲は異なります。重要なのは、「試料の正しいIDを誰が決めるか」「結果の正本はどこか」「研究者の確認はどこに残るか」を決めることです。
| 役割 | 今回の教材での対応 | 実務で確認すること |
|---|---|---|
| 装置の結果出力 | 仮想の測定CSV | 出力項目、単位、測定完了の通知 |
| 試料の管理 | samples.csvの簡単な試料台帳 | 試料IDの発行元、派生試料の扱い |
| 取込処理 | Pythonの検証と変換 | 登録条件、保留理由、再処理の規則 |
| 結果の保存 | SQLiteのlab.db | 履歴、アクセス権、復元方法 |
| LIMSへの受け渡し | ローカルのJSON候補ファイル | 製品のAPI、認証、受領確認、承認機能 |
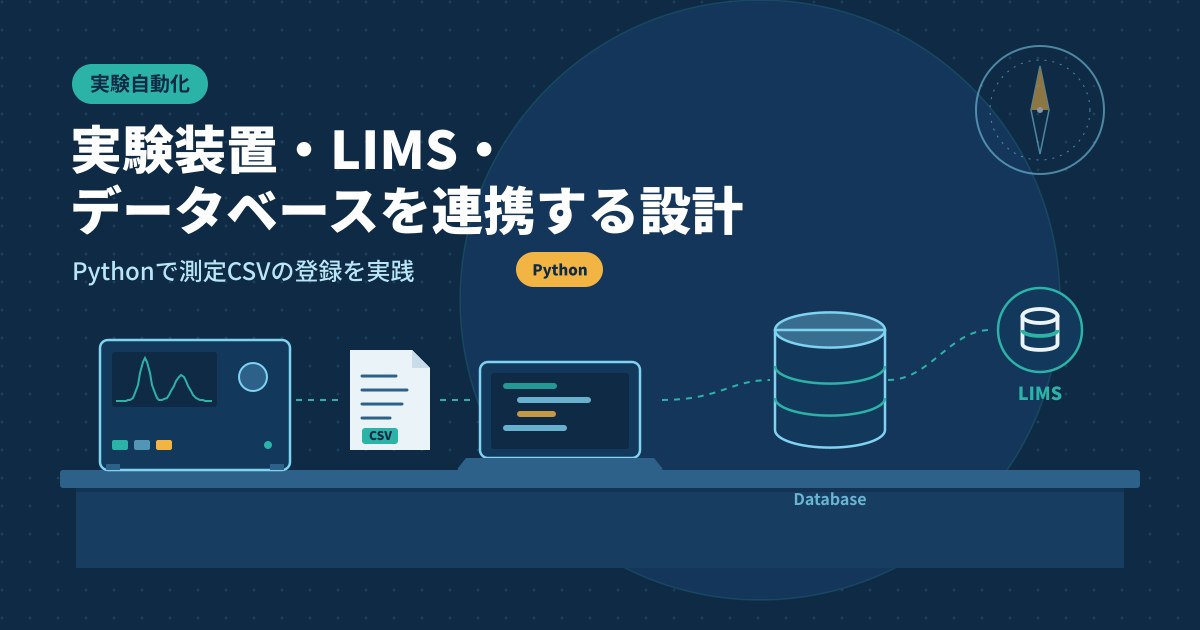
装置・取込処理・DB・LIMSの役割図を下に示します。教材で作るのは、測定CSVを確認してDBへ登録し、JSON候補を出す部分です。

結果の連携と装置制御の違い
測定結果を読み取ることと、装置に測定開始や分注の命令を出すことは分けて考えます。結果の再取り込みなら二重登録を防ぐ処理が中心になります。一方、操作命令の再送は、同じ試料へ二回分注するなど、物理的な影響を起こす可能性があります。
今回の教材では、装置の操作命令を再送しません。結果の受け渡しを小さく完成させる利点は、実機の操作条件を変更せずに、IDやデータ形式の問題を見つけやすいことです。後から装置制御を加える場合は、装置状態、実行済みかどうか、停止と復旧の条件を別途設計します。
2.CSV・API・SiLA 2をどう選ぶか
CSVから始める利点
CSVは表形式のデータを受け渡せるファイル形式で、既存装置が対応している場合、追加の接続開発を小さく始められます。人が開いて内容を確認しやすく、失敗した入力を手元で再現する教材にも向いています。ただし、区切り文字、文字コード、引用符などの違いがあるため、出力形式を固定します。Pythonのcsvモジュールは、列名をキーにした読み込みを提供しています。[1]
APIは、ソフトウェアから機能やデータへアクセスするための窓口です。たとえば「測定IDを指定して結果を取得する」という要求を送り、構造化された応答を受け取ります。ファイルを手動で移す作業を減らせますが、認証、通信失敗、取得件数の上限など、製品の仕様に合わせる必要があります。
SiLA 2は、実験装置や情報システムの共通インターフェースを目指す標準です。機能をFeatureとして表し、呼び出すCommandsや読み取るPropertiesを定義する考え方を持ちます。メーカー固有の接続処理を減らす方向に役立ちますが、必要な機能が対象装置に実装されているかの確認は残ります。[3]
| 方法 | 実務上の利点 | 選ぶときの確認 |
|---|---|---|
| CSV連携 | 既存出力を使え、内容を目視・再現しやすい | 保存完了、文字コード、列名、単位、ファイル重複 |
| メーカーAPI・SDK | 結果取得や進捗確認をプログラムへ組み込める | 対応機能、版、認証、応答、保守条件 |
| SiLA 2などの標準 | 共通の機能定義で装置連携を設計しやすい | 対応Feature、必要な項目、ネットワークと認証 |
CSVが使える装置一台で転記を減らしたいなら、ファイル連携が取り組みやすい入口です。即時の進捗確認や複数装置の順序制御が必要になれば、APIや標準対応を検討します。方法の名前だけで採用せず、対象装置とやりたい処理を一つずつ対応付けましょう。
通信の共通化と、データの意味の共通化
接続できても、値の意味が一致するとは限りません。ある装置がmg、別の装置がgを出す場合、通信が成功しただけでは比較できません。試料ID、測定項目、単位、手順の版を受け渡す規則が必要です。
SiLAのサイトに掲載された2026年の公開文書も、通信層の標準と構造化データのモデルを組み合わせる方向を示しています。これは連携設計についての提言であり、特定の導入による工数削減率を実証する資料としては扱いません。[6]
3.取り込み前に決めるデータの約束
試料ID・実行ID・測定IDを混同しない
試料IDは「何を測ったか」、実行IDは「どの実行に含まれたか」、測定IDは「どの一回の測定記録か」を識別します。同じ試料を測り直しても、試料IDは同じですが、測定IDは新しくします。これにより、再測定を二重登録と誤認しにくくなります。
本例は一回の測定に質量が一つという簡単な構造に限定します。測定IDは教材内で重複しないものとします。装置ごとに番号が1から始まる場合は、その番号だけを共通IDに使えません。装置IDと番号を組み合わせる、上位システムで別のIDを発行するなどの規則を決めます。
列名・単位・日時・手順の版
データ契約とは、受け渡す項目と規則の取り決めです。「valueに数値が入る」だけでは足りません。何の値か、単位は何か、欠測をどう書くか、時刻のタイムゾーンは何かまで決めます。
| CSVの列 | 意味・教材での規則 | 例 |
|---|---|---|
| measurement_id | 一つの質量測定を識別、必須 | M001 |
| sample_id | 台帳に存在する試料ID | S001 |
| run_id | 測定実行のID、必須 | R001 |
| device_id | 装置ID、必須 | BAL001 |
| measured_at | 測定時刻、タイムゾーン必須 | 2026-10-01T09:00:00+09:00 |
| method_version | 測定手順の版、必須 | weigh-v1 |
| property | この教材はmassのみ | mass |
| value | 有限の数値、質量は0以上 | 120 |
| unit | この教材はmgまたはg | mg |
教材は列名と列順を固定します。実装では、装置の出力形式をこの表へ変換する小さな処理を、検証より前に置いても構いません。ただし、知らない列や単位を自動で推測して通す方法は避けます。形式の変更は、変換処理の版と一緒に管理しましょう。
数値に変換できることと、測定として妥当であることも違います。コードの0以上という確認は、質量の簡単な入力規則です。ブランク補正で負の値が意味を持つ測定や、別の物性にはそのまま適用しません。装置IDと手順の版は空欄を防ぐだけで、校正状態や正式な手順の有効性まで照合していません。
4.Pythonで測定CSVを読み、検証する
動かす前に、入力と出力を把握する
完全版スクリプトは、Python標準ライブラリだけで動きます。追加のpipインストールは不要です。動作確認はPython 3.12.14で行いました。まずlab_data_integration.pyを作業用フォルダーに置き、次を実行します。
python lab_data_integration.py --demo初回にはlab_resultsフォルダーを作り、demo_inputsの中へ測定CSV、試料台帳samples.csv、出力完了を模擬するready.jsonを生成します。rawには入力CSVの保管用コピー、lab.dbには登録結果と履歴、last_report.jsonには今回の集計、lims_candidates.jsonにはLIMSへ渡す模擬の候補が残ります。
仮想入力は5行です。M001はS001の120 mg、M002はS002の0.25 g、M003は未知の試料ID、M004は未知の単位、M005は数値の空欄です。実材料や装置から取得した値ではなく、正常と異常の処理を試すために編集部が用意した教材です。
必須項目、台帳、単位を確認する
CSVから読んだ値は文字列なので、空欄を確認してから数値へ変換します。NaNや無限大なども、この教材の質量値としては保留します。試料IDが台帳にない行は、未知の試料を自動作成せず、担当者が確認する対象にします。
120 mgをgへ変える計算は、120×0.001=0.120 gです。コードではDecimalを使って変換し、元の値と単位も記録に残します。DBの検索用数値は浮動小数点なので、厳密な十進数の文字列は記録のpayloadにも保持します。表示桁数は測定の有効数字や装置精度とは別に決める必要があります。
factors = {"g": Decimal("1"), "mg": Decimal("0.001")}
value_g = Decimal(row["value"]) * factors[row["unit"]]
これは単位変換部分の抜粋です。完全版では、対応する単位、必須値、測定項目、有限値を先に確認します。入力が0なら0として扱い、空欄とは区別します。教材上の数値の上限も設けていますが、秤の測定範囲や科学的な合否判定を意味する値ではありません。
保存完了を確認する仕組み
ファイルがフォルダーに現れた直後に読むと、まだ途中までしか書かれていない場合があります。本例は、出力側が完了後に作る情報をready.jsonで模擬し、CSVのSHA-256と行数が一致してから読み込みます。SHA-256はファイルのバイト内容から計算する値で、ここでは想定した内容と一致するかの確認に使います。
この仕組みだけで「装置の測定が終わった」と判断できるわけではありません。実務では装置の完了通知や、書き込み終了後のファイル名変更など、出力側の契約が必要です。教材のmake_demoが作る完了情報は、実装を試すための代用品です。出力中のファイルへ取込側が完了情報を付けても、完了を証明したことにはなりません。
5.原データを残してSQLiteへ保存する
原ファイルと登録した値を分ける
SQLiteは、専用のサーバーを用意せず、ファイルとしてデータベースを扱えるため、一人で試す小さな教材に使いやすい選択肢です。Pythonのsqlite3から接続し、SQLという問い合わせの言語で登録・検索します。[2]
教材では、原ファイルをrawへ保存し、その内容のハッシュと保管先をfiles表に記録します。measurements表には検証を通った測定値を置きます。imports表は取込実行の履歴、events表は各行が正常、重複、保留になった理由です。
原ファイルとDBは別々なので、DBへ登録できなかった場合にも原ファイルが残ることがあります。これは調査のために残す設計であり、両者が必ず同時に更新される仕組みではありません。また、ハッシュはファイルの真正性や測定者の本人確認を保証する電子署名ではありません。
結果と試料の関係をもっと広く設計する方法は、研究開発データベースの設計で説明しています。本例はその入口として、取込処理と履歴の扱いを実際に動かします。
トランザクションで途中の登録を残さない
トランザクションとは、複数のDB更新を一つのまとまりとして確定または取り消す仕組みです。たとえば測定結果を登録した後、履歴の登録に失敗した場合、測定結果だけが残ると追跡しにくくなります。同じトランザクション内に入れれば、その処理全体を戻せます。
Pythonのsqlite3では、適切なトランザクション設定で接続をwith文に使うと、例外がなければ確定し、例外が発生すれば取り消します。ただし、with文だけで接続が閉じられるわけではなく、closeも必要です。完全版ではfinallyで接続を閉じています。[2]
with con:
    con.execute("INSERT INTO measurements VALUES(?,?,?,?,?,?,?,?)", values)
    con.execute("INSERT INTO events VALUES(?,?,?,?,?)", event)
この抜粋では、二つの登録を同じまとまりに置いています。実際の完全版はファイル一件の処理をまとめます。SQLへ値を渡すときは、文字列をつなげず、?の位置へパラメータとして渡します。[2]
必須値がないなど、想定した入力不備は行を保留して履歴を残します。一方、DB処理の途中失敗はファイル全体の更新を取り消します。取り消し後には、失敗した取込の記録を別のトランザクションで残します。DBそのものが書き込めない故障では、失敗履歴の保存も保証できず、外部の実行ログや監視が必要になります。
完全なPythonコードを表示(保存名:lab_data_integration.py)
"""Local, single-process CSV integration tutorial. No instrument/LIMS connection."""
from pathlib import Path
from datetime import datetime, timezone
from decimal import Decimal, InvalidOperation
import argparse, csv, hashlib, io, json, sqlite3, uuid

FIELDS=['measurement_id','sample_id','run_id','device_id','measured_at',
        'method_version','property','value','unit']
FACTORS={'g':Decimal('1'),'mg':Decimal('0.001')}

def dump(path,obj):
    path.write_text(json.dumps(obj,ensure_ascii=False,indent=2),encoding='utf-8')

def make_demo(folder):
    folder.mkdir(parents=True,exist_ok=True)
    base={'run_id':'R001','device_id':'BAL001','measured_at':'2026-10-01T09:00:00+09:00',
          'method_version':'weigh-v1','property':'mass'}
    rows=[dict(base,measurement_id='M001',sample_id='S001',value='120',unit='mg'),
          dict(base,measurement_id='M002',sample_id='S002',value='0.25',unit='g'),
          dict(base,measurement_id='M003',sample_id='UNKNOWN',value='100',unit='mg'),
          dict(base,measurement_id='M004',sample_id='S001',value='1',unit='unknown'),
          dict(base,measurement_id='M005',sample_id='S001',value='',unit='mg')]
    with (folder/'measurements.csv').open('w',encoding='utf-8',newline='') as f:
        w=csv.DictWriter(f,fieldnames=FIELDS);w.writeheader();w.writerows(rows)
    (folder/'samples.csv').write_text('sample_id\nS001\nS002\n',encoding='utf-8')
    seal(folder/'measurements.csv',folder/'ready.json')

def seal(source,ready):
    # Educational producer-side completion manifest; not a detector of device completion.
    blob=source.read_bytes()
    rows=list(csv.DictReader(io.StringIO(blob.decode('utf-8-sig'),newline='')))
    dump(ready,{'sha256':hashlib.sha256(blob).hexdigest(),'row_count':len(rows)})

def read_input(source,ready):
    blob=source.read_bytes();digest=hashlib.sha256(blob).hexdigest()
    info=json.loads(ready.read_text(encoding='utf-8'))
    if info.get('sha256')!=digest:raise ValueError('Completion manifest hash mismatch')
    reader=csv.DictReader(io.StringIO(blob.decode('utf-8-sig'),newline=''),strict=True)
    if reader.fieldnames!=FIELDS:raise ValueError('Unexpected columns/order')
    rows=list(reader)
    if type(info.get('row_count')) is not int or info['row_count']!=len(rows) or not rows:
        raise ValueError('Completion manifest row count mismatch or empty CSV')
    return blob,digest,rows

def known_samples(path):
    with path.open(encoding='utf-8-sig',newline='') as f:
        reader=csv.DictReader(f)
        if reader.fieldnames!=['sample_id']:raise ValueError('Invalid sample registry header')
        rows=list(reader)
        if any(set(r)!= {'sample_id'} or not r.get('sample_id') or not r['sample_id'].strip() for r in rows):
            raise ValueError('Malformed/blank sample registry row')
        ids=[r['sample_id'].strip() for r in rows]
    if not ids or len(ids)!=len(set(ids)):raise ValueError('Empty/duplicate sample registry')
    return set(ids)

def validate(row,samples):
    if set(row)!=set(FIELDS) or any(v is None for v in row.values()):raise ValueError('Malformed CSV row')
    row={k:v.strip() for k,v in row.items()}
    if any(not row[k] for k in FIELDS):raise ValueError('Missing required value')
    if row['sample_id'] not in samples:raise ValueError('Unknown sample ID')
    if row['property']!='mass':raise ValueError('Only mass is supported')
    if row['unit'] not in FACTORS:raise ValueError('Unsupported unit')
    try:value=Decimal(row['value'])
    except InvalidOperation:raise ValueError('Non-numeric value')
    if not value.is_finite() or value<0:raise ValueError('Nonfinite/negative mass')
    stamp=datetime.fromisoformat(row['measured_at'].replace('Z','+00:00'))
    if stamp.tzinfo is None or stamp.utcoffset() is None:raise ValueError('Timezone is required')
    row['measured_at']=stamp.astimezone(timezone.utc).isoformat()
    value_g=value*FACTORS[row['unit']]
    if value_g>Decimal('1e12'):raise ValueError('Outside tutorial numeric limit')
    row['value_g']=str(value_g)
    return row

def connect(path):
    con=sqlite3.connect(path)
    con.execute('PRAGMA foreign_keys=ON')
    con.executescript('''
    CREATE TABLE IF NOT EXISTS files(hash TEXT PRIMARY KEY, path TEXT NOT NULL);
    CREATE TABLE IF NOT EXISTS imports(id TEXT PRIMARY KEY, source TEXT, hash TEXT,
        created_at TEXT, status TEXT, reason TEXT);
    CREATE TABLE IF NOT EXISTS measurements(id TEXT PRIMARY KEY, sample_id TEXT,
        run_id TEXT, device_id TEXT, measured_at TEXT, value_g REAL,
        payload TEXT NOT NULL, raw_hash TEXT REFERENCES files(hash));
    CREATE TABLE IF NOT EXISTS events(import_id TEXT REFERENCES imports(id),
        row_number INTEGER, status TEXT, reason TEXT, input_json TEXT);
    ''')
    return con

def ingest(source,ready,samples_path,out,fail_after=None):
    out.mkdir(parents=True,exist_ok=True);(out/'raw').mkdir(exist_ok=True)
    attempt=str(uuid.uuid4());con=connect(out/'lab.db');digest=None
    try:
        blob,digest,rows=read_input(source,ready);samples=known_samples(samples_path)
        raw=out/'raw'/(digest+'.csv')
        if raw.exists() and raw.read_bytes()!=blob:raise ValueError('Raw snapshot mismatch')
        if not raw.exists():raw.write_bytes(blob)
        counts={'accepted':0,'duplicate':0,'held':0};events=[]
        with con:
            con.execute('INSERT OR IGNORE INTO files VALUES(?,?)',(digest,str(raw)))
            con.execute('INSERT INTO imports VALUES(?,?,?,?,?,?)',
                (attempt,str(source),digest,datetime.now(timezone.utc).isoformat(),'committed',''))
            for number,row in enumerate(rows,start=2):
                status='held';reason=''
                try:
                    item=validate(row,samples);payload=json.dumps(item,sort_keys=True,ensure_ascii=False)
                    previous=con.execute('SELECT payload FROM measurements WHERE id=?',
                                         (item['measurement_id'],)).fetchone()
                    if previous:
                        if previous[0]!=payload:raise ValueError('Measurement ID content conflict')
                        status='duplicate';reason='Same measurement, unchanged content'
                    else:
                        con.execute('INSERT INTO measurements VALUES(?,?,?,?,?,?,?,?)',
                            (item['measurement_id'],item['sample_id'],item['run_id'],item['device_id'],
                             item['measured_at'],float(item['value_g']),payload,digest))
                        status='accepted';reason='Format checks passed; not scientific approval'
                except (ValueError,InvalidOperation) as e:reason=str(e)
                counts[status]+=1
                con.execute('INSERT INTO events VALUES(?,?,?,?,?)',
                    (attempt,number,status,reason,json.dumps(row,ensure_ascii=False)))
                events.append({'row':number,'measurement_id':row.get('measurement_id'),
                               'status':status,'reason':reason})
                if fail_after==number-1:raise RuntimeError('Injected database failure')
        report={'import_id':attempt,'input_rows':len(rows),**counts,'database_measurements':
                con.execute('SELECT count(*) FROM measurements').fetchone()[0],'events':events}
        return report
    except Exception as e:
        # The failed import transaction is already rolled back; record failure separately.
        with con:
            con.execute('INSERT INTO imports VALUES(?,?,?,?,?,?)',
                (attempt,str(source),digest,datetime.now(timezone.utc).isoformat(),'failed',str(e)))
        raise
    finally:con.close()

def export_candidates(out):
    # Local candidate JSON; never represents a LIMS acknowledgment or human approval.
    con=sqlite3.connect(out/'lab.db')
    try:
        records=[]
        for mid,payload,digest in con.execute('SELECT id,payload,raw_hash FROM measurements ORDER BY id'):
            item=json.loads(payload)
            records.append({'measurement_id':mid,'sample_id':item['sample_id'],'run_id':item['run_id'],
                'device_id':item['device_id'],'measured_at':item['measured_at'],
                'method_version':item['method_version'],'property':'mass','value':item['value_g'],
                'unit':'g','raw_sha256':digest,'review_status':'pending'})
        dump(out/'lims_candidates.json',{'schema_version':'tutorial-v1','destination':'local_mock_only','records':records})
    finally:con.close()

def main():
    parser=argparse.ArgumentParser();parser.add_argument('--demo',action='store_true')
    parser.add_argument('--input');parser.add_argument('--ready');parser.add_argument('--samples')
    parser.add_argument('--output',default='lab_results');args=parser.parse_args();out=Path(args.output)
    if args.demo:
        if any([args.input,args.ready,args.samples]):parser.error('Do not combine demo with input paths')
        make_demo(out/'demo_inputs');args.input=str(out/'demo_inputs'/'measurements.csv')
        args.ready=str(out/'demo_inputs'/'ready.json');args.samples=str(out/'demo_inputs'/'samples.csv')
    if not all([args.input,args.ready,args.samples]):parser.error('Use --demo or specify all three input paths')
    report=ingest(Path(args.input),Path(args.ready),Path(args.samples),out)
    export_candidates(out);dump(out/'last_report.json',report);print(json.dumps(report,ensure_ascii=False,indent=2))

if __name__=='__main__':main()
6.再処理と再測定を区別する
同じ入力を二回処理しても、測定件数を増やさない
冪等性という用語は、「同じ処理を繰り返しても、登録結果が増えたり変わったりしない性質」と考えると分かりやすくなります。本例では測定IDを一意にし、同じIDの内容が同じならduplicateとして履歴だけを追加します。
同じコマンドを二回実行した結果は、次の通りでした。最初の実行から同じ出力フォルダーを使った場合の比較です。
| 実行 | 新規登録 accepted | 重複 duplicate | 保留 held | DBの測定件数 |
|---|---|---|---|---|
| 初回 | 2 | 0 | 3 | 2 |
| 二回目 | 0 | 2 | 3 | 2 |
測定件数は2件のままですが、実行履歴は増えます。「データが増えない」とは、監査のための履歴まで消すことではありません。last_report.jsonは最新実行の集計で上書きされますが、DBのimportsとeventsには過去の処理も残ります。
同じ測定IDで内容が変わった場合
M001の120 mgを121 mgに変え、同じ測定IDで取り込むと、内容の競合として保留します。既存値を黙って書き換えません。原因は、測定値の訂正、試料の取り違え、ファイル編集など、複数考えられるためです。
コードは時刻をUTCへ統一した後、記録全体を比較します。元の値や単位も比較に含むので、120 mgを0.120 gに書き換えた場合も、自動で同一と判断する仕組みではありません。これは教材の保守的な規則です。実務では、訂正が必要なときの新しい版と、元記録への参照、承認者を管理します。
| 入力の状態 | 本例の扱い | 担当者の次の作業 |
|---|---|---|
| 新しい測定IDで形式確認に合格 | acceptedとして登録 | 測定の妥当性を確認する |
| 既存IDで記録内容が同じ | duplicate、測定件数は増やさない | 再処理が意図どおりか確認 |
| 既存IDで記録内容が違う | held、既存値を維持 | 訂正・再測定・取り違えを調べる |
| 未知の試料ID・単位・欠損 | held、理由を記録 | 台帳や出力定義を確認 |
実際に測り直したなら、新しい測定IDにして登録します。同じ試料IDでM001とM006が存在しても、それ自体は重複ではありません。反復測定と独立した試料の数も、後の解析では区別する必要があります。
7.LIMSへ渡す情報を作る
JSONは項目名と値の組で読む
JSONは、項目名と値を組にしてデータを表す形式です。CSVが行と列の表に向くのに対し、JSONは一つの測定に付随する情報をまとめて受け渡す形を表しやすくなります。今回のlims_candidates.jsonは、DBの登録値をgへそろえて出力します。
{
  "measurement_id": "M001",
  "sample_id": "S001",
  "property": "mass",
  "value": "0.120",
  "unit": "g",
  "review_status": "pending"
}
これは出力項目の一部です。完全版では装置ID、実行ID、測定時刻、手順の版、原ファイルのハッシュも含みます。精密な十進表現を保つため、valueは文字列で出します。受け渡し先が数値型を要求するなら、その仕様に合わせて変換します。
登録候補と承認済みを分ける
pendingは、この教材では承認待ちを意味します。acceptedは取込時の形式確認に合格したという意味で、研究者が結果を承認したことではありません。また、JSONが作れたことはLIMSが受領したことでもありません。ファイルにはlocal_mock_onlyという出力先の表示を入れています。
出力するのは、今回新規登録した値だけでなく、DB内の全登録候補です。同じJSONを実システムへ送る場合には、送信先でも重複を防ぐキーと受領済み記録が必要になります。ローカルDBの取込が冪等でも、外部システムの登録まで自動的に冪等になるわけではありません。
実接続では、APIの登録項目、ID対応、認証方法、権限、エラー応答、タイムアウト時の受領確認、訂正履歴を確認します。DBへの保存と外部送信は別の処理なので、送信失敗を再開する仕組みも必要です。本例は通信を行わず、まず渡す情報を具体化するところまでを扱います。
自分のCSVで実行する場合
入力形式をそろえ、出力が完了したCSVと完了情報、試料台帳を指定します。原データのコピーで試し、既存の本番DBとは別の出力フォルダーを使ってください。
python lab_data_integration.py --input measurements.csv --ready ready.json --samples samples.csv --output my_lab_resultsready.jsonを実運用で誰がいつ作るかは、装置の出力完了の仕組みに合わせます。手動エクスポートで試す際には、出力が終わったことを確認した後、完全版に含まれるseal関数で教材形式の完了情報を作れます。
from pathlib import Path
from lab_data_integration import seal
seal(Path("measurements.csv"), Path("ready.json"))
これはファイルのハッシュと行数を書き出すだけで、未知の装置の完了状態を検知する機能ではありません。教材では、この区別を保ったまま、後から実際の完了通知へ置き換えます。
8.公開例から、実装の考え方を学ぶ
材料研究データ:NIMSのRDEToolKit
NIMSは2025年8月1日の案内で、RDEToolKitを、RDEの構造化処理をPythonで組み立てるツールとして紹介しています。データの分類、メタデータ付与、用語の変換、CSVからJSONへの形式変換、可視化、特徴量抽出などを、複数ステップの処理として扱います。[4]
参考になるのは、単にファイルを保存するだけでなく、研究データとして扱える形へ整える処理を分けて設計している点です。今回の教材でも、読み込み、検証、単位変換、保存、受け渡しを分けます。ただし、教材はRDEToolKitを実装したものでも、RDEへ接続するものでもありません。
測定装置:Opentronsのプレートリーダー
Opentronsの公式資料では、吸光プレートリーダーの測定結果を、アプリの実行履歴からCSVとして取得する方法が示されています。測定結果を装置の画面で見るだけでなく、外へ取り出して処理する公開例です。[5]
プレート測定には、試料IDだけでなく、プレートとウェル位置を試料へ結ぶ対応表も必要になります。これは質量一つの教材より複雑な構造です。装置のCSVをそのまま本コードへ入れられると考えず、列、測定項目、位置情報を調べてから変換してください。
材料、装置、製薬の測定で形式は違っても、結果と対象試料の対応を残す考え方は共通です。連携基盤ができれば、次の条件を選ぶ自律実験・Self-driving Labにもつなげやすくなります。その場合も、解析へ渡す結果が適切かという確認は残します。
9.失敗例・導入チェックリスト・FAQ
失敗したときは、何を保留するか
書き込み途中のCSVは、完了情報と一致しないため、DBへ登録しません。列名・列順・行数の不一致もファイル単位の失敗です。この段階ではrawへのコピー前に止まるので、元の入力ファイルを調査用に保管します。一方、読み取れた行の未知IDや未知単位は、原ファイルと保留理由を残します。
保留行を削除して正常行だけで評価すると、失敗しやすい試料や装置の問題が見えなくなることがあります。保留率、理由、装置や手順の偏りも確認しましょう。入力定義や測定条件の整理には、材料データの品質を高める方法が役立ちます。
原ファイルにハッシュを付けても、保存場所に変更権限があれば、管理者がファイルを書き換えられる可能性は残ります。実務ではアクセス権、保管方針、バックアップ、復元確認を合わせます。教材の履歴も、改ざん防止を備えた正式な監査証跡ではありません。
技術的限界と責任範囲
本コードは一人がローカルで順に実行する教材です。複数人の同時処理、通信断からの自動復旧、権限管理、電子署名、正式な承認機能は実装していません。DB保存後のJSON出力に失敗した場合は、DBを消してやり直さず、候補出力を再生成するなど、段階ごとの状態を確認します。
形式の検証は、測定値が正しいこと、秤が校正されていること、試料が物理的に正しくセットされたことを保証しません。担当者は測定の妥当性を確認し、情報システムの担当者は保存・受け渡し・復旧の成立を確認します。量産の合否や出荷判断へ用いる場合は、既存の承認手順と必要な妥当性確認を維持します。
導入チェックリスト
- 減らしたい転記作業と、最初の対象装置一台を決めた
- 試料ID・実行ID・測定IDの発行元と重複範囲を決めた
- 出力項目、単位、欠測、タイムゾーン、手順の版を定義した
- ファイル保存完了を判断する出力側の仕組みを確認した
- 正常、欠損、未知の単位、重複、内容変更を試した
- 途中失敗でDB更新が戻り、理由を追跡できることを確認した
- 原ファイルと登録した値の対応をたどれる
- 登録候補と研究者の承認済みを区別している
- 保留時の担当者、修正方法、バックアップと復元を決めた
FAQ
Q.LIMSがなくても始められますか?
始められます。本例はCSV台帳とSQLiteを使い、取込処理を試します。件数や利用者が増えた段階で、依頼管理、承認、権限など必要な機能を整理してLIMSを検討します。教材を完成させればLIMSが不要という意味ではありません。
Q.古い装置でも使えますか?
安定したCSV出力があれば、変換処理を作れる可能性があります。独自形式や画面出力しかない場合は、メーカーの対応機能と利用条件を確認します。最初は人が出力完了を確認する形でも、結果の取り違えや転記を減らす設計を試せます。
Q.同じ試料の再測定は、重複になりますか?
新しい測定IDを発行すれば別の測定として残せます。同じ試料という理由で結果をまとめたり、前の値を上書きしたりしません。再測定の理由と元の測定への参照は、実運用へ進む際に追加します。
Q.正常行だけ登録してよいですか?
本例は行ごとに検証して正常行を登録し、保留理由を残します。プレート全体や一連の実行全体の整合性が必要な場合は、一行の不備で実行全体を保留する規則が適切なこともあります。独立した一件として扱える単位を先に決めてください。
まとめ
装置と情報システムの連携は、一つのCSVの項目を決め、検証し、原データと履歴を残すところから具体化できます。CSV連携は小さく試しやすく、APIやSiLA 2は必要な機能に合わせて段階的に検討できます。
教材では、新規登録、重複、内容変更、入力不備、途中失敗を分けて扱いました。次は対象装置の出力と台帳を使い、同じ規則でどこまで処理できるかを確認します。測定としての妥当性と登録処理の成功を区別し、人の承認へ渡せる記録を作ることが、安定した自動化への入口になります。
参考文献
[1]Python Software Foundation. csv — CSV File Reading and Writing. Python公式ドキュメント、継続更新。https://docs.python.org/3/library/csv.html (2026年10月9日確認)
[2]Python Software Foundation. sqlite3 — DB-API 2.0 interface for SQLite databases. Python公式ドキュメント、継続更新。https://docs.python.org/3/library/sqlite3.html (2026年10月9日確認)
[3]SiLA Consortium. Standards. SiLA公式資料、継続更新。https://sila-standard.com/standards/ (2026年10月9日確認)
[4]物質・材料研究機構(NIMS). RDEの構造化処理フローを手軽に構築できる「RDEToolKit」のご案内. 2025年8月1日。https://dice.nims.go.jp/news/2025/08/20250801.html (2026年10月9日確認)
[5]Opentrons. Using Plate Reader Data. 公式ドキュメント、継続更新。https://docs.opentrons.com/absorbance-plate-reader/data/ (2026年10月9日確認)
[6]SiLA公式サイト掲載. The Strategic Necessity of Open Standards in Lab Automation: A Mandatory Requirement for Connected Labs. Version 1.0、2026年の公開文書。https://sila-standard.com/wp-content/uploads/2026/07/Letter-of-Intent-on-Open-Standards-for-Life-Sciences_firstSignatures.pdf (2026年10月9日確認)
上記は公式技術資料・公開文書で、DOIの付与は確認されていません。コードと仮想データは編集部作成の教材です。