
実験データは共有フォルダーにある。結果はExcelにまとめている。それでも、半年前の試料を探すと、作製条件と測定ファイルの対応が分からない。同じ名前の材料を集めたら、別バッチの試料と繰り返し測定が混ざっていた――研究開発では、このような「保存できているのに使えない」問題が起こります。
研究開発データベースの設計で最初に決めるのは、製品名やサーバーの容量ではありません。何を再利用したいのか、何を一つの記録とするのか、実験・試料・測定をどう結びつけるのかです。その上で、原ファイル、解析履歴、権限、更新責任を整えます。
本記事では、Excelの表を理解できる方を対象に、IDの付け方から、Pythonでの作成・登録・検索・CSV出力までを解説します。SQLは本文の例で読み方を学べます。Pythonコードは標準ライブラリだけで動かす小さな学習用例です。薄膜・粉末の条件や数値は編集部の仮想例であり、公開研究の成果とは区別します。
この記事で学べること
- Excel・共有フォルダーとデータベースの役割の違い
- 組成・作製バッチ・試料・測定・ファイルを分け、IDで結びつける設計
- PythonとSQLiteで登録ルールを設定し、不正な参照を防ぐ方法
- 未測定の試料を残して集計し、解析用CSVへ取り出す方法
- 原ファイル・再解析の履歴と、Excel移行時の確認事項
まず第1〜4章で設計を理解し、第5章のコードを動かし、第6章で出力を読みます。既存データへの応用は第7〜9章で扱います。
1.研究データベースとは何か:Excel・フォルダーとの違い
ファイルがあることと、研究データを取り出せることは違う
例えば「薄膜Aの結果.xlsx」という名前だけでは、どの試料を測ったのか、膜厚がどの作製条件に対応するのか、解析をやり直した結果なのかを判断できません。担当者が覚えている間は使えても、異動や時間の経過で意味が失われます。
再利用には、結果そのものに加え、対象・条件・方法・由来を示す情報が必要です。こうしたデータを説明する情報をメタデータと呼びます。FAIR原則は研究データの再利用を支える指針であり、人だけでなく機械による発見・利用も重視しています。[1]本記事では、その考え方を「他の人や解析プログラムが、必要なデータを見つけ、意味を理解して取り出せるか」という設計上の問いに置き換えます。
最初に覚えたい五つの用語
| 用語 | 意味 | 本記事での例 |
|---|---|---|
| テーブル | 同じ種類の記録を集めた表 | 試料一覧、測定一覧 |
| 行・レコード | 表の中の一つの記録 | 試料S001の記録 |
| 列・フィールド | 記録する項目 | 試料ID、膜厚、測定日時 |
| スキーマ | 表・項目・関係・制約の設計 | 測定はどの試料に属するか |
| ID | 記録を区別する識別子 | sample_id = S001 |
データベースは、整理したデータを検索・更新・管理する仕組みです。関係データベースでは、複数の表をキーで結びつけます。最初から専用システムを使わなくても、Excelの複数シートで関係を試作できます。ただし、Excelの手作業だけでは、参照先の存在確認や複数人の更新、アクセス制御を継続して守る負担が増えます。
Excel・フォルダー・データベースは何が違う?
| 仕組み | 主な役割 | この薄膜例では |
|---|---|---|
| 共有フォルダー | 原ファイルを保管する | 装置ファイル・測定画像を保存 |
| Excel | 人が表を見て入力・集計する | 研究記録の確認、設計の試作 |
| 関係データベース | 記録の関係と登録ルールを管理する | 測定がどの試料・作製に属するかを検索 |
| SQL | データベースへの処理を記述する言葉 | 条件に合う測定を選び、表を結合する |
Excelでも複数シートをIDで関連付けられます。データベースを使う利点は、その対応を検索のたびに手で探す負担を減らし、存在しない試料への登録などを制約で防げることです。原ファイルの保管領域や入力画面は、別途組み合わせて使います。
同じ情報を何度も書くと、修正が難しくなる
測定M001とM002の行へ、作製P001の温度198℃をそれぞれコピーしたとします。温度記録の訂正時に片方だけを199℃へ直すと、同じ作製なのに二つの条件が残ります。作製条件をP001の一行にまとめ、測定からIDでたどる設計なら、作製記録を一か所で訂正できます。訂正理由や変更履歴は別途残します。
このように、情報の持ち主となる表へ分けることを正規化と呼びます。保存時は関係を保ち、解析時は必要な情報を一枚の表へ取り出します。スキーマは構造と制約、データ辞書は項目の意味・単位・運用ルールを説明するものです。
2.再利用したい問いと「1行の意味」を決める
検索したい問いから逆算する
設計の出発点として、実際に答えたい問いを三つ程度書き出します。これは編集部の進め方の提案であり、必要数の標準ではありません。
- 同じ組成でも、作製バッチによって膜厚や特性が変わるか。
- ある粉末試料のX線回折データを、元の測定条件までたどれるか。
- 解析方法を変更したとき、旧結果と新結果を比較できるか。
一つ目には組成・作製実験・試料・特性の関係、二つ目には測定ID・装置・原ファイル、三つ目には解析実行の識別と履歴が必要です。「将来役立ちそうな項目を全部集める」より、必要な検索を実際に成立させるほうが、入力負担と設計の不足を判断しやすくなります。
材料名・バッチ・物理的な試料・測定を区別する
同じ組成の材料でも、別の日に作製したバッチが同じ状態とは限りません。また、一つのバッチから切り出した複数片は、別々に測定しても作製履歴を共有します。区別の基準を次のように置きます。
| 対象 | 何を識別するか | 仮想例 |
|---|---|---|
| 材料・組成 | 共通する材料の定義 | 組成C01 |
| 作製実験・バッチ | 一回の作製や工程のまとまり | 作製P001 |
| 試料 | 実際に保管・処理・測定する物 | 薄膜片S001、S002 |
| 測定 | 一回の測定実行 | 膜厚測定M001、M002 |
何を一つの試料とするかは研究対象で変わります。粉末を分取する場合、元の粉末と分取後の試料を区別し、親試料IDを残す方法があります。測定が破壊的な場合や熱処理で状態が変わる場合には、状態・処理履歴も必要です。IDだけ付けて、変化前後を混同しないことが大切です。
測定数は独立した試料数ではない
同じ薄膜片S001を二回測った結果が98 nmと102 nmだったとします。測定記録は二件ですが、物理的な試料は一つです。さらにS001とS002が同じ作製実験から得られたなら、試料二つが独立した作製実験二回を意味するわけでもありません。
機械学習用の表を取り出す際は、試料・バッチ・測定のどの単位を一行にするかを決めます。繰り返し測定を平均するか、測定ごとにモデル化するかは目的に応じて判断し、平均値だけを残して原記録を捨てない設計にします。バッチをまたいで予測したいなら、分割に使えるバッチIDを保持することも必要です。
3.組成・作製・試料・測定・ファイルをIDで結びつける
主キーと外部キーの仕組み
主キーは、表の各行を一意に識別するキーです。例えば試料表のsample_idを主キーにすれば、S001という記録を重複登録しないようにできます。外部キーは、別の表にある記録を参照するためのキーです。測定表のsample_idから試料表を参照し、存在しない試料への測定登録を防ぐ設計ができます。これらの制約は、PostgreSQLの公式文書でも定義されています。[2]
IDは、後から変更される材料名や担当者名だけに依存させないのが実務上のポイントです。「A試料」を改名しても、S001という識別と過去の関連は維持します。複数拠点で発番するなら、拠点を含む発番規則やUUIDなど、衝突を避ける方式も検討します。
最小構成を五つの表で試す
以下は、一回の薄膜作製から二つの試料を得て測定する仮想例です。説明用に項目を絞っています。
組成表:1行=一つの組成定義
| composition_id | label |
|---|---|
| C01 | 仮想薄膜組成A |
C01は説明用の組成ラベルです。実データでは構成成分・組成比・基準を定義し、必要なら成分明細表を追加します。
作製実験表:1行=一回の作製実験
| preparation_id | composition_id | 設定温度(℃) | 実測温度(℃) |
|---|---|---|---|
| P001 | C01 | 200 | 198 |
| P002 | C01 | 200 | 203 |
試料表:1行=一つの物理的な試料
| sample_id | preparation_id | 試料の説明 |
|---|---|---|
| S001 | P001 | 作製P001から得た薄膜片1 |
| S002 | P001 | 作製P001から得た薄膜片2 |
| S003 | P002 | 別の作製から得た薄膜片 |
測定表:1行=一回の測定実行
| measurement_id | sample_id | 測定項目 | 値 | 単位 |
|---|---|---|---|---|
| M001 | S001 | 膜厚 | 98 | nm |
| M002 | S001 | 膜厚 | 102 | nm |
| M003 | S002 | 膜厚 | 101 | nm |
ファイル表:1行=一つのファイル
| file_id | measurement_id | 種類 | 保管先の例 |
|---|---|---|---|
| F001 | M001 | 装置原ファイル | 管理ストレージ内のF001 |
| F002 | M001 | 測定画像 | 管理ストレージ内のF002 |
| F003 | M002 | 装置原ファイル | 管理ストレージ内のF003 |
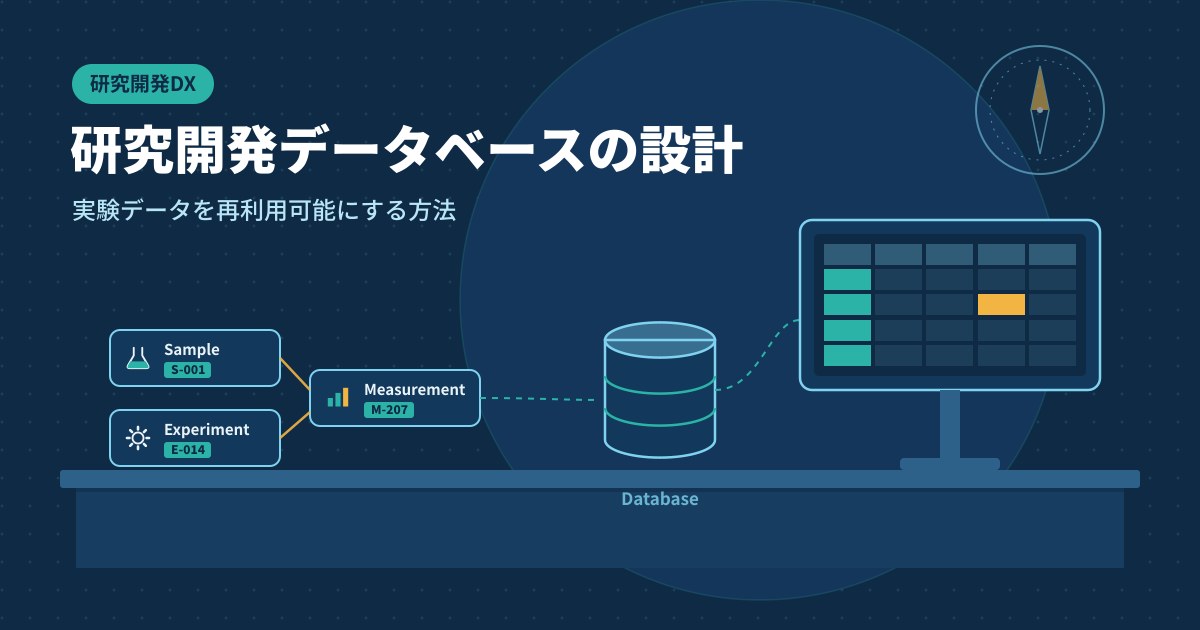
表の関係は、作製実験P001 → 試料S001・S002 → 測定M001・M002・M003 → 各測定のファイルです。測定M001からsample_idを見ればS001に戻り、preparation_idからP001の温度条件へ戻れます。データを全部同じ行へコピーしなくても、関係をたどれます。
ここでは測定一回につき一つの値で説明しました。現実の一回の測定から複数の特性値が得られる場合は、「測定実行」と「結果項目」の表を分けます。共通する作製条件を複数行に手入力しないことで、修正漏れによる矛盾も減らせます。これは情報を適切に分ける正規化の考え方です。ただし、解析時には目的に合う平らな表へ取り出して構いません。
拡張例:多対多の関係には対応表を使う
複数の原料試料を混合し、複数の生成物を得る実験は、単純な一本の親子関係では表せません。その場合は「実験ID・試料ID・役割・使用量」を持つ対応表を用意し、入力試料と出力試料を結びつけます。役割を入力・出力などに分ければ、同じ試料が別の実験で使用される履歴も記録できます。
最小例のpreparation_idは、一つの作製実験に属する試料を説明するための簡略化です。多段階処理、混合、分取、複数測定をまとめたファイルには、対応表や工程履歴を追加します。最初から万能なモデルを作る必要はありませんが、実際の関係を無理に一対一にしないことが重要です。
表を結合すると行数が増えることがある
S001に膜厚測定が二件、表面粗さ測定が三件あるとします。この二つの測定表をsample_idだけで結合すると、2×3=6行になります。試料が六つに増えたわけでも、六組の対応した測定が得られたわけでもありません。
同時測定の対応があるなら、その対応を示すIDを使います。対応がないなら、目的に応じて各表を試料単位に集約してから結合するか、別の測定記録として扱います。結合前後の行数、試料数、重複キーを確認し、集計によって意味が変わっていないか点検します。
関係と件数を対応させる
| 参照元の表と列 | 参照先の表と列 | 関係 |
|---|---|---|
| preparations.composition_id | compositions.composition_id | 一つの組成に複数の作製 |
| samples.preparation_id | preparations.preparation_id | 一つの作製に複数の試料 |
| measurements.sample_id | samples.sample_id | 一つの試料に複数の測定 |
| files.measurement_id | measurements.measurement_id | 一つの測定に複数のファイル |
コードでは表名を英語の複数形にし、作製IDをすべてpreparation_idへ統一します。測定・ファイルがまだない場合でも、試料そのものを登録できます。粉末の混合では、例えば対応表に「P010・S010・入力・2 g」「P010・S011・入力・3 g」「P010・S012・出力・4.8 g」を記録します。役割と量の単位を分け、一回の作製に一つの試料だけを押し込めない設計にします。
4.データ辞書・単位・欠測・登録ルールを決める
項目名だけでなく、意味と入力ルールを残す
「温度」という列名だけでは、設定温度、試料温度、室温のどれか分かりません。データ辞書は、項目の意味と取り扱いを共有するための説明書です。
| 項目名 | 定義 | 型・単位 | 入力ルールの例 |
|---|---|---|---|
| sample_id | 物理的な試料の識別子 | 文字列 | 必須、重複不可 |
| temperature_set_c | 作製装置の設定温度 | 数値・℃ | 実測値と分ける |
| temperature_actual_c | 定義したセンサーの実測温度 | 数値・℃ | センサーと集計方法を記録 |
| measured_at | 測定の実行日時 | 日時 | タイムゾーンを明示 |
| result_status | 結果の取得状態 | 選択肢 | 実行記録はvalid、failed、unknown。未測定の予定は別管理 |
| method_version | 測定・解析手順の版 | 文字列 | 参照できる手順に対応 |
数値の欄へ「100nm」と「0.1μm」を混在させるより、値と単位を分け、保存単位と変換規則を決めたほうが比較しやすくなります。一方、変換前の元の値・単位も必要に応じて保持します。単位が統一されても、測定法が異なる結果を無条件に比較できるわけではありません。
未測定・測定失敗・不明を区別する
膜厚が空欄のとき、未測定なのか、測定に失敗したのか、過去の記録を失ったのかで意味が違います。値は欠測のまま残し、状態を別の項目で示す方法があります。失敗理由や装置のエラーコードも追えるようにすると、再測定の判断に使えます。
ゼロは測定値として意味を持ち得るため、欠測をゼロで埋めないルールにします。詳細な欠損値・外れ値の判断は、材料データの品質を高める方法で解説しています。
共通項目と測定法ごとの項目を分ける
試料ID・測定日時・手順の版は共通化しやすい一方、X線回折の走査条件と顕微鏡の撮影条件を同じ項目に押し込むと意味が曖昧になります。共通部分と装置・手法別の項目を分け、項目を追加した際にはスキーマや辞書の版も残します。
予定条件と実施条件も分けます。設定温度200℃と実測温度198℃は、どちらかが誤りとは限りません。実測温度が時間平均なのか到達時点の値なのかまで定義すると、後の比較で解釈がぶれにくくなります。
コードで守るルールと、現場で確認するルール
| ルール | 設定 | 守れること |
|---|---|---|
| IDの重複を禁止 | PRIMARY KEY | 同じ表に同じIDを登録しない |
| 必須項目を欠測にしない | NOT NULL | 参照IDなどのNULLを防ぐ |
| 参照先が存在する | REFERENCES | 未登録試料への測定登録を防ぐ |
| 状態・値・単位が整合する | CHECK | 有効結果の値なし、膜厚の単位違いを防ぐ |
このコードは膜厚をnmで保存し、非負の数値だけを認めます。負の値が意味を持つ別の物性へ広げる場合は、この制約をそのまま使わず、測定項目ごとに設計します。SQLiteの通常の表は型名だけでは厳密な数値型を保証しないため、valueに数値型を確認するCHECKも付けています。
measured_atにはタイムゾーン付きISO 8601文字列を保存します。サンプルは同じ日時を使っていますが、実際には各測定の日時を記録します。日時の形式、センサーの定義、手順書の実在、試料の取り違えは、この最小コードの制約では確認しません。入力・取込処理と研究者の照合が必要です。
この例では、S003が未測定と分かっているため測定行を作りません。ただし実運用で「行がない」ことだけから未測定とは断定できません。登録漏れや履歴不明もあり得ます。測定予定・進捗の表を設けてnot_measuredを管理し、実行した記録ではvalid/failed/unknownを区別する方法があります。
5.PythonとSQLiteでデータベースを作る
SQLiteは、サーバーを別に立てず、ファイルで扱えるデータベースです。Pythonのsqlite3から作成・登録・検索できます。[5]まず手元の仮想データで設計を試す用途に使います。組織全体の同時更新や権限管理は、第9章の製品・運用選定で検討します。
実行方法と生成されるファイル
Python 3.10以降を想定します。追加パッケージのインストールは不要です。以下の全コードをresearch_database.pyとしてUTF-8で保存し、保存したフォルダーで実行します。
python research_database.pyresearch_db_demoという新しいフォルダーにresearch.db、schema.sql、sample_summary.csv、sample_lineage.csvを作ります。再実行時は既存フォルダーを上書きしません。別名を指定して実行してください。
python research_database.py --out research_db_demo_2ファイル表のdemo-storage/F001.datなどは、保管先の説明用文字列です。原ファイル本体は生成しておらず、存在・閲覧権限・チェックサムの検査も行いません。
作成・登録・検索・出力まで動く全コード
"""薄膜の仮想例。標準ライブラリのみ。既存DBを上書きしない。"""
import argparse
import csv
import sqlite3
from pathlib import Path

SCHEMA = """
CREATE TABLE compositions (
 composition_id TEXT PRIMARY KEY NOT NULL CHECK(length(trim(composition_id)) > 0),
 label TEXT NOT NULL
);
CREATE TABLE preparations (
 preparation_id TEXT PRIMARY KEY NOT NULL,
 composition_id TEXT NOT NULL REFERENCES compositions(composition_id),
 temperature_set_c REAL NOT NULL,
 temperature_actual_c REAL
);
CREATE TABLE samples (
 sample_id TEXT PRIMARY KEY NOT NULL,
 preparation_id TEXT NOT NULL REFERENCES preparations(preparation_id),
 description TEXT NOT NULL
);
CREATE TABLE measurements (
 measurement_id TEXT PRIMARY KEY NOT NULL,
 sample_id TEXT NOT NULL REFERENCES samples(sample_id),
 property TEXT NOT NULL,
 value REAL,
 unit TEXT NOT NULL,
 method_version TEXT NOT NULL,
 measured_at TEXT NOT NULL,
 result_status TEXT NOT NULL CHECK(result_status IN ('valid','failed','unknown')),
 failure_reason TEXT,
 CHECK((result_status = 'valid' AND value IS NOT NULL)
    OR (result_status IN ('failed','unknown') AND value IS NULL)),
 CHECK(value IS NULL OR (typeof(value) IN ('real','integer') AND value >= 0)),
 CHECK(result_status != 'failed' OR
       (failure_reason IS NOT NULL AND length(trim(failure_reason)) > 0)),
 CHECK(property != 'thickness' OR unit = 'nm')
);
CREATE TABLE files (
 file_id TEXT PRIMARY KEY NOT NULL,
 measurement_id TEXT NOT NULL REFERENCES measurements(measurement_id),
 file_kind TEXT NOT NULL,
 location TEXT NOT NULL UNIQUE
);
CREATE INDEX idx_measurements_sample ON measurements(sample_id);
CREATE INDEX idx_files_measurement ON files(measurement_id);
"""

SUMMARY_SQL = """
WITH eligible AS (
 SELECT sample_id, AVG(value) AS mean_thickness_nm,
        COUNT(*) AS n_valid
 FROM measurements
 WHERE property = 'thickness' AND unit = 'nm'
   AND method_version = ? AND result_status = 'valid'
 GROUP BY sample_id
), attempts AS (
 SELECT sample_id, COUNT(*) AS n_records,
        SUM(CASE WHEN result_status = 'failed' THEN 1 ELSE 0 END) AS n_failed
 FROM measurements
 WHERE property = 'thickness' AND unit = 'nm' AND method_version = ?
 GROUP BY sample_id
)
SELECT s.sample_id, p.preparation_id, p.composition_id,
       p.temperature_set_c, p.temperature_actual_c,
       e.mean_thickness_nm, COALESCE(e.n_valid, 0) AS n_valid,
       COALESCE(a.n_records, 0) AS n_records,
       COALESCE(a.n_failed, 0) AS n_failed
FROM samples AS s
JOIN preparations AS p ON p.preparation_id = s.preparation_id
LEFT JOIN eligible AS e ON e.sample_id = s.sample_id
LEFT JOIN attempts AS a ON a.sample_id = s.sample_id
ORDER BY s.sample_id
"""

LINEAGE_SQL = """
SELECT s.sample_id, p.preparation_id, p.composition_id,
       m.measurement_id, m.result_status, m.value, m.unit,
       f.file_id, f.file_kind, f.location
FROM samples AS s
JOIN preparations AS p ON p.preparation_id = s.preparation_id
LEFT JOIN measurements AS m ON m.sample_id = s.sample_id
LEFT JOIN files AS f ON f.measurement_id = m.measurement_id
WHERE s.sample_id = ?
ORDER BY m.measurement_id, f.file_id
"""

def register_demo(conn):
    with conn:
        conn.execute('INSERT INTO compositions VALUES (?, ?)', ('C01', '仮想薄膜組成A'))
        conn.executemany('INSERT INTO preparations VALUES (?, ?, ?, ?)',
                         [('P001', 'C01', 200, 198), ('P002', 'C01', 200, 203)])
        conn.executemany('INSERT INTO samples VALUES (?, ?, ?)',
                         [('S001', 'P001', '薄膜片1'), ('S002', 'P001', '薄膜片2'),
                          ('S003', 'P002', '別バッチの薄膜片・この例では未測定')])
        records = [
            ('M001', 'S001', 98, 'valid', None),
            ('M002', 'S001', 102, 'valid', None),
            ('M003', 'S002', 101, 'valid', None),
            ('M004', 'S002', None, 'failed', '信号取得失敗')]
        conn.executemany('INSERT INTO measurements VALUES (?, ?, ?, ?, ?, ?, ?, ?, ?)',
            [(mid, sid, 'thickness', val, 'nm', 'thickness-v1',
              '2026-10-01T10:00:00+09:00', status, reason)
             for mid, sid, val, status, reason in records])
        conn.executemany('INSERT INTO files VALUES (?, ?, ?, ?)', [
            ('F001', 'M001', 'raw', 'demo-storage/F001.dat'),
            ('F002', 'M001', 'image', 'demo-storage/F002.png'),
            ('F003', 'M002', 'raw', 'demo-storage/F003.dat')])


def expect_rejection(conn, label, sql, params):
    try:
        with conn:
            conn.execute(sql, params)
    except sqlite3.IntegrityError as exc:
        print(f'登録拒否確認: {label}: {exc}')
    else:
        raise AssertionError(f'制約が効いていません: {label}')


def export_csv(conn, sql, params, path):
    cursor = conn.execute(sql, params)
    rows = cursor.fetchall()
    with path.open('w', encoding='utf-8-sig', newline='') as fp:
        writer = csv.writer(fp)
        writer.writerow([column[0] for column in cursor.description])
        writer.writerows(rows)
    return rows


def main():
    parser = argparse.ArgumentParser()
    parser.add_argument('--out', default='research_db_demo')
    args = parser.parse_args()
    out = Path(args.out)
    # 新規ディレクトリだけを受け付ける。再実行時は別の名前を指定する。
    out.mkdir(parents=True, exist_ok=False)
    conn = sqlite3.connect(out / 'research.db')
    try:
        conn.execute('PRAGMA foreign_keys = ON')
        assert conn.execute('PRAGMA foreign_keys').fetchone()[0] == 1
        conn.executescript(SCHEMA)
        register_demo(conn)
        expect_rejection(conn, '重複試料ID', 'INSERT INTO samples VALUES (?, ?, ?)',
                         ('S001', 'P001', '重複'))
        expect_rejection(conn, '存在しない作製ID', 'INSERT INTO samples VALUES (?, ?, ?)',
                         ('S999', 'P999', '参照先なし'))
        bad = ('M999', 'S999', 'thickness', 100, 'nm', 'thickness-v1',
               '2026-10-01T10:00:00+09:00', 'valid', None)
        insert = 'INSERT INTO measurements VALUES (?, ?, ?, ?, ?, ?, ?, ?, ?)'
        expect_rejection(conn, '存在しない試料ID', insert, bad)
        bad = ('M999', 'S001', 'thickness', None, 'nm', 'thickness-v1',
               '2026-10-01T10:00:00+09:00', 'valid', None)
        expect_rejection(conn, '有効結果なのに値なし', insert, bad)
        bad = ('M999', 'S001', 'thickness', 100, 'um', 'thickness-v1',
               '2026-10-01T10:00:00+09:00', 'valid', None)
        expect_rejection(conn, '膜厚の保存単位が違う', insert, bad)
        summary = export_csv(conn, SUMMARY_SQL, ('thickness-v1', 'thickness-v1'),
                             out / 'sample_summary.csv')
        lineage = export_csv(conn, LINEAGE_SQL, ('S001',), out / 'sample_lineage.csv')
        assert len(summary) == 3
        assert [(r[0], r[5], r[6]) for r in summary] == [
            ('S001', 100.0, 2), ('S002', 101.0, 1), ('S003', None, 0)]
        assert summary[1][7:] == (2, 1)
        assert len(lineage) == 3  # M001はファイル2件、M002は1件。
        assert conn.execute('PRAGMA foreign_key_check').fetchall() == []
        assert conn.execute('PRAGMA integrity_check').fetchone()[0] == 'ok'
        print('SQLite:', sqlite3.sqlite_version)
        print('試料集計:', summary)
        print('保存先:', out.resolve())
        (out / 'schema.sql').write_text(SCHEMA, encoding='utf-8')
    finally:
        conn.close()

if __name__ == '__main__':
    main()
コードの読み方
SCHEMAのCREATE TABLEで表を定義します。register_demoは、親に当たる組成・作製から順に登録し、with conn内の一連の登録をまとめて確定します。途中の登録が失敗すれば、そのブロックをロールバックします。executeの?には値を別引数で渡すため、検索語をSQL文字列へ直接つなぎません。[5]
外部キーは、接続直後にPRAGMA foreign_keys = ONで有効化します。別のプログラムや接続でも、その接続ごとに設定・確認します。トランザクション途中の切替に頼らないでください。[6]
expect_rejectionは、重複試料ID、未登録の作製・試料への参照、有効結果なのに値なし、膜厚の保存単位違い、の五つを意図的に試し、拒否を確認します。実データの取込では、エラーを黙って捨てず、元の行番号・値・理由を記録して確認します。
コードでは、S002の失敗した再測定M004を追加しました。有効測定3件と失敗1件を区別し、失敗の値はNULL、理由は「信号取得失敗」として残します。失敗を膜厚ゼロとして平均に混ぜません。
6.SQLで検索し、解析用CSVを出力する
①試料ごとの平均を、未測定試料も含めて取り出す
SUMMARY_SQLは、最初に測定項目・単位・手順の版・有効状態を絞り、試料単位に集計します。その後で全試料へLEFT JOINします。JOINは対応する表を結びつける処理、LEFT JOINは左側の記録を対応先がなくても残す処理です。
WITH eligible AS (
 SELECT sample_id, AVG(value) AS mean_thickness_nm,
        COUNT(*) AS n_valid
 FROM measurements
 WHERE property = 'thickness' AND unit = 'nm'
   AND method_version = ? AND result_status = 'valid'
 GROUP BY sample_id
), attempts AS (
 SELECT sample_id, COUNT(*) AS n_records,
        SUM(CASE WHEN result_status = 'failed' THEN 1 ELSE 0 END) AS n_failed
 FROM measurements
 WHERE property = 'thickness' AND unit = 'nm' AND method_version = ?
 GROUP BY sample_id
)
SELECT s.sample_id, p.preparation_id, p.composition_id,
       p.temperature_set_c, p.temperature_actual_c,
       e.mean_thickness_nm, COALESCE(e.n_valid, 0) AS n_valid,
       COALESCE(a.n_records, 0) AS n_records,
       COALESCE(a.n_failed, 0) AS n_failed
FROM samples AS s
JOIN preparations AS p ON p.preparation_id = s.preparation_id
LEFT JOIN eligible AS e ON e.sample_id = s.sample_id
LEFT JOIN attempts AS a ON a.sample_id = s.sample_id
ORDER BY s.sample_id| sample_id | preparation_id | 平均膜厚[nm] | n_valid | n_records | n_failed |
|---|---|---|---|---|---|
| S001 | P001 | 100 | 2 | 2 | 0 |
| S002 | P001 | 101 | 1 | 2 | 1 |
| S003 | P002 | NULL(欠測) | 0 | 0 | 0 |
CSVではNULLは空欄になります。n_validは採用条件を満たす測定数、n_recordsは指定した膜厚・手順の記録数、n_failedはそのうちの失敗数です。COALESCEは件数の欠測を0に変えていますが、平均膜厚の欠測は0へ変換していません。
WHEREで有効測定だけを最終結合後に絞ると、測定のないS003が消えることがあります。この例では集計側で絞ることで、試料一覧を維持しています。手順の版が同じでも、実際の測定条件や比較可能性は研究者が確認します。
②組成が同じ別バッチを一覧にする
SELECT preparation_id, temperature_set_c, temperature_actual_c
FROM preparations
WHERE composition_id = ?
ORDER BY preparation_id;
Pythonではconn.execute(sql, (‘C01’,)).fetchall()として実行します。結果はP001(設定200℃・実測198℃)とP002(設定200℃・実測203℃)です。S001とS002はP001を共有するため、独立した作製は2回です。この小さな例だけでバッチ差の統計的結論や予測性能は評価できません。
③試料から作製条件・測定・原ファイルをたどる
SELECT s.sample_id, p.preparation_id, p.composition_id,
       m.measurement_id, m.result_status, m.value, m.unit,
       f.file_id, f.file_kind, f.location
FROM samples AS s
JOIN preparations AS p ON p.preparation_id = s.preparation_id
LEFT JOIN measurements AS m ON m.sample_id = s.sample_id
LEFT JOIN files AS f ON f.measurement_id = m.measurement_id
WHERE s.sample_id = ?
ORDER BY m.measurement_id, f.file_id
S001を指定すると、M001–F001、M001–F002、M002–F003の3行が得られます。M001はファイルが2件あるため2行になります。これはファイルをたどる一覧としては正しいですが、3回測定したという意味ではありません。
④結合してから平均すると、値が変わる場合がある
SELECT AVG(m.value)
FROM measurements AS m
JOIN files AS f ON f.measurement_id = m.measurement_id
WHERE m.sample_id = 'S001' AND m.result_status = 'valid';
このSQLでは98がファイル2件分、102が1件分に増え、平均は(98+98+102)÷3=約99.33 nmになります。元の二つの測定の平均は100 nmです。ファイル数による重みが入ったためです。試料の測定平均を求める場合はSUMMARY_SQLのように測定表だけで先に集計し、ファイル一覧は別に取り出します。
機械学習用にはsample_summary.csvを使えますが、これは1行=試料の表です。preparation_idを残し、同じ作製由来の試料が学習・評価の両方に入る問題を検討します。具体的な分割は材料データの交差検証で解説しています。
7.原ファイルと解析履歴を管理する
大きなファイルと検索用の情報を分けて管理する
装置独自形式、顕微鏡画像、スペクトルなどは、ファイル保管領域に保存し、データベースにはファイルID・保管先・取得元・形式などを登録する構成が選択肢になります。DB内にファイル本体を保存する方式もありますが、容量、バックアップ、性能、アクセス方法を含めて選びます。
CSVへの変換結果だけを保存すると、装置固有の情報や再解析の可能性を失う場合があります。元のファイルを保持し、変換後のファイルと対応させます。ただし、独自形式を開くソフトウェアが将来利用できなくなる可能性もあるため、読み取り方法や汎用形式への書き出しも検討します。
解析をやり直しても履歴を失わない設計
粉末試料のX線回折データから特徴量を抽出する仮想例では、原ファイルF101に対し、解析実行A001とA002を別々に登録します。背景処理の設定を変えたら、新しい結果と処理条件を残し、以前の結果を置き換える場合にも変更履歴を保持します。
解析実行には、入力ファイルID、使用したプログラムや手順の版、パラメーター、実行日時、出力結果を結びつけます。比較に使った結果の版が分からなければ、再現性を確認できません。採用する結果には確認状態を付け、探索中の結果と区別する方法もあります。
ファイルの移動時には、ファイルIDを維持して保管先を更新します。チェックサムは内容の変化を検出する助けになりますが、取得条件の正しさを保証するものではありません。原ファイルの保存と閲覧・変更権限は、組織のルールに従って設計します。
解析実行の記録例:旧結果を上書きしない
| analysis_id | 入力file_id | program_version | parameters | 実行日時 | 結果 | 確認状態 |
|---|---|---|---|---|---|---|
| A001 | F101 | xrd-v1 | background=linear | 2026-10-01T11:00:00+09:00 | 特徴量結果R001 | 旧版・保持 |
| A002 | F101 | xrd-v2 | background=spline | 2026-10-02T11:00:00+09:00 | 特徴量結果R002 | 確認済み・採用 |
これは拡張時の概念例で、今回の五表コードには解析実行表を実装していません。追加するときはanalysis_idを主キー、input_file_idをfiles.file_idへの外部キーにします。出力先、プログラムの版、パラメーター、確認者も記録します。入力が複数なら解析と入力ファイルの対応表を作ります。
「最も新しい結果」を自動で採用すると、探索中や未確認の結果が混ざります。解析用データを作るときは採用したanalysis_idを明示し、複数の解析結果を無条件に測定へ結合しないようにします。
8.既存のExcelから移行し、取り出した結果を検証する
①問いと対象範囲を決め、②実際の記録を集める
まず、対象を一つの研究テーマや測定法に絞ります。例えば「粉末の作製バッチとX線回折の結果をつなぐ」という範囲です。正常な測定だけでなく、再測定、失敗、分取を含む記録を集めます。試作では10〜20件程度を使う方法もありますが、これは説明用の目安であり、関係の複雑さを確認できる例を選ぶほうが重要です。
③IDと関係、④データ辞書を作る
記録を作製・試料・測定・ファイルに分け、必要なら工程や対応表を追加します。IDの発番者と重複防止ルールを決め、項目の意味・単位・欠測状態を定義します。研究者が既存記録と照合し、実際の実験を表現できるか確認します。
⑤取り出しを試し、⑥移行を検証する
「試料S001の全測定と作製条件」「同じ組成の別バッチの一覧」を実際に取り出します。保存できても必要な検索が成立しなければ設計を修正します。測定がない試料も一覧に残すのかを決め、結合で消える記録がないかも確認します。
移行時は旧記録の所在、変換規則、旧IDと新IDの対応を残します。移行前後で件数・単位・状態・原ファイルの対応を比較し、曖昧な記録を推測で確定しないようにします。原資料に戻れる形で未確認状態を管理します。
⑦更新責任と復元方法を決める
項目の追加、誤記の訂正、試料の廃棄、メンバーの異動を誰が処理するかを決めます。バックアップは作成だけでなく、復元できるかを試します。移行や製品変更に備え、表だけでなく原ファイルと関係情報も取り出せることを確認します。
データ基盤は作って終わりではありません。研究開発DXの進め方とKPIと同様に、検索できる割合、登録遅延、記録不備、復元確認など、現場で使える状態を測る指標を設定します。
Excelから移すときの変換・照合例
| 元の記録 | 変換先 | 確認事項 |
|---|---|---|
| 材料名A/作製日・ロット情報 | composition_idとpreparation_id | 名前だけで同一組成・同一作製と決めない |
| 膜厚0.1 μm | value=100、unit=nm | 元値・元単位・変換規則を残す |
| 空欄 | NULLと状態 | 未測定・失敗・不明を原資料で確認 |
| 旧試料名A-1 | sample_id=S001 | 旧ID・新ID・元ファイル・シート・行を対応表で保持 |
例えば有効結果3件、失敗1件、試料3件、作製2件、ファイル登録3件という件数を取込前後で比較します。同一作製に付いた温度が旧Excel内で食い違う場合は、どちらかを黙って採用せず、原資料で確認します。対応表の例は「legacy_source=旧記録.xlsx、sheet=測定、row=12、legacy_id=A-1、sample_id=S001、verification_status=confirmed」です。
取込は一件ずつ確定せず、関連する登録をトランザクションへまとめます。完了後は外部キー検査に加えて、代表試料の条件・単位・原ファイルを人が照合します。CSV出力は検索結果の交換用であり、全表・原ファイル・解析履歴を復元できるバックアップの代わりにはなりません。
9.共同利用・製品選定・運用を整える
次の表は一般的な役割の比較です。実際の機能は製品や構成によって重なります。
| 管理方法 | 主な用途 | 選択時に確認すること |
|---|---|---|
| Excel・CSV | 小規模な表、設計の試作、交換用データ | 同時更新、入力ルール、版の混在 |
| 関係データベース | 表の関係、検索、整合性の管理 | 入力画面、保守、権限、取り出し方法 |
| ファイル保管領域 | 原ファイルや大容量データの保存 | IDとの対応、保管先変更、復元 |
| ELN(電子実験ノート) | 実験の計画・経過・考察・記録 | 自由記述と構造化データの接続 |
| LIMS(研究室情報管理システム) | 試料、測定依頼、進捗、結果の管理 | 現場の工程、装置連携、確認履歴 |
ELNは実験の文脈を残す役割、LIMSは試料や測定の流れを管理する役割を持つことが多いですが、名称だけで選ばないことが大切です。既存製品を導入するなら、代表的な実験を登録し、必要なデータを取り出せるかまで試します。
自作は研究対象に合わせやすい一方、開発者が離れた後の保守、復元、権限管理も引き受ける必要があります。ライセンス費用だけでなく、研究者の入力時間、移行、装置連携、運用担当者の負担を含めて比較します。装置から自動取得できる情報を再入力させない設計は、実験自動化の導入手順ともつながります。
公開事例から設計の考え方を学ぶ
NIMSのRDE:形式の異なる研究データを扱う
NIMSのResearch Data Express(RDE)は、研究データの蓄積・共用を支える仕組みです。2025年12月15日公開の原著論文では、データセットテンプレートでデータの記述と処理を定義し、装置の原ファイルと入力された条件を構造化する設計が示されています。メタデータの抽出、用語の変換、可視化、特徴量の計算などを扱います。[3]
重要なのは、すべての装置ファイルを一つの形式に統一するのではなく、異なる形式をどう定義し処理するかをそろえる点です。自分の研究への応用としては、「元の形式を保持する」「処理方法を明確にする」「構造化された結果から由来をたどれるようにする」という設計の考え方を参考にできます。これは編集部による設計上の解釈です。未知の装置形式まで無条件に自動解釈できると考えず、対応するテンプレートと処理の確認が必要です。[3]
Chemotion:分子と実際の試料を区別する
化学研究向けELNのChemotionを報告した2017年の論文では、分子と試料を別の表で管理する設計が説明されています。分子の構造情報に対し、試料は物理的な対象であり、純度など実験に依存する情報を持ちます。[4]
この区別は、「同じ化学構造なら同じ試料」としてしまう問題を考える手がかりになります。材料研究でも、共通する組成・構造の定義と、作製・保管・処理履歴を持つ物理的な試料を区別すると、何を比較しているかが明確になります。後者は本記事の応用上の提案であり、論文の実証成果そのものではありません。また、2017年の報告を現在の製品機能一覧や導入効果の保証には使いません。
失敗パターンと責任の分担
| 失敗 | 起こる問題 | 改善の方向 |
|---|---|---|
| 全情報を巨大な一枚の表に入れる | 繰り返し測定や工程を表せず、条件が重複 | 記録単位を分けてIDでつなぐ |
| 必須項目を増やしすぎる | 不明値に仮の数字が入る | 必須の理由と不明状態を定義 |
| 試料IDを再利用する | 過去と新規の試料が混ざる | 廃棄後もIDの対応を維持 |
| 原ファイルを残さない | 再解析や追跡ができない | 変換前後の対応を保持 |
| 保存だけを検証する | 必要な検索が成立しない | 代表的な取り出しで確認 |
データベースの制約は重複や参照先の不整合を防ぐ助けになりますが、測定対象の取り違え、装置の不調、科学的な解釈の誤りまでは保証しません。測定法の妥当性、校正、試料状態の確認は別途必要です。記録されていない条件を後から完全に復元できるわけでもありません。
責任の分担も明確にします。研究者は記録の科学的意味と確認状態、管理担当者は保存・アクセス・復元、解析担当者は抽出・結合・集計の妥当性を確認します。少人数では兼務しても構いませんが、担当が曖昧な状態は避けます。
再利用できる設計にすることと、すべてを外部公開することは別の判断です。機密区分と利用範囲を定め、閲覧権限が検索画面、出力ファイル、連携先にも反映されるかを確認します。研究データを生成AIで検索する場合も、元データの関係と権限が必要です。研究開発データにRAGを導入する設計手順では、その先の検索・評価を扱っています。
10.導入前チェックリスト・FAQ・まとめ
チェックリスト
- 再利用したい問いと対象範囲を言葉で説明できる。
- 各表の「1行の意味」が決まっている。
- 試料、作製バッチ、測定を区別し、IDが重複しない。
- 分取・混合・多段階処理の関係を表現できる。
- 項目の定義、単位、欠測状態を共有している。
- 原ファイルと解析結果の由来をたどれる。
- 結合前後の行数・試料数を確認している。
- 更新責任と権限、変更履歴が決まっている。
- バックアップからの復元とデータの取り出しを試した。
FAQ
Q.Excelでは研究データを管理できないのですか?
A.小規模な管理や設計の試作には使えます。試料・測定を別シートにし、IDと辞書を設けることから始められます。共同更新、履歴、参照の整合性を手作業で守れなくなったら、別の仕組みを検討します。
Q.SQLを学ばないと始められませんか?
A.構想段階では不要です。どの記録が何に対応するか、何を取り出したいかを説明することが先です。実装時には、製品の画面や支援担当者、必要に応じたSQLを使います。
Q.過去のデータを全部移行する必要がありますか?
A.必ずしもありません。再利用価値と移行負担で対象を選び、新規実験から運用を整える方法もあります。移行しないデータも所在を残し、未確認の履歴を確定情報に変えないようにします。
Q.データベースを作れば、すぐ機械学習に使えますか?
A.目的変数、比較条件、特徴量、分割単位を決める必要があります。データベースはそれを判断する情報を保つ基盤です。IDが整っていても、測定条件の違いや偏りを評価せず学習へ進むことはできません。
Q.誰が設計と更新に責任を持つべきですか?
A.研究者と管理・解析担当者が協働し、項目の意味、保存・権限、抽出処理の責任を分けて決めます。製品の導入担当者だけに、研究上の意味の判断まで任せない体制が必要です。
まとめ
研究開発データベースの設計は、再利用したい問いと記録の単位を決めることから始まります。材料の定義、作製実験、物理的な試料、測定を区別し、IDで結びつけます。その上で、項目の意味、原ファイル、解析履歴、権限、運用責任を整えます。
まず第5章の仮想例で、三つの試料を残してCSVを出力できることを確かめてください。その後、一つの研究テーマで、作製条件から測定結果と原ファイルまでたどれる表を作ってみてください。必要なデータを取り出し、現場の記録と一致するかを確認することが、再利用できる基盤への第一歩です。
参考文献
[1]Wilkinson, M. D., et al. (2016). The FAIR Guiding Principles for scientific data management and stewardship. Scientific Data, 3, 160018. DOI: 10.1038/sdata.2016.18. PubMed収録情報・抄録。本記事では抄録で確認できる、研究データの再利用と機械による利用を重視する考え方を参照。
[2]PostgreSQL Global Development Group. PostgreSQL 18 Documentation, 5.5 Constraints. 公式文書。主キー・外部キー等の定義を参照。DOIなし。
[3]Fujima, J., Yoshikawa, H., Nagao, H., Tosaka, H., Kadohira, T., & Demura, M. (2025). Research data express: a data accumulation and sharing system for digital transformation in materials research. Science and Technology of Advanced Materials: Methods, 5(1), 2597702. 公開日:2025年12月15日。DOI: 10.1080/27660400.2025.2597702。NIMS公開の原著論文本文を確認。RDE公式説明、NIMS掲載発表(2025年12月25日)も参照。
[4]Tremouilhac, P., Nguyen, A., Huang, Y.-C., Kotov, S., Lütjohann, D. S., Hübsch, F., Jung, N., & Bräse, S. (2017). Chemotion ELN: an Open Source electronic lab notebook for chemists in academia. Journal of Cheminformatics, 9, 54. DOI: 10.1186/s13321-017-0240-0. 出版社掲載本文。分子と試料を区別する設計を参照。
既存研究文献の確認日:2026年10月6日。追加のPython・SQLite公式文書とコードの確認日:2026年10月9日。実装手順・仮想表・チェックリストは、引用したシステムの公式仕様ではなく、編集部による設計例と提案です。
[5]Python Software Foundation. sqlite3 — DB-API 2.0 interface for SQLite databases。接続・登録・プレースホルダー・トランザクションの公式説明。
[6]SQLite. SQLite Foreign Key Support。外部キーの存在確認と接続ごとの有効化を参照。