
「実験装置を自動化すれば、AIが材料を発見してくれるのか」「次の実験を選ぶところまで任せられるのか」「研究者は何を判断すべきなのか」。自律実験・Self-driving Labを検討するときは、ロボットの導入と研究判断の自律化を分けて考える必要があります。
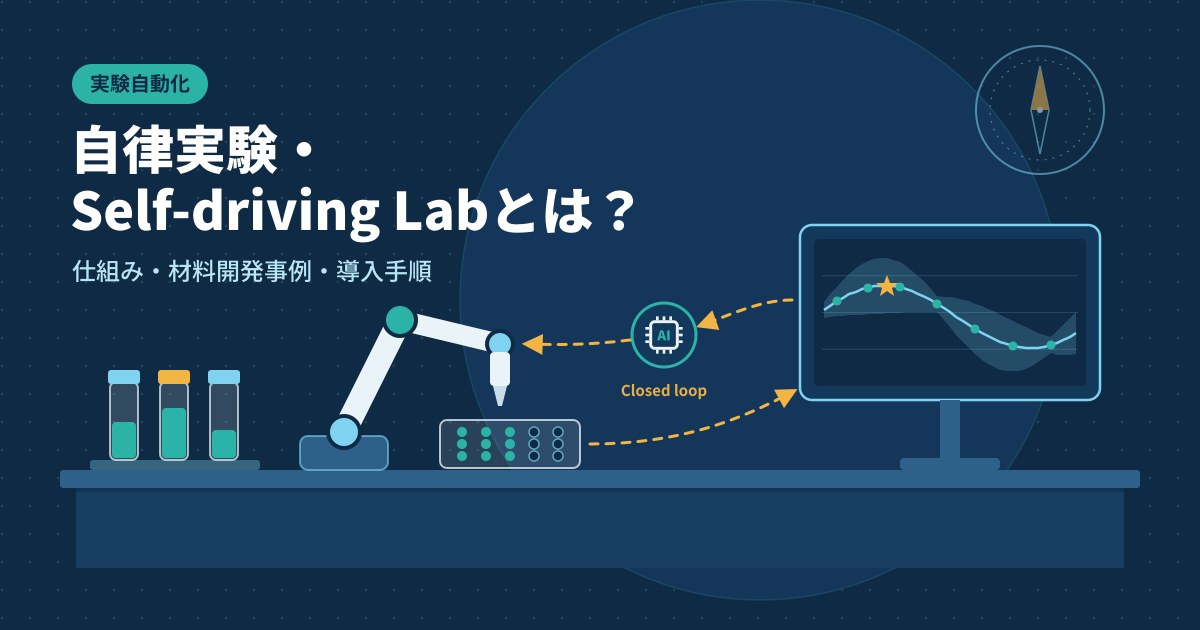
自律実験とは、実験を計画し、実行し、測定結果を解釈して、次の実験へ反映するサイクルを、定めた範囲内でシステムが継続する仕組みです。結論からいうと、その価値は単に実験数を増やすことではなく、測定結果から学び、限られた時間・試料・予算の中で有用な実験を選ぶことにあります。
ただし、目的設定、安全範囲の承認、測定の妥当性、成果の検証まで研究者の責任がなくなるわけではありません。本記事では閉ループの仕組み、公開事例、導入手順、失敗例と限界を整理します。文献の報告と編集部の実務上の提案は区別し、特定企業の未公開案件や個人の業務経験は扱いません。
この記事でわかること
本記事は、これから自律実験を検討する研究者・開発担当者向けの入門です。読み終えた後、一つの研究課題について、必要な記録・品質確認・停止条件を整理し、小さな閉ループを設計できることを目指します。
- 実験自動化・ベイズ最適化・自律実験の違い
- 閉ループに必要な機能、実験記録、状態管理
- 装置なしのPython例で、候補選択から検証・記録・停止まで試す方法
- 人が実験する段階から導入し、効果を比較・検証する方法
自律実験・Self-driving Labとは?実験自動化との違い
Self-driving Laboratory(SDL)は、一般に自動実験のハードウェアと計算による実験計画を結び付け、結果を次の計画へ返す研究基盤を指します。MacLeodらの薄膜材料研究では、材料の作製・処理・評価と、結果に応じた条件選択を繰り返すプラットフォームが示されています。[1]
実験自動化では、事前に決めた条件を装置が順番に実行することもあります。それに対して自律実験では、得られた情報によって次の条件が変わります。100条件を決めて測る方式と、最初の結果を見て残りの条件を選び直す方式の違い、と考えると理解しやすくなります。
両者は発展段階としてつながっています。自動化された測定が安定していなければ、結果を学習する仕組みも安定しません。装置接続や試料搬送などの基盤は、実験自動化の導入手順・装置連携で整理しています。本記事は、その上で「次の実験をどう決めるか」と「判断をどこまで任せるか」に焦点を当てます。
なお、自律性は有無の二択ではありません。計画のみ自動で実行は人が行う、通常条件だけ自動承認する、異常時は人が確認するなど、段階的に設計できます。研究室全体を一度に無人化する必要はなく、一つの測定系で閉ループを成立させる方が検証しやすい場合があります。
| 方式 | 次の条件を選ぶ主体 | 結果の反映 | 主な役割 |
|---|---|---|---|
| 実験自動化 | 人が事前に指定 | 必ずしも次条件に反映しない | 定型操作の反復・記録 |
| ベイズ最適化 | 計算による実験計画器 | 結果から候補を更新 | 少ない評価で目標を探索。実行は手動でもよい |
| 自律実験 | 計画器+事前に定めた承認ルール | 実行・測定・判断を接続 | 許可範囲内で閉ループを継続 |
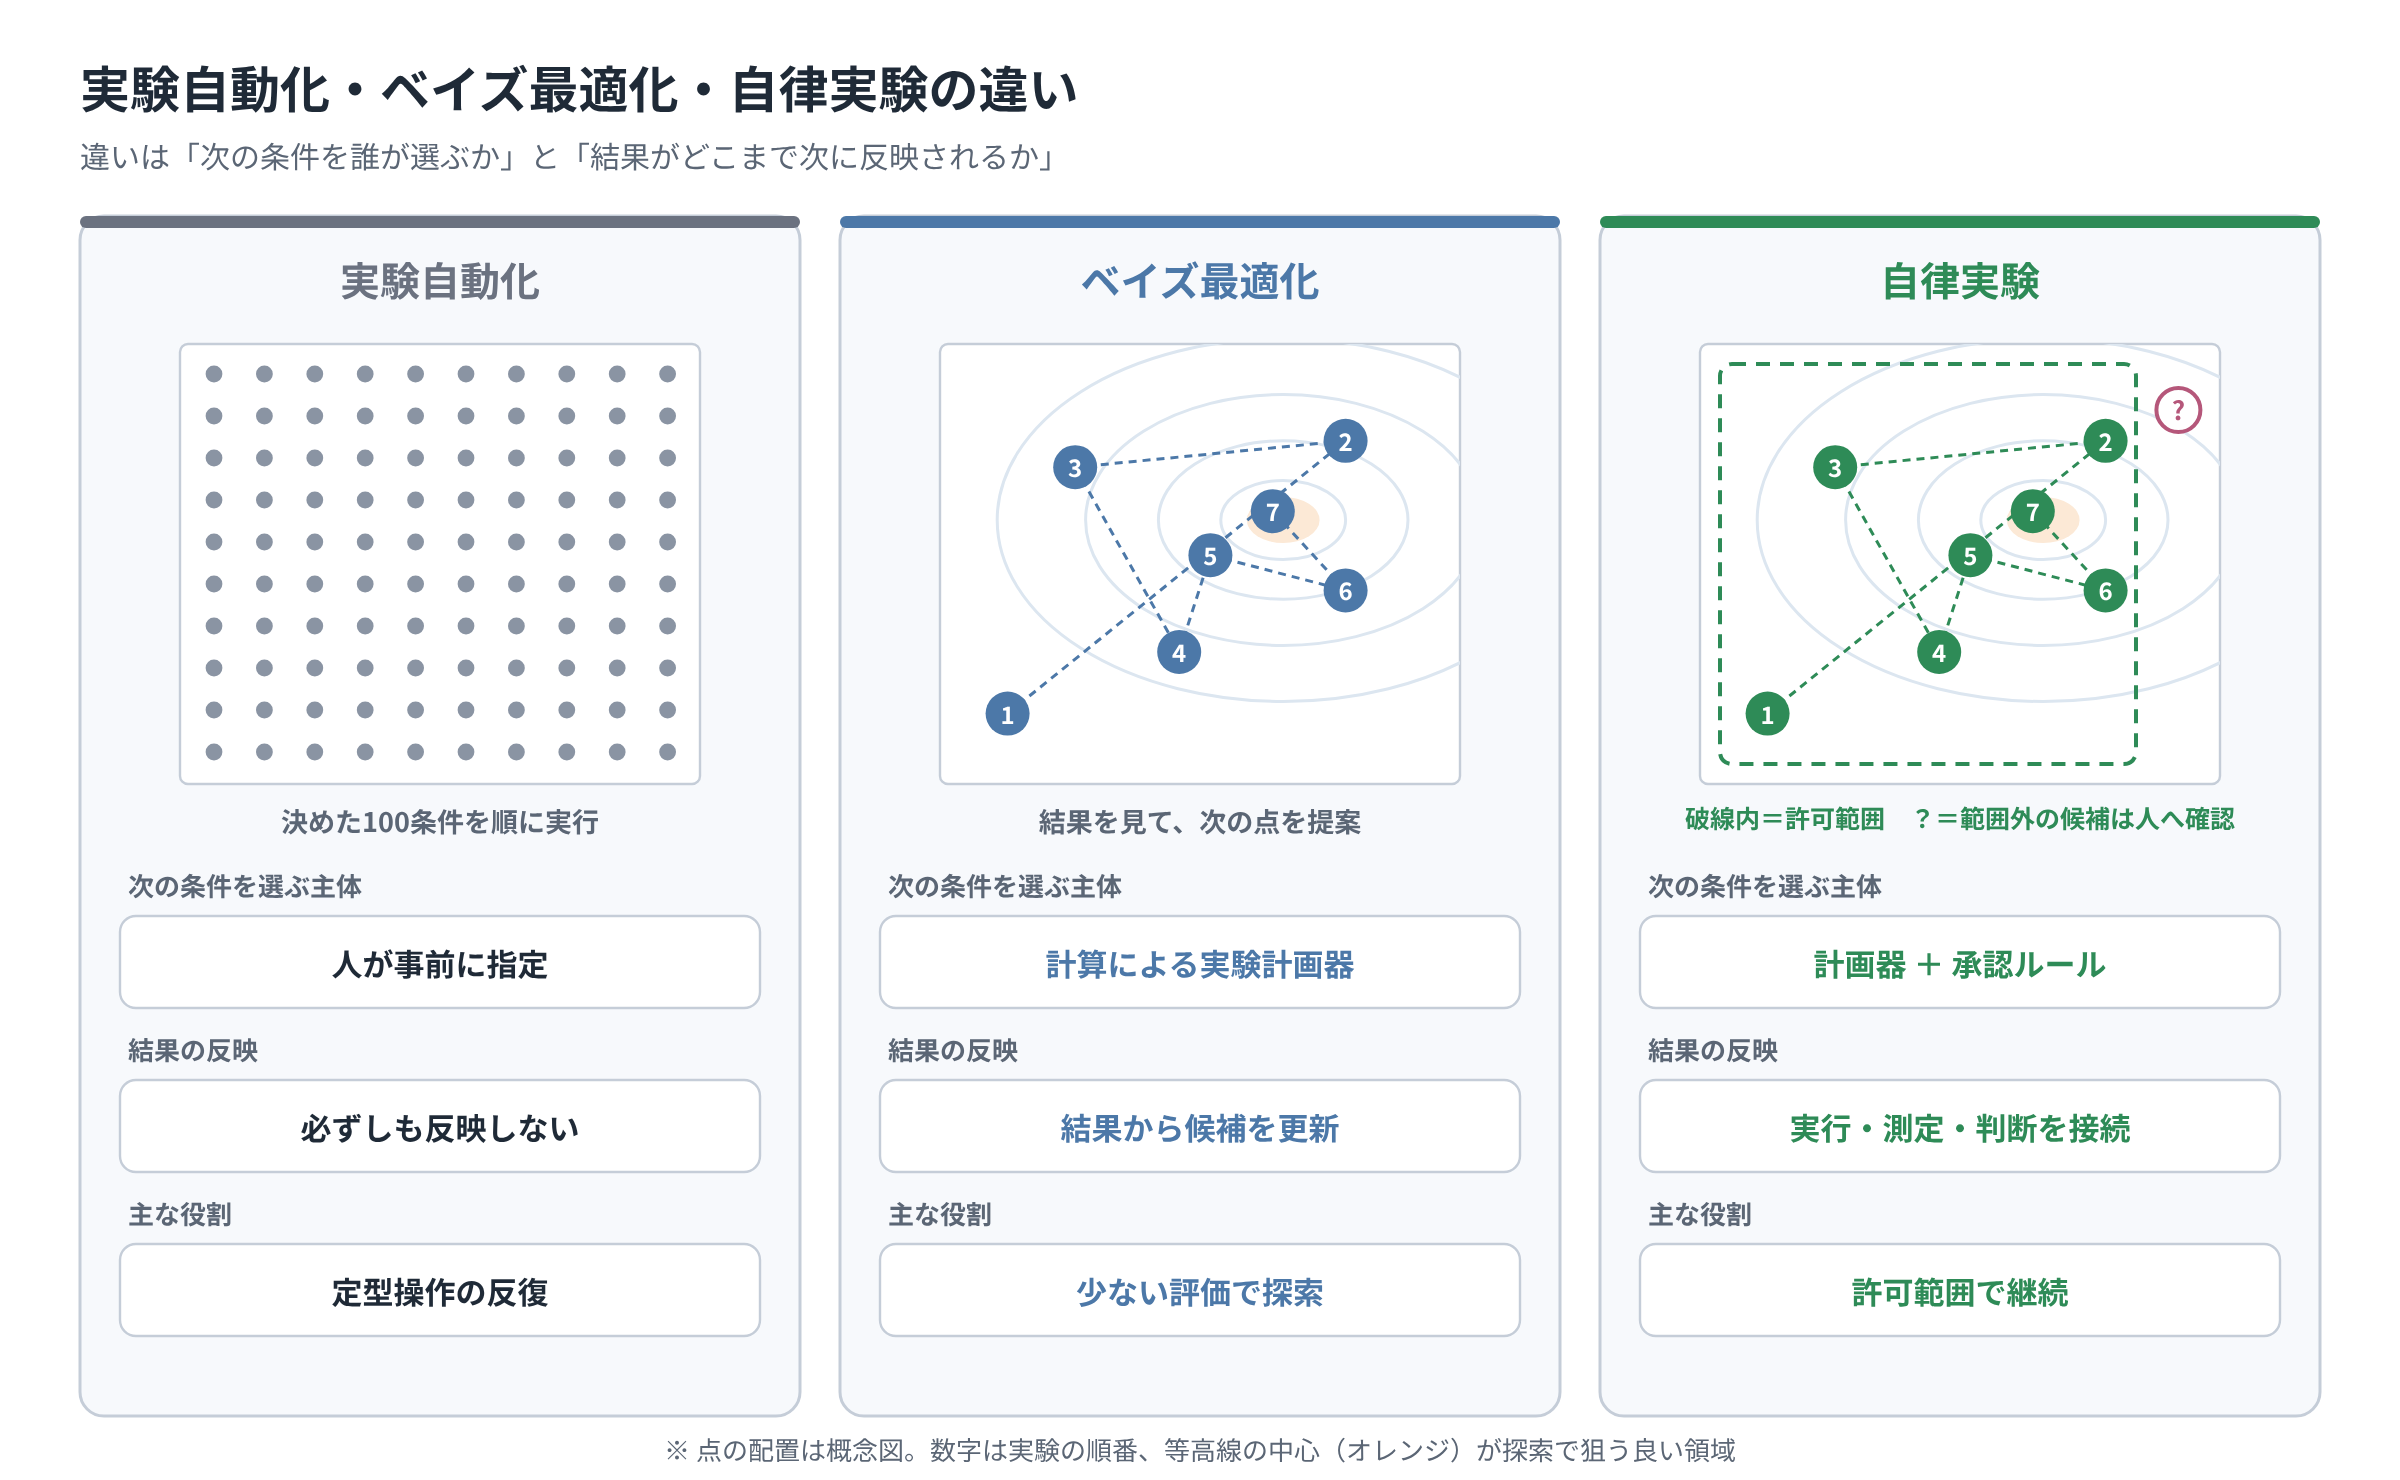
ここでの比較は編集部による機能の整理です。ベイズ最適化は実験条件を選ぶ方法の一つであり、自律実験を構成する装置や品質確認まで代替するものではありません。
閉ループ材料探索を構成する5つの仕事
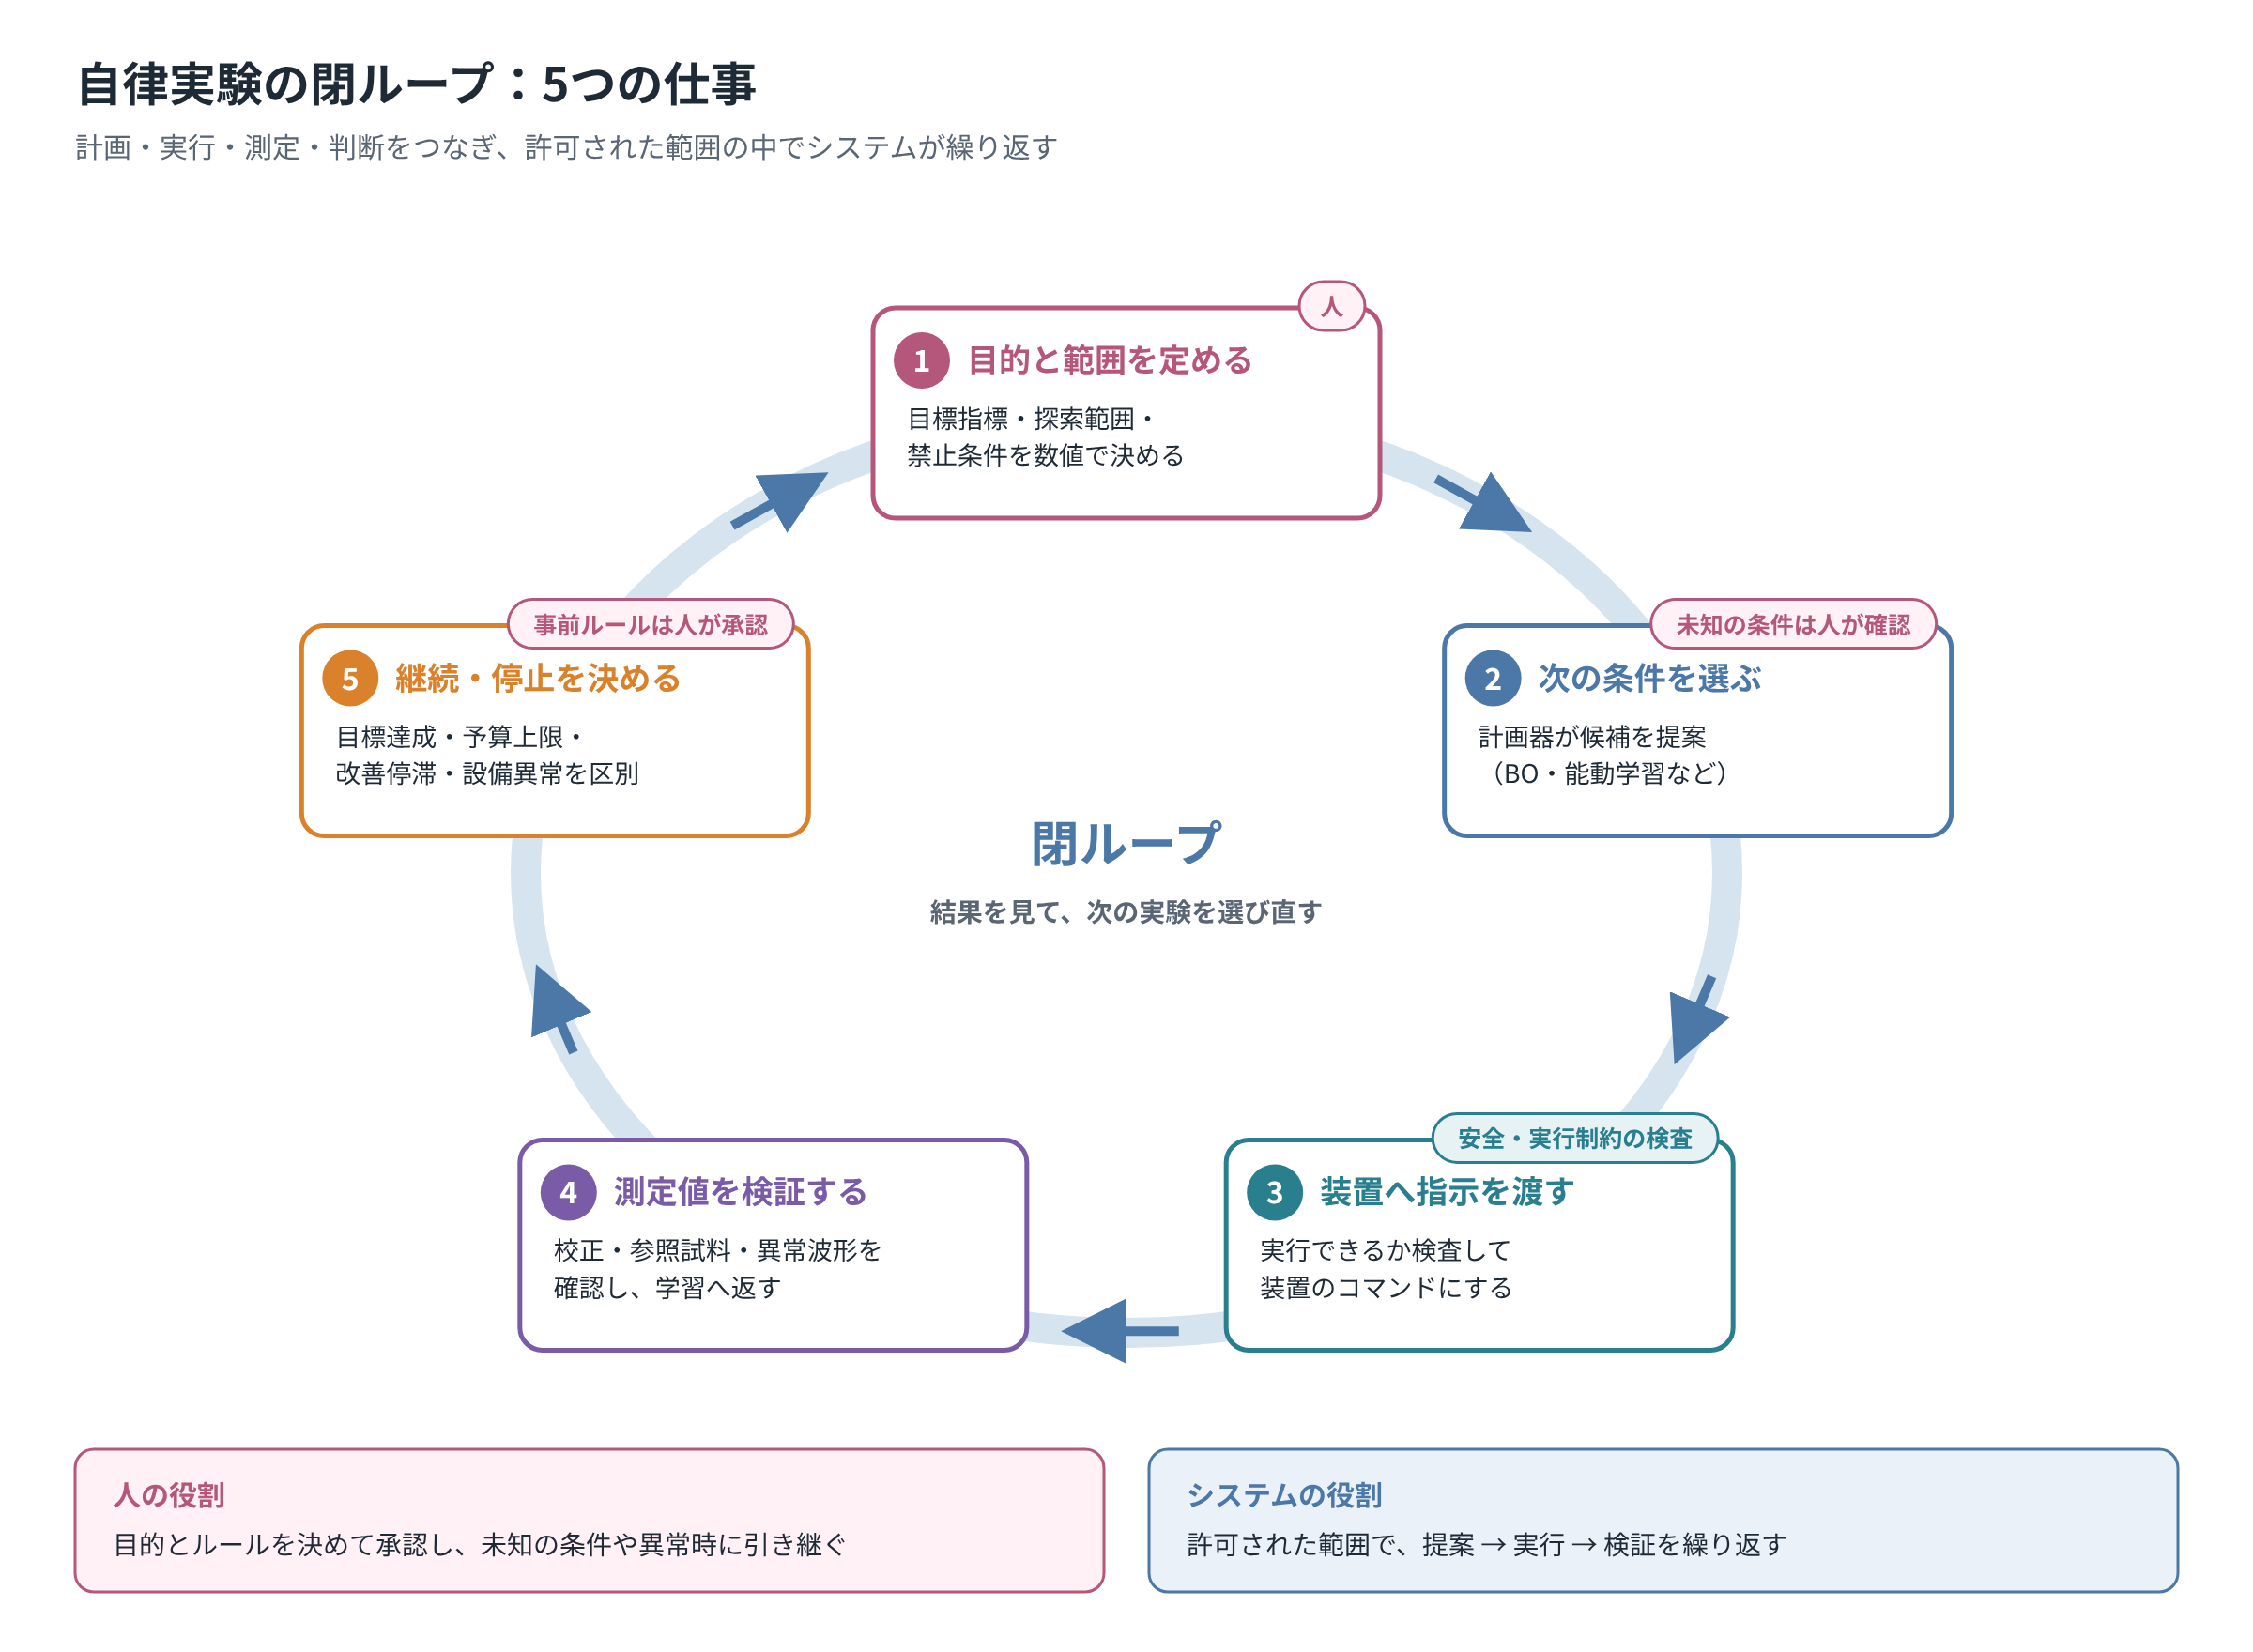
1.研究目的と探索範囲を定める
最初に、何を良くしたいかを数値や判定基準にします。性能の最大化、目標値への接近、不確かな領域の測定などでは、必要な実験が違います。変えられる組成・温度・時間と、変えてはいけない条件を分けます。装置の上限だけでなく、試料や操作の安全性から許される組合せも確認します。
目的関数は研究目的の代理であることがあります。測定しやすい指標を改善しても、耐久性や製品性能まで改善するとは限りません。例えば薄膜の簡便な電気特性を使う場合、膜厚や欠陥の影響を受けていないかを確認し、最終用途に近い評価を別に用意します。
2.次の実験条件を選ぶ
実験計画器は、既存データをもとに候補を選びます。ベイズ最適化なら、良い結果が期待できる条件と、まだ不確かで測定する価値がある条件を比較します。アクティブラーニングは、予測や理解を改善するために情報価値の高い測定を選ぶ考え方です。両者は重なる場合がありますが、目標を明示して使い分けます。
自律実験にベイズ最適化が必須というわけではありません。固定ルール、候補列挙、別の探索アルゴリズムを使うこともあります。比較の入口は、実験計画法とベイズ最適化の違いを参照してください。最初は単純な探索と比較し、アルゴリズムを追加する価値を測ります。
3.装置へ実行可能な指示を渡す
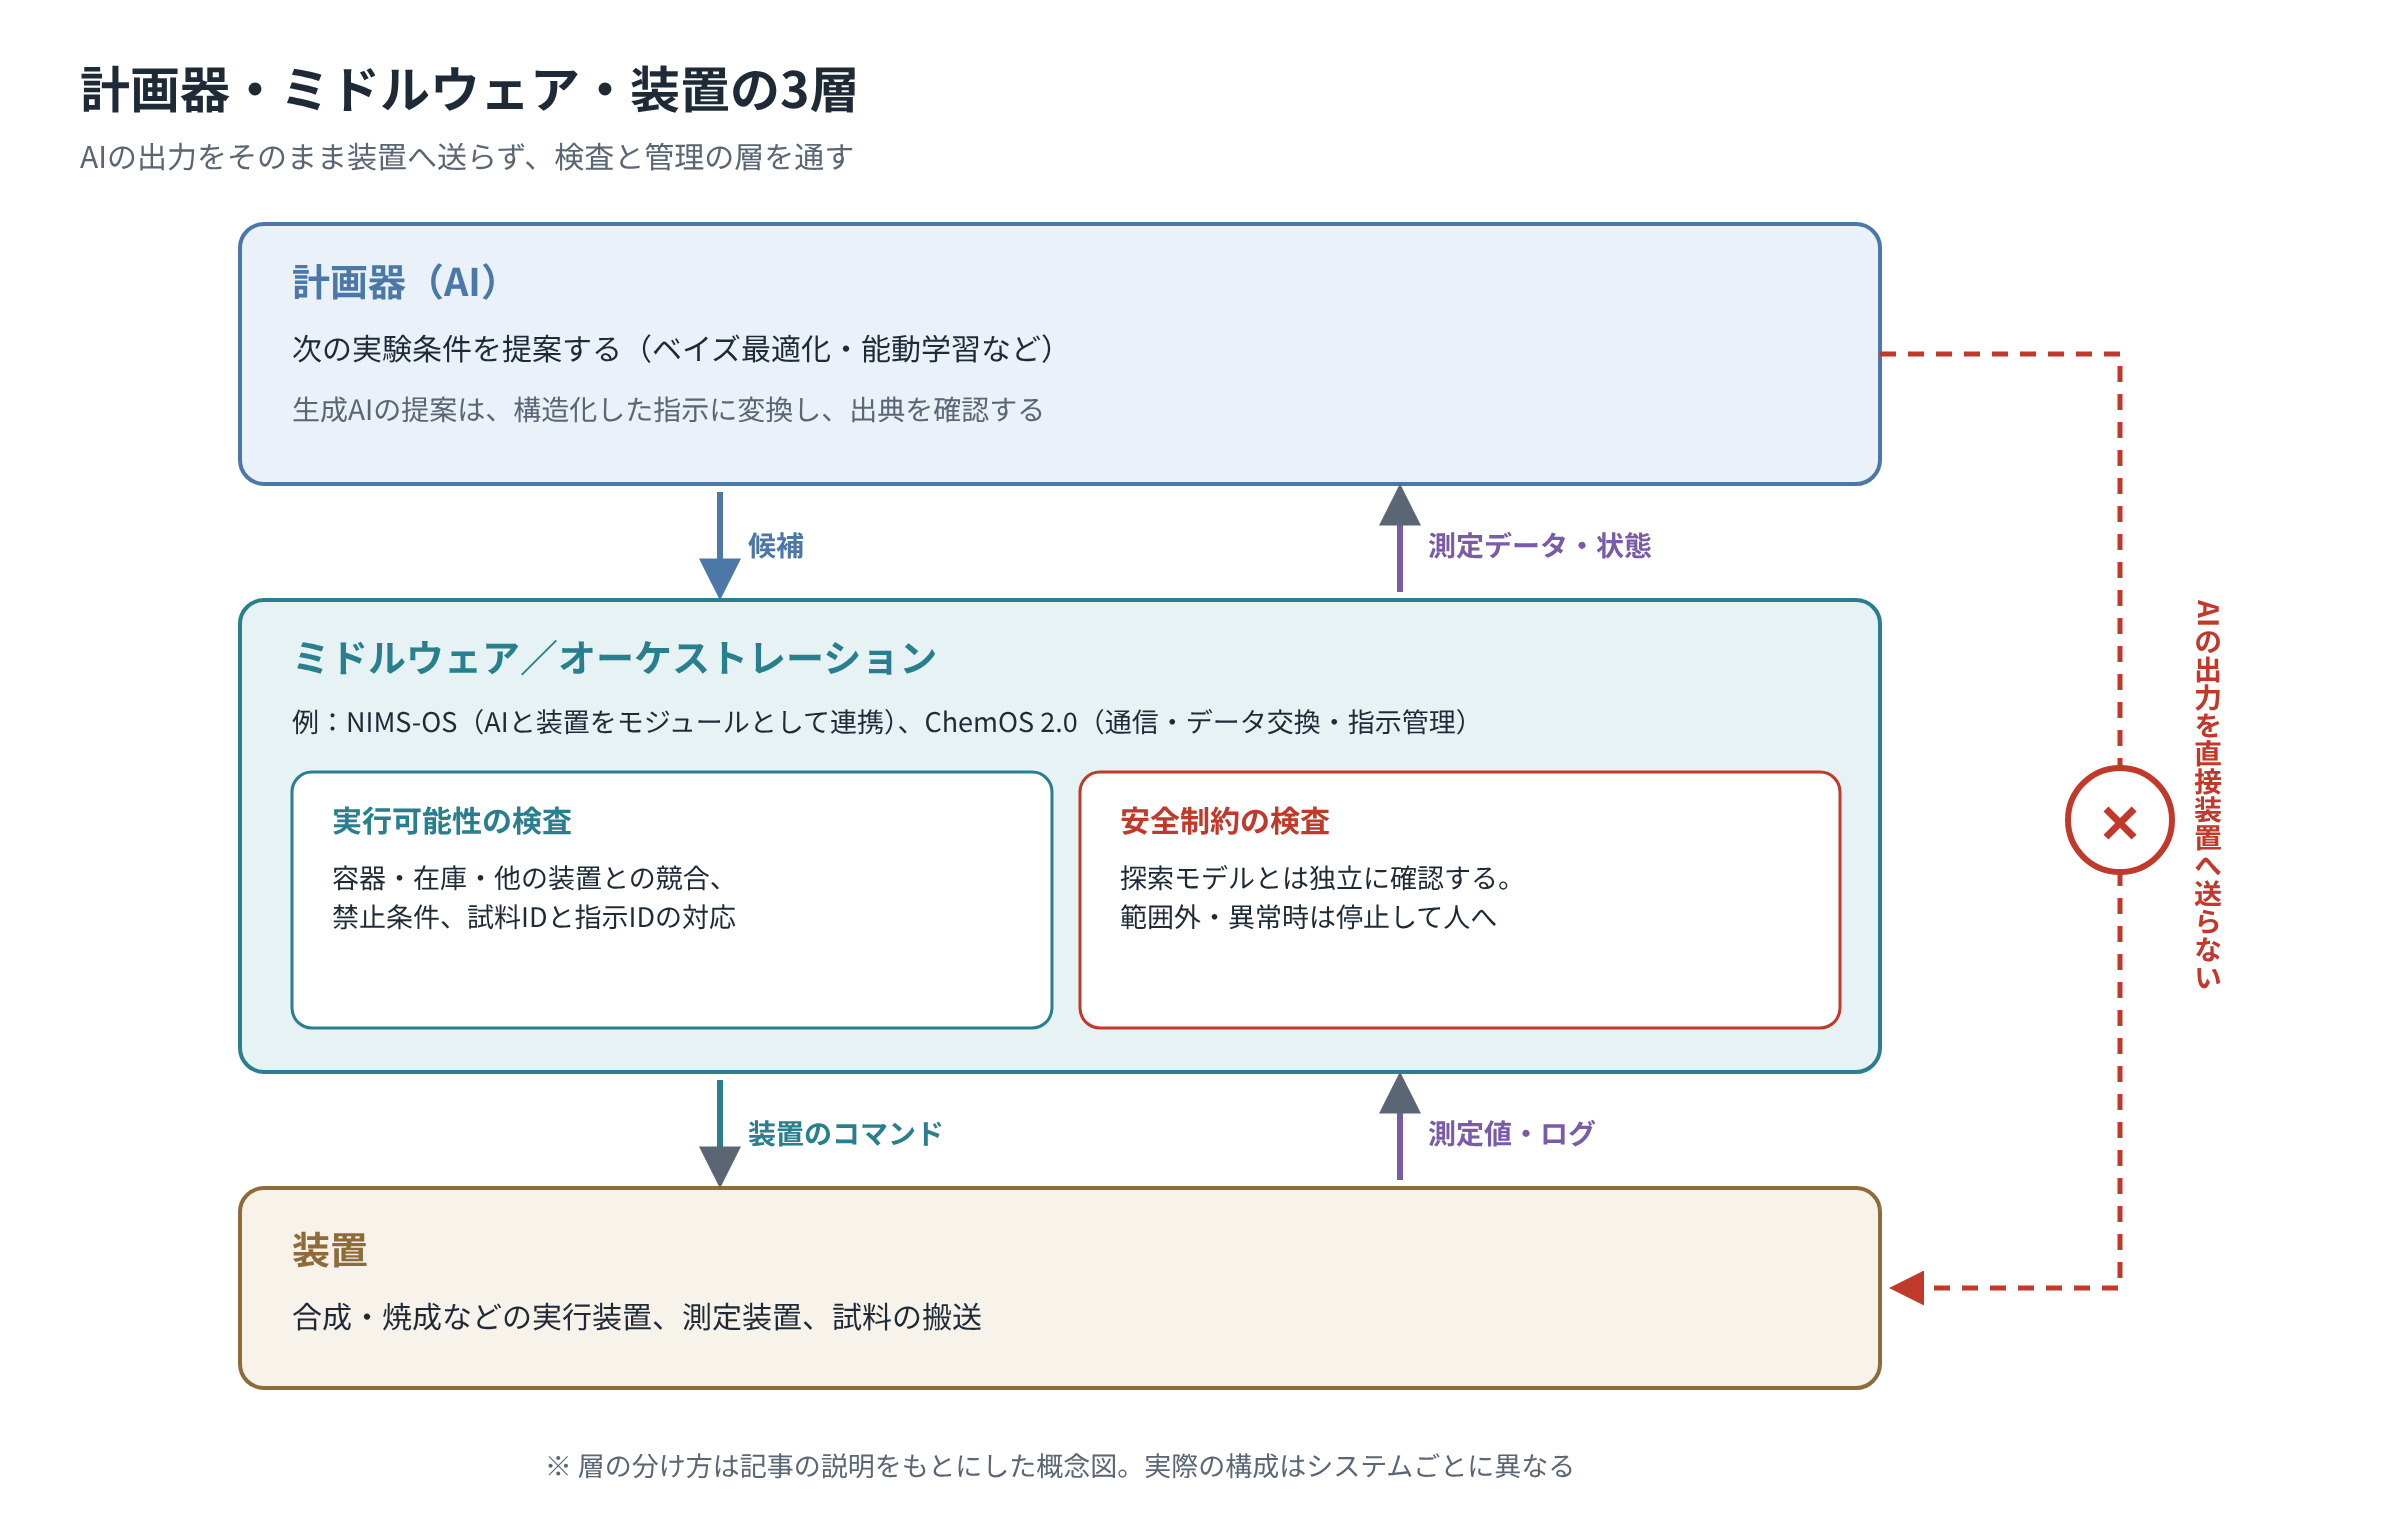
「組成を変える」という候補を、実際の秤量量、分注量、処理時間に変換します。合計量、装置の最小分解能、在庫、試料容器、洗浄、共有装置の空き状況などを確認しないと、数学的には有効な候補でも実行できません。実験計画と装置制御の間には、指示を検証し、状態を管理する層が必要です。
NIMS-OSは、材料探索用AIとロボット実験装置をモジュールとして連携するミドルウェアとして発表されています。[2]またChemOS 2.0の原著論文は、実験室の構成要素の通信、データ交換、指示管理を調整するオーケストレーションを扱っています。[3]こうした基盤は、AIの出力をそのまま装置へ送る構成とは異なります。
4.測定値を検証して学習へ返す
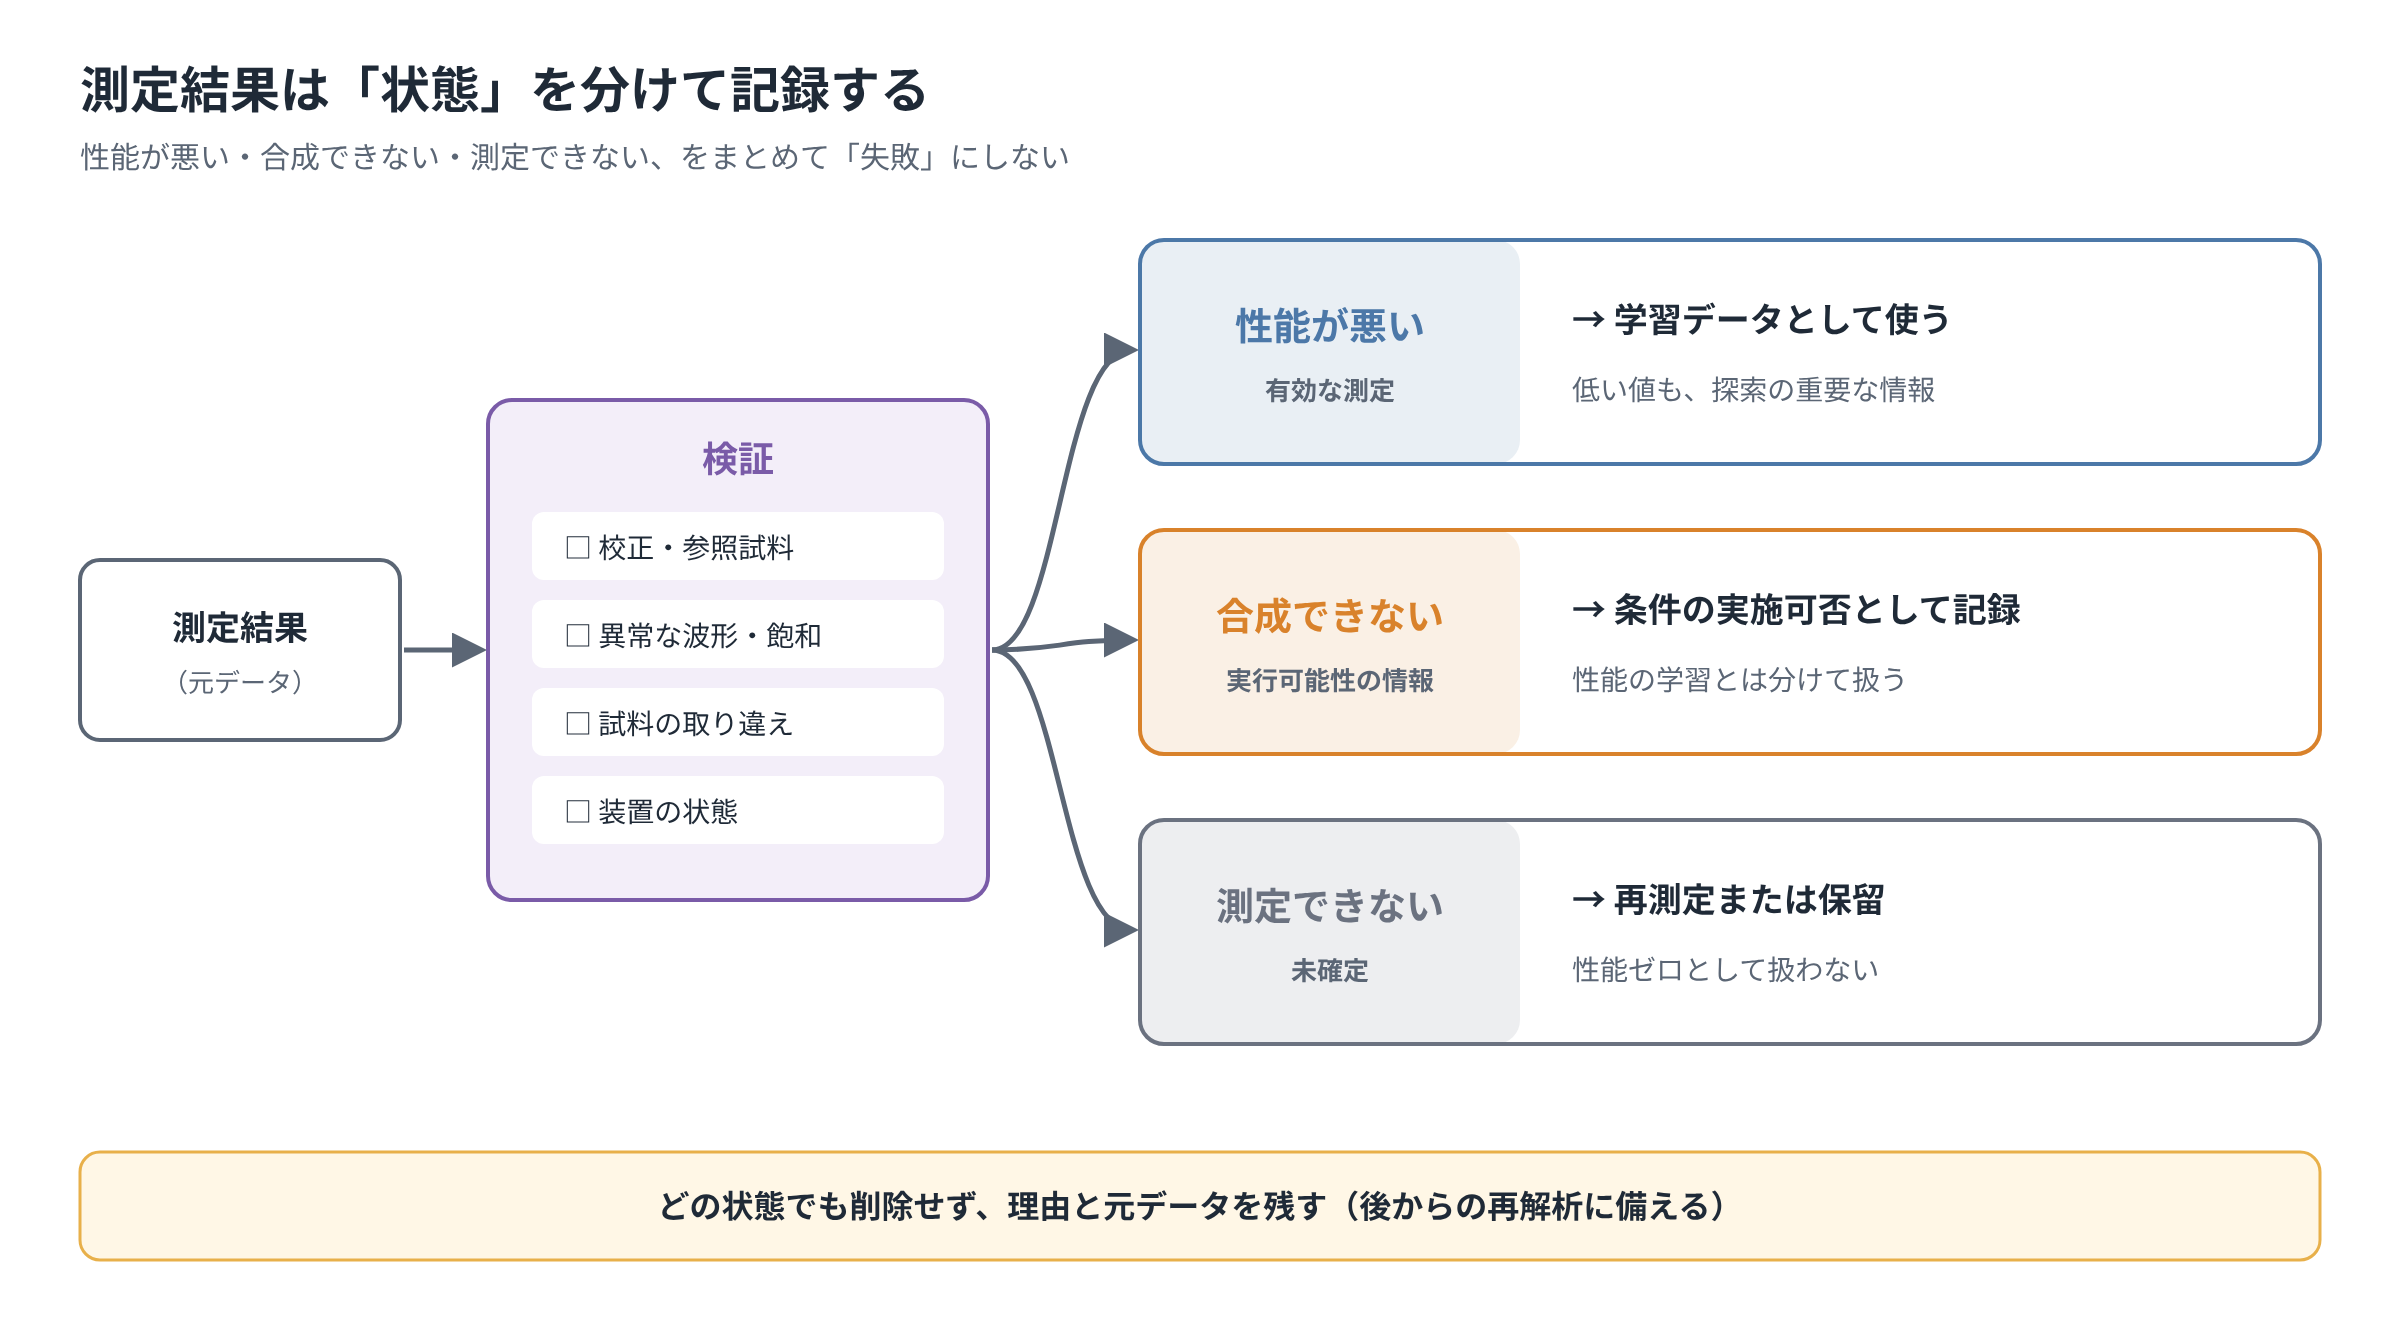
測定完了の通知と、利用できる品質のデータが得られたことは別です。校正、参照試料、異常な波形、飽和、試料取り違えなどを確認し、採用・再測定・保留を判断します。元の信号と解析結果は両方保存し、後から解析方法を変更しても追跡できるようにします。
材料が目標性能を満たさなかった結果は、探索に役立つ情報です。一方、装置故障で測れなかった結果を低性能の材料として学習すると、モデルを歪めます。「性能が悪い」「合成できない」「測定できない」を別の状態として記録してください。品質確認の基本は、材料データの品質を高める方法とも共通します。
5.継続・停止・人への引継ぎを決める
継続・停止・人への確認は事前に定めます。目標達成、予算上限、改善停滞、設備異常では、停止理由を区別して記録します。
仮想例:セラミックスの焼成条件を閉ループで探す
以下は仕組みを説明する仮想例で、実在の研究結果や推奨焼成条件ではありません。対象組成を固定し、許可された温度・保持時間の範囲で目標密度を満たす条件を探すとします。
| 段階 | 行うこと | 次の判断 |
|---|---|---|
| 初期実験 | 異なる条件を測り、参照試料も評価 | 測定誤差と条件間の差を確認 |
| モデル更新 | 密度と焼成条件の対応を学習 | 良い予測と不確かな領域を比較 |
| 次条件の選択 | 候補を選び、実行制約を検査 | 許可範囲なら実行、未知条件なら人へ確認 |
| 結果確認 | 試料ID、密度、元データを照合 | 有効なら学習。測定失敗なら保留・再測定 |
| 最良候補の検証 | 別の日・別試料で再現性を測る | 目標を満たせば停止。予算上限や異常でも停止 |
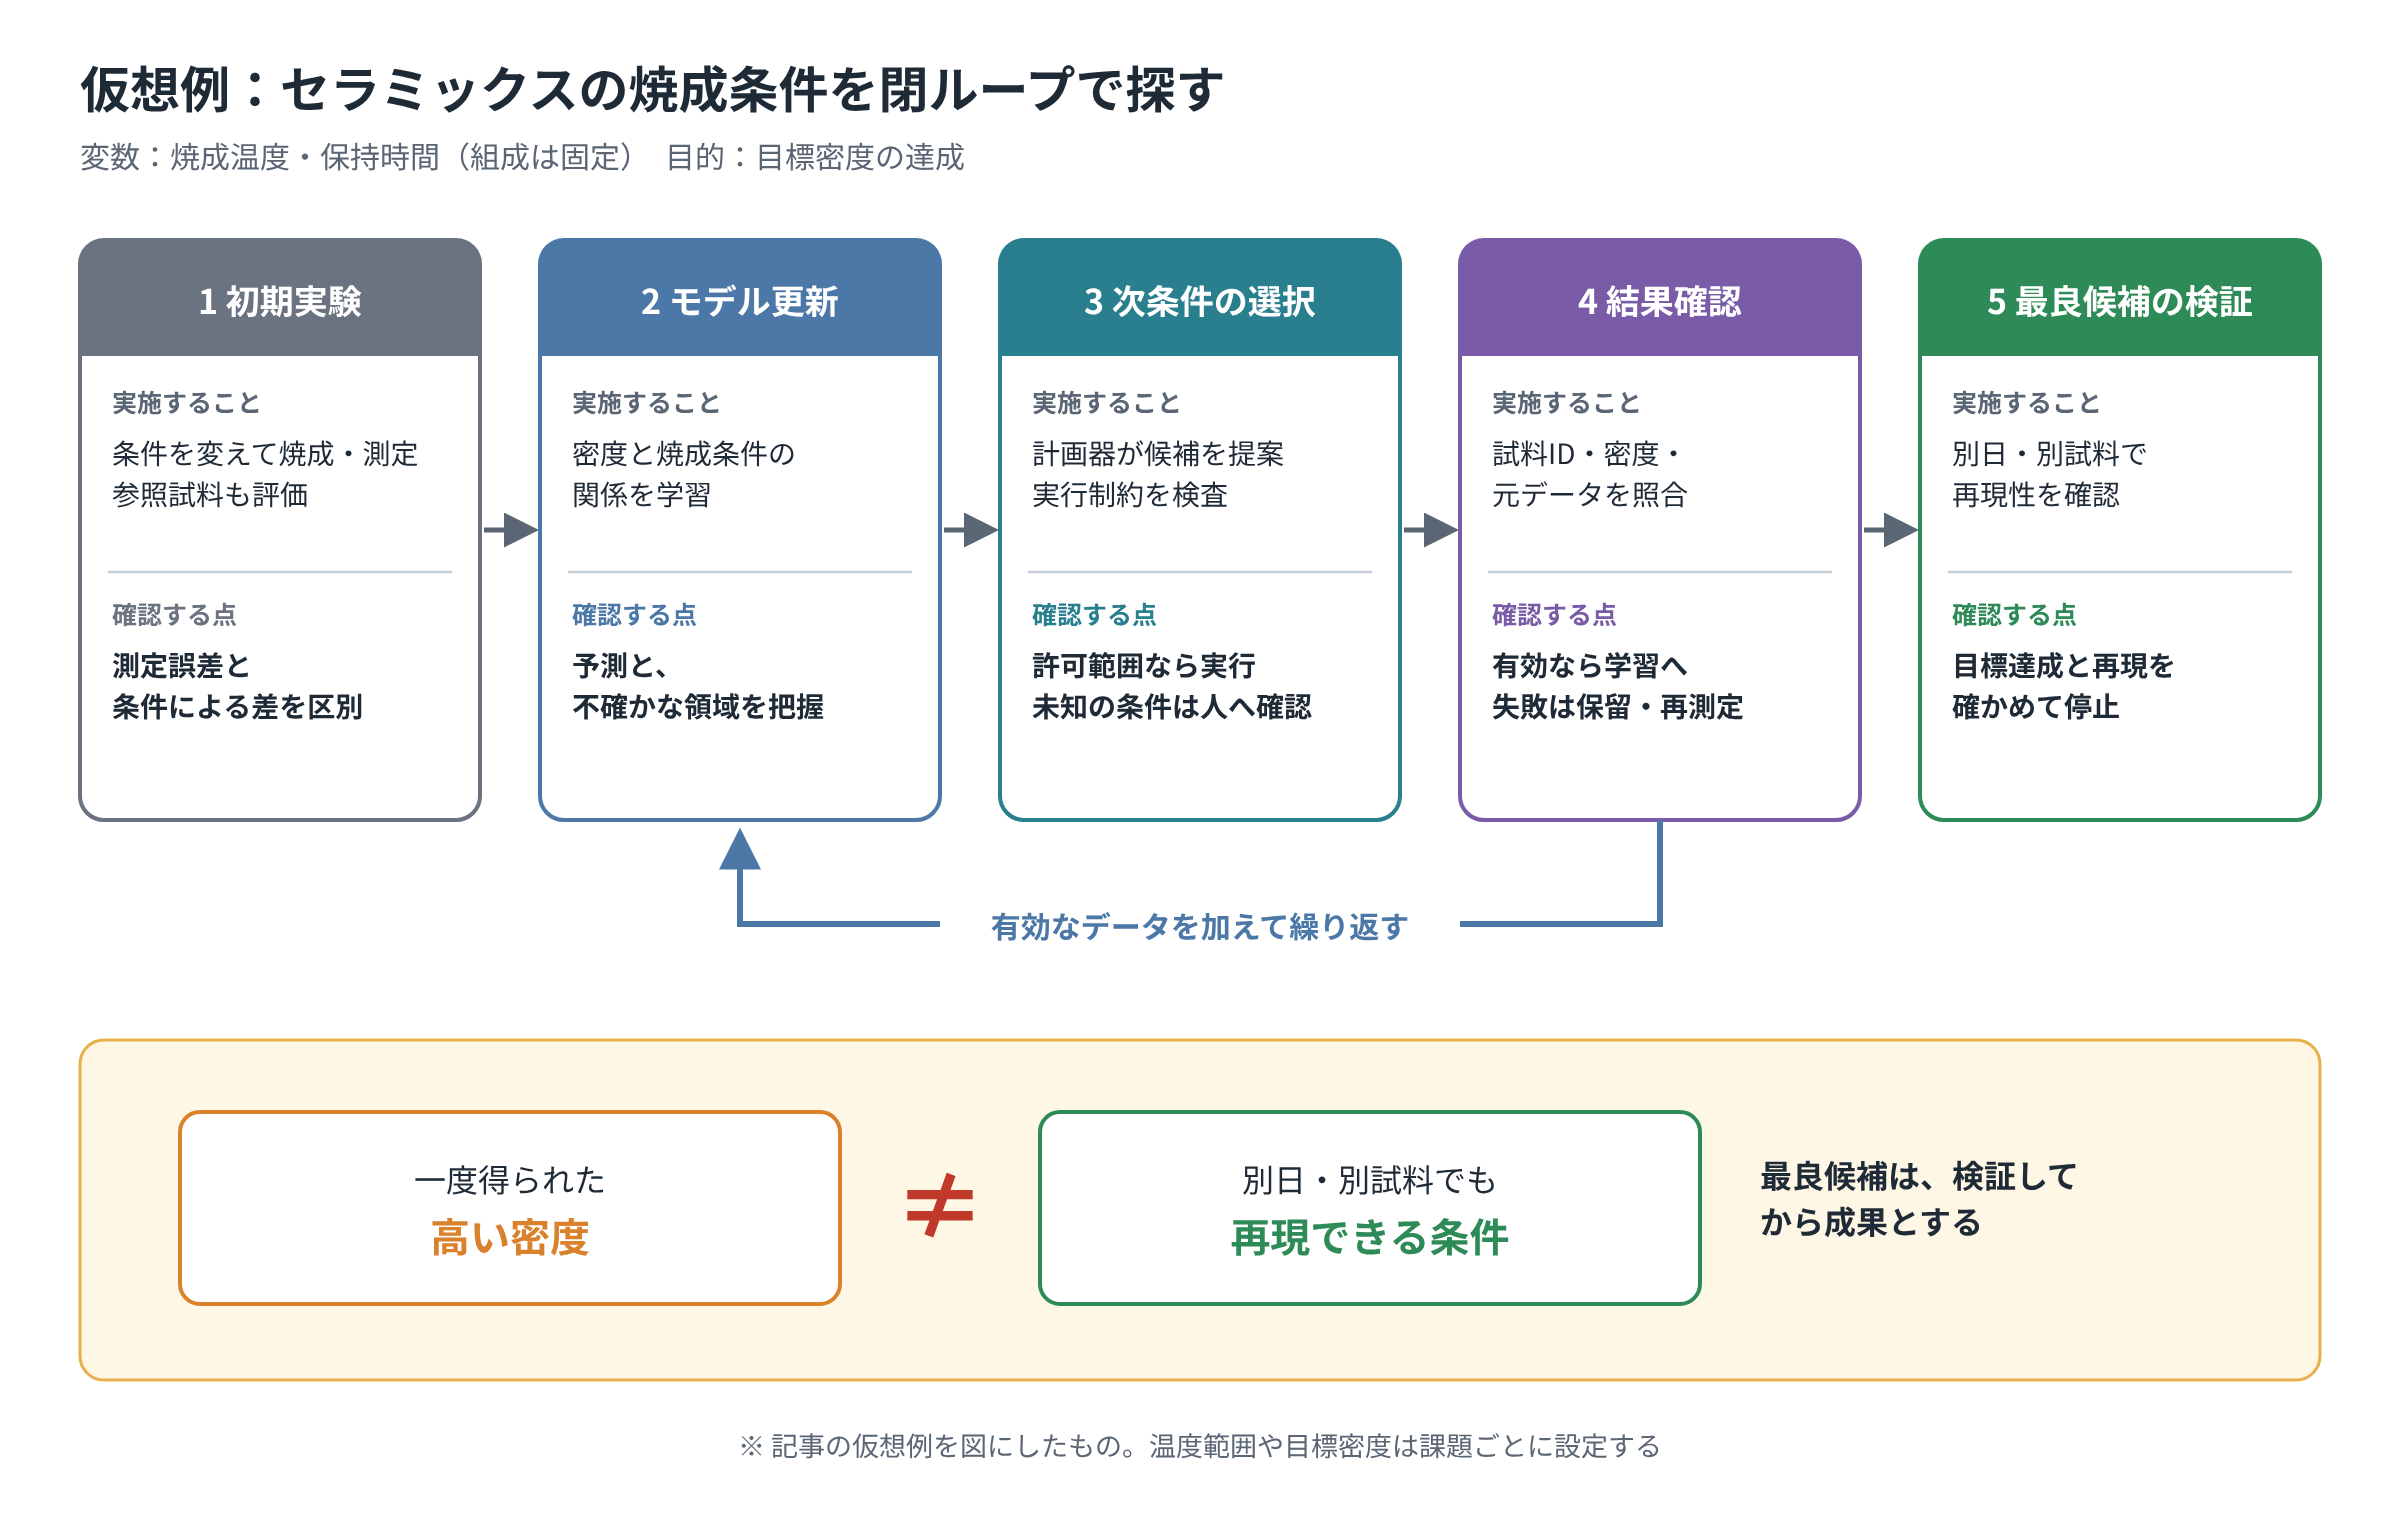
高い密度が一度得られたことと、再現できる条件が確立したことは別です。モデルが提案した条件でも、変形や別の品質低下があれば候補から外します。探索と独立検証を区別するのがポイントです。
閉ループに必要な実験記録と状態管理
前章のセラミックスの例を実装するには、提案条件・実際の処理条件・測定結果を対応づけます。次の表は編集部が提案する最小限の記録です。実装に合わせて項目を追加してください。
| 項目 | 記録する内容 | 使い方 |
|---|---|---|
| request_id/sample_id | 指示IDと試料ID | 一つの指示から複数試料を作る場合も対応関係を保存 |
| 提案条件/実際の条件 | 組成、温度、時間、単位、許可範囲の版 | 提案と実行のずれを確認 |
| planner_version/解析の版 | 条件選択・測定解析の設定と版 | 再解析と提案理由の追跡 |
| execution_state | 未実行・実行中・完了・中断・不明 | 装置側の処理が終わったか判断 |
| quality_state/value | 有効・無効・未取得、値と単位 | 性能モデルに投入してよいか判断 |
| reason/next_action | 理由と、学習・再測定・保留・人への確認 | 未処理の実験を放置しない |
| 元データと履歴 | ファイルの所在、時刻、担当者、変更履歴 | 判定を変えても元記録を追跡 |
実行状態と、研究結果の判定を分ける
| 例 | 実行状態 | 品質・結果の扱い | 次の処理 |
|---|---|---|---|
| 有効な測定で性能が低かった | 完了 | 有効。測定値を残す | 性能モデルの学習に使う |
| 校正不良や飽和が見つかった | 完了 | 無効。性能値として採用しない | 元データを残して保留・再測定 |
| 通信が切れ、完了通知が届かない | 不明 | 値の未取得と、実験未実施を区別 | 装置ログと試料を確認してから再実行を判断 |
| 合成できなかった | 中断または完了 | 原料不足・装置異常・条件由来など理由を区別 | 原因を確認し、条件の実施可否と性能学習を分ける |
合成に失敗した一度の結果だけで、その条件を本質的に実施不能と決めないことが大切です。装置不調や操作の問題を除外し、条件由来の失敗と確認できた情報を実行可能性の学習に利用します。測れなかった結果に「性能ゼロ」を代入しません。
通知の再送に備え、同じ指示IDの同じ結果は二重登録しないようにします。内容が違う結果が届いた場合は上書きせず照合します。記録の重複防止だけでは装置の二重実行は防げないため、実装では実行状態の確認も必要です。
Pythonで試す、装置なしの小さな閉ループ
以下はPython 3.10以降・標準ライブラリだけで動く教材です。二つの変数を0〜1に正規化し、制約内の候補を選び、仮想的な性能を測定します。実材料の焼成温度や密度を表すものではありません。実装例と判断ルールは編集部によるものです。
候補選択は、距離による重み付き平均の予測に、未測定領域へ向かう距離ボーナスを加えた簡単なルールです。ベイズ最適化ではなく、距離ボーナスも統計的に校正された不確かさではありません。閉ループの接続を理解するために使います。
| 段階 | コードで行うこと |
|---|---|
| 初期実験 | 4条件から開始。x1+x2≤1.6を含む制約を確認 |
| 条件選択 | 有効な探索測定だけから次の候補を選ぶ |
| 実行と品質確認 | 5回目に校正不良、8回目に装置中断を意図的に発生させる |
| 記録 | 指示ID、試料ID、状態、測定値、次の処理をCSVに保存 |
| 停止 | 初期実験と失敗を含む16回で探索を停止 |
| 独立検証 | 選んだ条件を別の仮想試料で2回測る。条件選択には戻さない |
保留した条件の原因調査・再測定は、この教材では自動実行しません。実装では担当者、期限、再試行回数を決めます。探索は目標値で早期停止せず予算上限で止め、その後に検証する設計です。2回の検証は処理の説明用であり、実材料の再現性を保証する回数ではありません。
python sdl_closed_loop.py --out sdl_results同名の出力フォルダがある場合は停止します。再実行は別の名前を指定してください。history.csvは全18回の履歴、summary.jsonは1回の実行結果、comparison.csvは20種類の乱数シードで二つの選択方法を比較した40行の結果です。無効・未取得の性能値は空欄になります。
実行可能なPythonコードを開く
"""Instrument-free educational loop; Python 3.10+, standard library only.
Normalized variables have no physical units. Selection is a heuristic, not BO.
Run: python sdl_closed_loop.py --out sdl_results
"""
import argparse
import csv
import json
import math
import random
from pathlib import Path

BUDGET = 16  # includes four initial attempts and injected failures
TARGET = 0.90
FIELDS = ['request_id', 'sample_id', 'phase', 'x1', 'x2', 'planner_version',
          'execution_state', 'quality_state', 'value', 'unit', 'reason', 'next_action']


def allowed(point):
    x, y = point
    return all(math.isfinite(v) and 0 <= v <= 1 for v in point) and x + y <= 1.6


def response(point):
    x, y = point
    return math.exp(-8 * ((x - .65) ** 2 + (y - .45) ** 2))


def ingest(records, row):
    """Idempotent record insertion; conflicting duplicate is an error."""
    if not allowed((row['x1'], row['x2'])):
        raise ValueError('Candidate violates the fixed constraint')
    for old in records:
        if old['request_id'] == row['request_id']:
            if old != row:
                raise ValueError('Conflicting duplicate request_id')
            return False
    if row['quality_state'] == 'valid':
        if row['execution_state'] != 'completed':
            raise ValueError('Unfinished experiment cannot supply a valid result')
        if row['value'] is None or not math.isfinite(row['value']):
            raise ValueError('Valid measurement requires a finite value')
    elif row['value'] is not None:
        raise ValueError('Unusable measurement must not be assigned a performance value')
    records.append(row)
    return True


def choose(pool, records, mode, rng):
    if mode == 'random':
        return rng.choice(pool)
    valid = [r for r in records if r['quality_state'] == 'valid']
    if not valid:
        return rng.choice(pool)
    def score(p):
        distances = [math.dist(p, (r['x1'], r['x2'])) for r in valid]
        weights = [1 / (d*d + .01) for d in distances]
        predicted = sum(w*r['value'] for w, r in zip(weights, valid)) / sum(weights)
        # Distance bonus is an exploration heuristic, not calibrated uncertainty.
        return predicted + .3 * min(distances)
    return max(pool, key=score)


def run(seed=0, mode='adaptive'):
    rng = random.Random(seed)
    pool = [(i/10, j/10) for i in range(11) for j in range(11)
            if allowed((i/10, j/10))]
    initial = [(0.1, .1), (.9, .1), (.1, .9), (.7, .7)]
    records = []
    for n in range(BUDGET):
        point = initial[n] if n < len(initial) else choose(pool, records, mode, rng)
        pool.remove(point)
        execution, quality, value, reason, action = 'completed', 'valid', None, '', 'learn'
        if n == 4:
            quality, reason, action = 'invalid', 'simulated_calibration_failure', 'hold_for_review'
        elif n == 7:
            execution, quality = 'interrupted', 'unavailable'
            reason, action = 'simulated_device_interruption', 'confirm_device_state'
        else:
            value = response(point) + rng.gauss(0, .025)
        row = dict(zip(FIELDS, [f'R{n+1:03}', f'S{n+1:03}', 'search', *point,
                   f'{mode}-v1', execution, quality, value, 'normalized_score', reason, action]))
        ingest(records, row)
        assert not ingest(records, dict(row))  # replayed notification is not counted twice
    best = max((r for r in records if r['quality_state'] == 'valid'), key=lambda r:r['value'])
    # Independent simulated specimens; their results never influence condition selection.
    verify = []
    for j in range(2):
        value = response((best['x1'], best['x2'])) + rng.gauss(0, .025)
        verify.append(value)
        row = dict(zip(FIELDS, [f'V{j+1:03}', f'VS{j+1:03}', 'verification',
             best['x1'], best['x2'], f'{mode}-v1', 'completed', 'valid', value,
             'normalized_score', '', 'verify_only']))
        ingest(records, row)
    return records, {'seed':seed, 'mode':mode, 'search_attempts':BUDGET,
        'verification_attempts':2, 'total_attempts':len(records),
        'valid_search_measurements':sum(r['phase']=='search' and r['quality_state']=='valid' for r in records),
        'best_x1':best['x1'], 'best_x2':best['x2'], 'verification_mean':sum(verify)/2,
        'verified_target_met':all(v >= TARGET for v in verify),
        'search_stop_reason':'budget_limit', 'target':TARGET}


def main():
    parser = argparse.ArgumentParser(description=__doc__)
    parser.add_argument('--out', required=True)
    args = parser.parse_args()
    out = Path(args.out)
    out.mkdir(parents=True, exist_ok=False)  # do not overwrite an earlier run
    records, summary = run()
    with (out/'history.csv').open('w', newline='', encoding='utf-8-sig') as f:
        writer=csv.DictWriter(f, fieldnames=FIELDS);writer.writeheader();writer.writerows(records)
    (out/'summary.json').write_text(json.dumps(summary, ensure_ascii=False, indent=2), encoding='utf-8')
    comparisons = [run(seed, mode)[1] for seed in range(20) for mode in ('adaptive','random')]
    with (out/'comparison.csv').open('w', newline='', encoding='utf-8-sig') as f:
        writer=csv.DictWriter(f, fieldnames=list(comparisons[0]));writer.writeheader();writer.writerows(comparisons)
    print(json.dumps(summary, ensure_ascii=False, indent=2))


if __name__ == '__main__':
    main()
実行結果の読み方
乱数シード0の適応的選択では、探索16回のうち有効測定14回、独立検証2回、合計18回となりました。選択条件はx1=0.6、x2=0.4で、検証平均は約0.947、検証2回とも教材の目標0.90以上でした。これは合成データでの動作例で、実材料での効果を示す結果ではありません。
目標を満たしても探索の停止理由はbudget_limitです。verified_target_metは検証結果を表す別の項目です。停止理由と成果判定を分けると、予算終了・目標未達・装置異常を混同せずに振り返れます。
次の段階では、仮想測定を「人が実験して測定結果を入力する処理」に置き換えます。提案条件を確認し、実行・測定し、品質判定した結果を返すところまで人が担当しても、小さな閉ループの接続を検証できます。装置への接続は、その流れが安定してから進めます。
公開事例:薄膜・無機粉末・高分子・装置解析
| 事例 | 探索する条件/評価 | 接続した仕事 | 解釈上の注意 |
|---|---|---|---|
| Ada[1] | 薄膜の組成・処理/光学・電気特性 | 作製→評価→次条件選択 | 代理指標と用途性能を区別 |
| A-Lab[4][5] | 無機粉末の合成手順/X線回折 | 合成→解析→再提案 | 訂正済み。新規性は別途確認 |
| PNIPAM[6] | 塩の組合せ・濃度/LCST | 液体操作→測定→最適化 | 2026年の雑誌掲載版を参照 |
| 薄膜成長[7] | 作製条件/RHEED画像 | 作製中の観測→条件探索 | 引用資料はプレプリント |
薄膜材料Ada:組成と処理条件を同時に扱う
MacLeodらのAdaは、有機薄膜の作製・処理・評価を行い、モデルに基づいて次の組成と処理条件を選ぶ事例です。[1]材料を作る操作と評価を一つのループに組み込めることが、閉ループ探索の前提になります。
この例で参考になるのは、一つの合成工程だけを速めるのではなく、評価までつなぐ設計です。ただし、ある薄膜の測定指標で成功した手法が、別の材料や長期耐久性の評価にも同じ効果を持つとは限りません。自分たちの評価指標が研究目的を代表するかを確認する必要があります。
A-Lab:無機粉末の合成と結果解釈を接続する
SzymanskiらのA-Labは、計算データ、文献から得た知識、ロボット実験、X線回折の解析とアクティブラーニングを組み合わせる研究です。現行の更新済み論文は、17日間の運転で57の標的から36化合物を実現したと報告しています。[4]
重要なのは、2026年1月19日の著者訂正です。材料の新規性は必ずしも科学全体にとっての新発見を意味しないと説明され、回折の再解析で一部の判定が不確定とされました。[5]初期報道の数値や「新物質を自動発見した」という表現だけで紹介せず、訂正後の内容を確認する必要があります。
A-Labの事例は、閉ループの実証と、構造・新規性の確証が別の仕事であることを示します。成功スコアだけで結論を出さず、独立した評価を残してください。
温度応答性高分子:小さな閉ループを検証する
Xuらの研究は2026年1月29日にAdvanced Intelligent Discoveryへ雑誌掲載されました。温度応答性高分子PNIPAMの下限臨界溶液温度(LCST)を対象に、液体操作、オンライン測定、ベイズ最適化を統合し、塩の組合せと濃度を探索するプラットフォームを報告しています。[6]低コストな構成の実証ですが、他の材料や測定系へ移す場合は再現性を別途検証する必要があります。
大型設備だけが自律実験の入口ではない、という着想の参考になります。ただし安価な構成でも、液体の混合、温度測定、残留物、光学測定の再現性を検証する仕事は残ります。導入費だけでなく、校正や保守に必要な時間まで評価します。
電子回折と薄膜成長:実験途中の情報を利用する
Liangらの2026年2月24日のプレプリントは、反射高速電子回折(RHEED)画像の解析を薄膜作製の条件探索へつなぐ閉ループを報告しています。[7]完成した試料の評価だけでなく、作製中の観測が次の判断に使われる例です。この資料もプレプリントとして紹介します。
実験途中のデータを使えると、単一の最終値では見えない変化を捉えられる可能性があります。一方で、画像解析の誤判定や装置固有の条件が探索を誘導するリスクもあります。他の装置へ移す場合は、画像・測定条件・材料の対応を改めて検証します。
研究開発現場で向いている課題・難しい課題
適性は、操作条件が明確か、同じ手順を繰り返せるか、比較可能な評価を得られるかで判断します。以下は編集部による初期判断の目安であり、合計点で導入を保証するものではありません。
| 確認する条件 | 着手しやすい状態 | 先に整理する状態 |
|---|---|---|
| 評価時間 | 探索予算内で複数回結果が返る | 結果待ちが長く、次条件の選択を検証できない |
| 操作の標準化 | 材料量・順序・容器を再現できる | 例外が多く担当者の手技に依存する |
| 測定の再現性 | 参照試料と反復測定で誤差を把握 | 測定のばらつきと材料差を区別できない |
| 探索制約 | 禁止条件・組合せを機械的に検査できる | 安全性や実行可能性が候補ごとに未確認 |
| 目標指標 | 最終用途との関係が説明できる | 測りやすい値と本当の性能の対応が不明 |
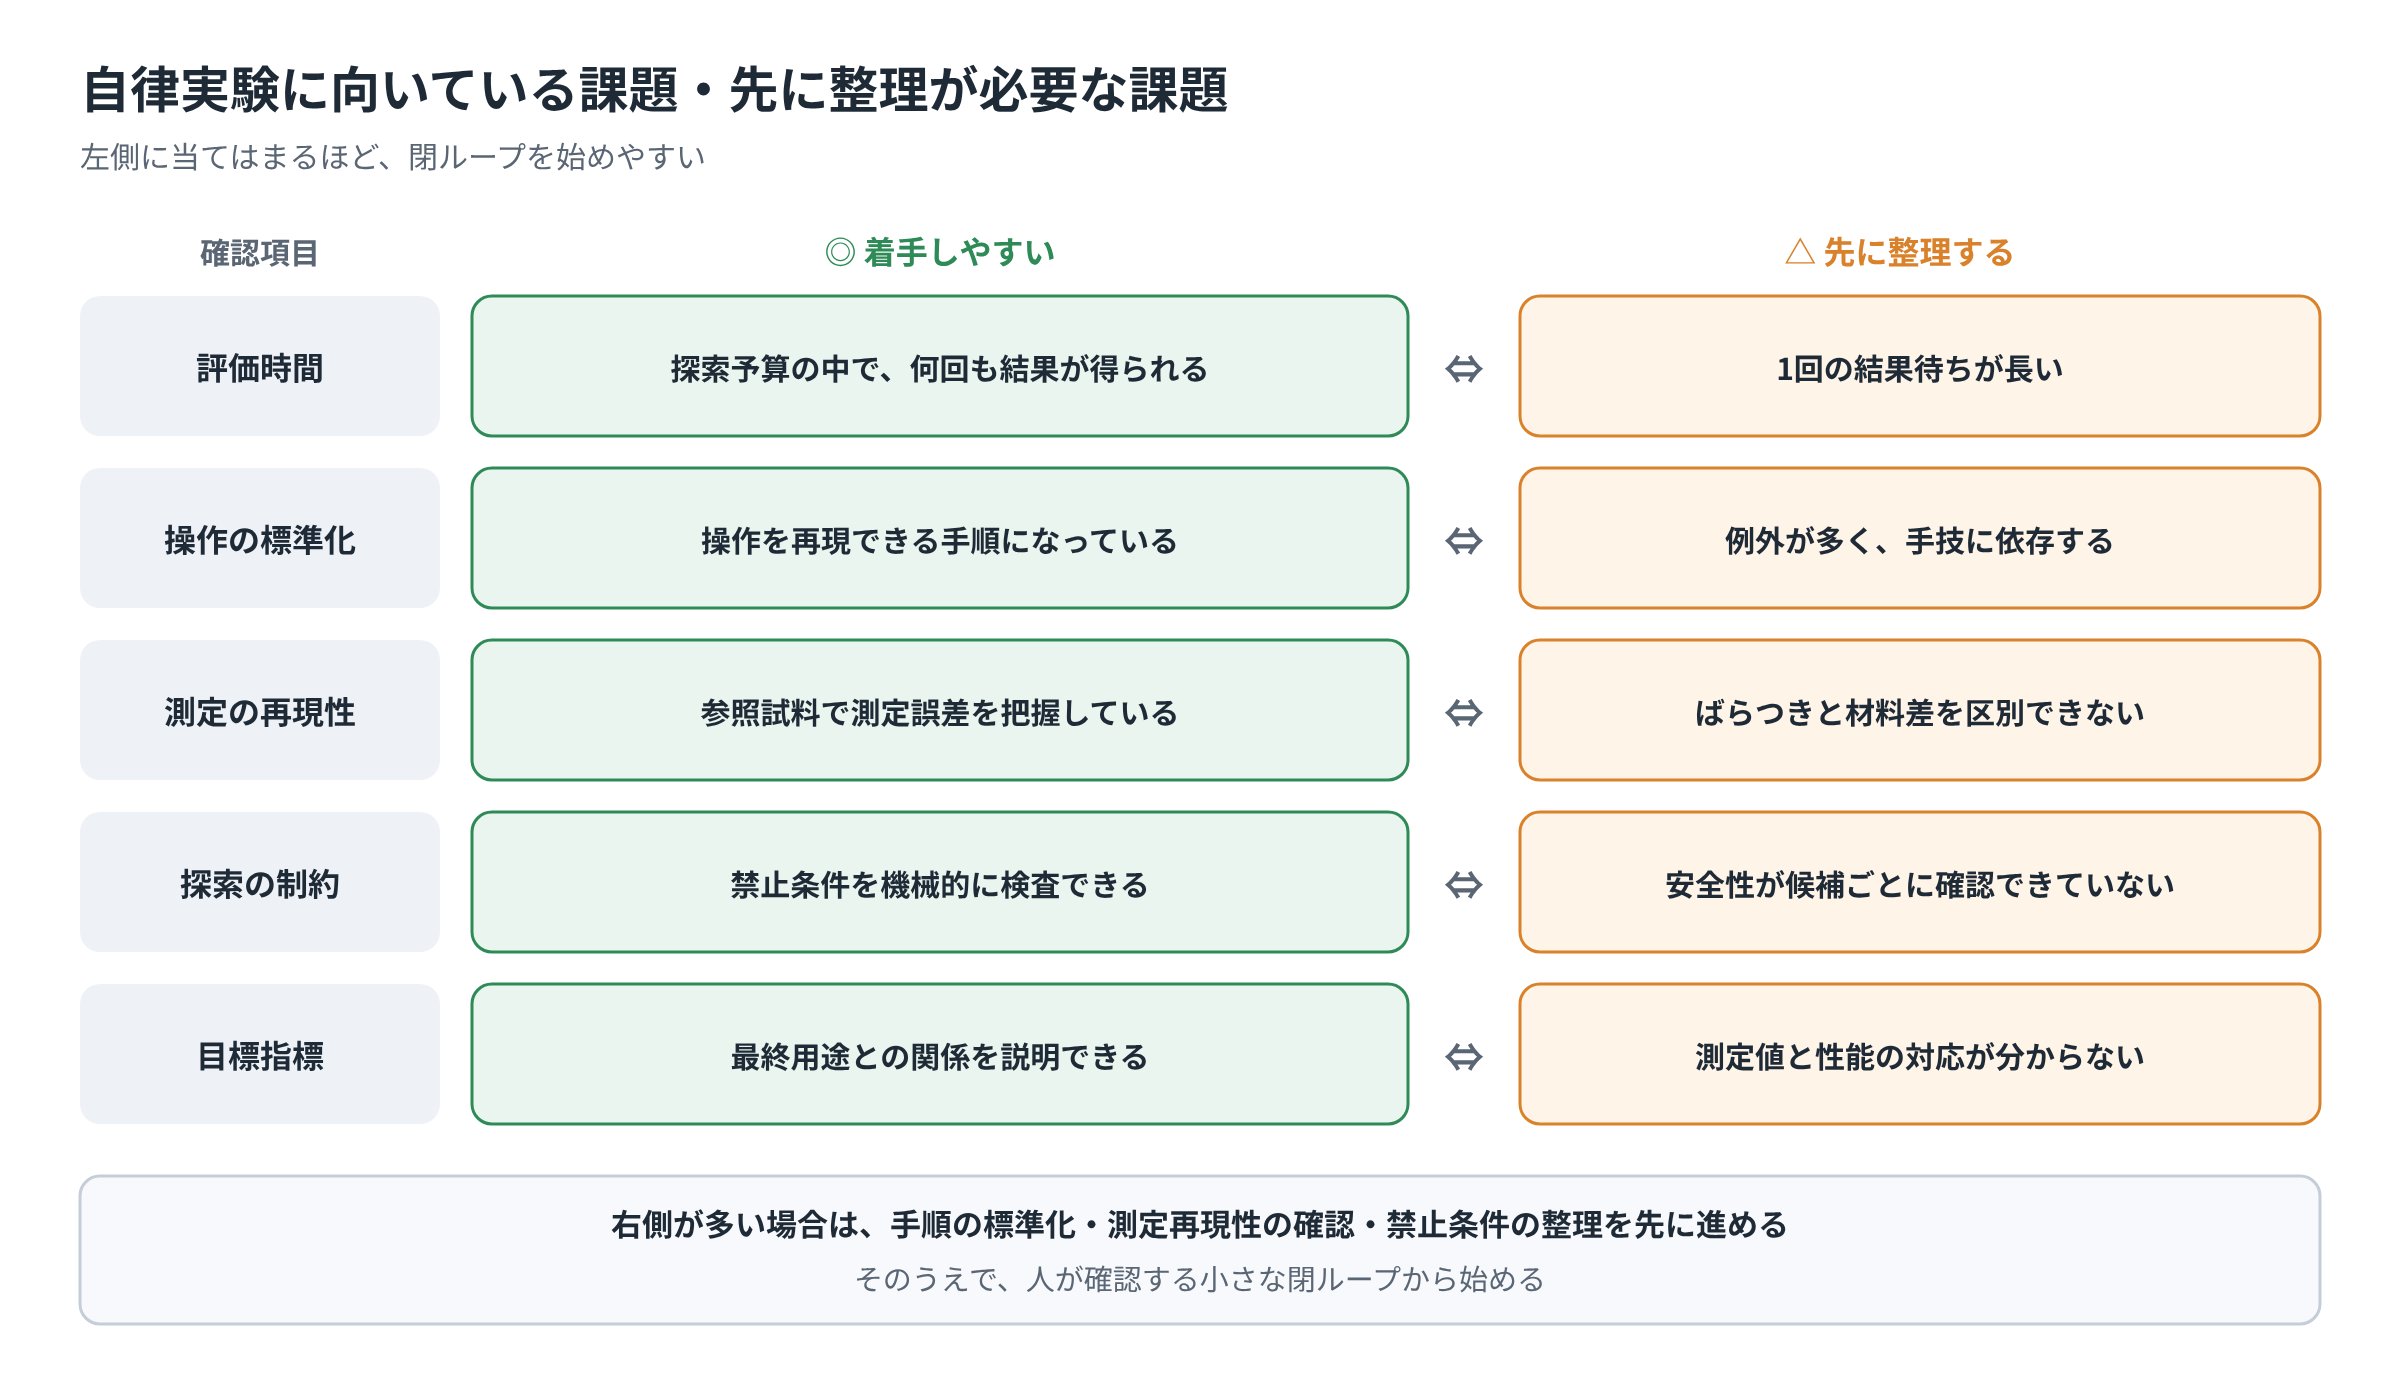
一つでも重大な未確認事項があれば、まず手動実験や半自動運転で確かめます。評価が遅い課題では、途中の代理指標を使えるかを検討できますが、最終評価との対応を確認してから探索に用います。
難しいのは、毎回試料形状が変わる、評価に数か月かかる、判断基準が担当者ごとに異なる、未知の危険な組合せを探索するような課題です。自動化できる操作があっても、評価と次の判断が安定しないなら、閉ループ全体をつくる前に前提の整理が必要です。
実験回数が少ない課題では、最適化に使うデータと再現性を確認するデータの配分も重要です。全予算を新しい候補に使うと、測定誤差で偶然高かった条件を選ぶ可能性があります。参照試料と再測定を計画に組み込み、探索と検証に別の役割を持たせます。
導入手順:人が確認する閉ループから始める
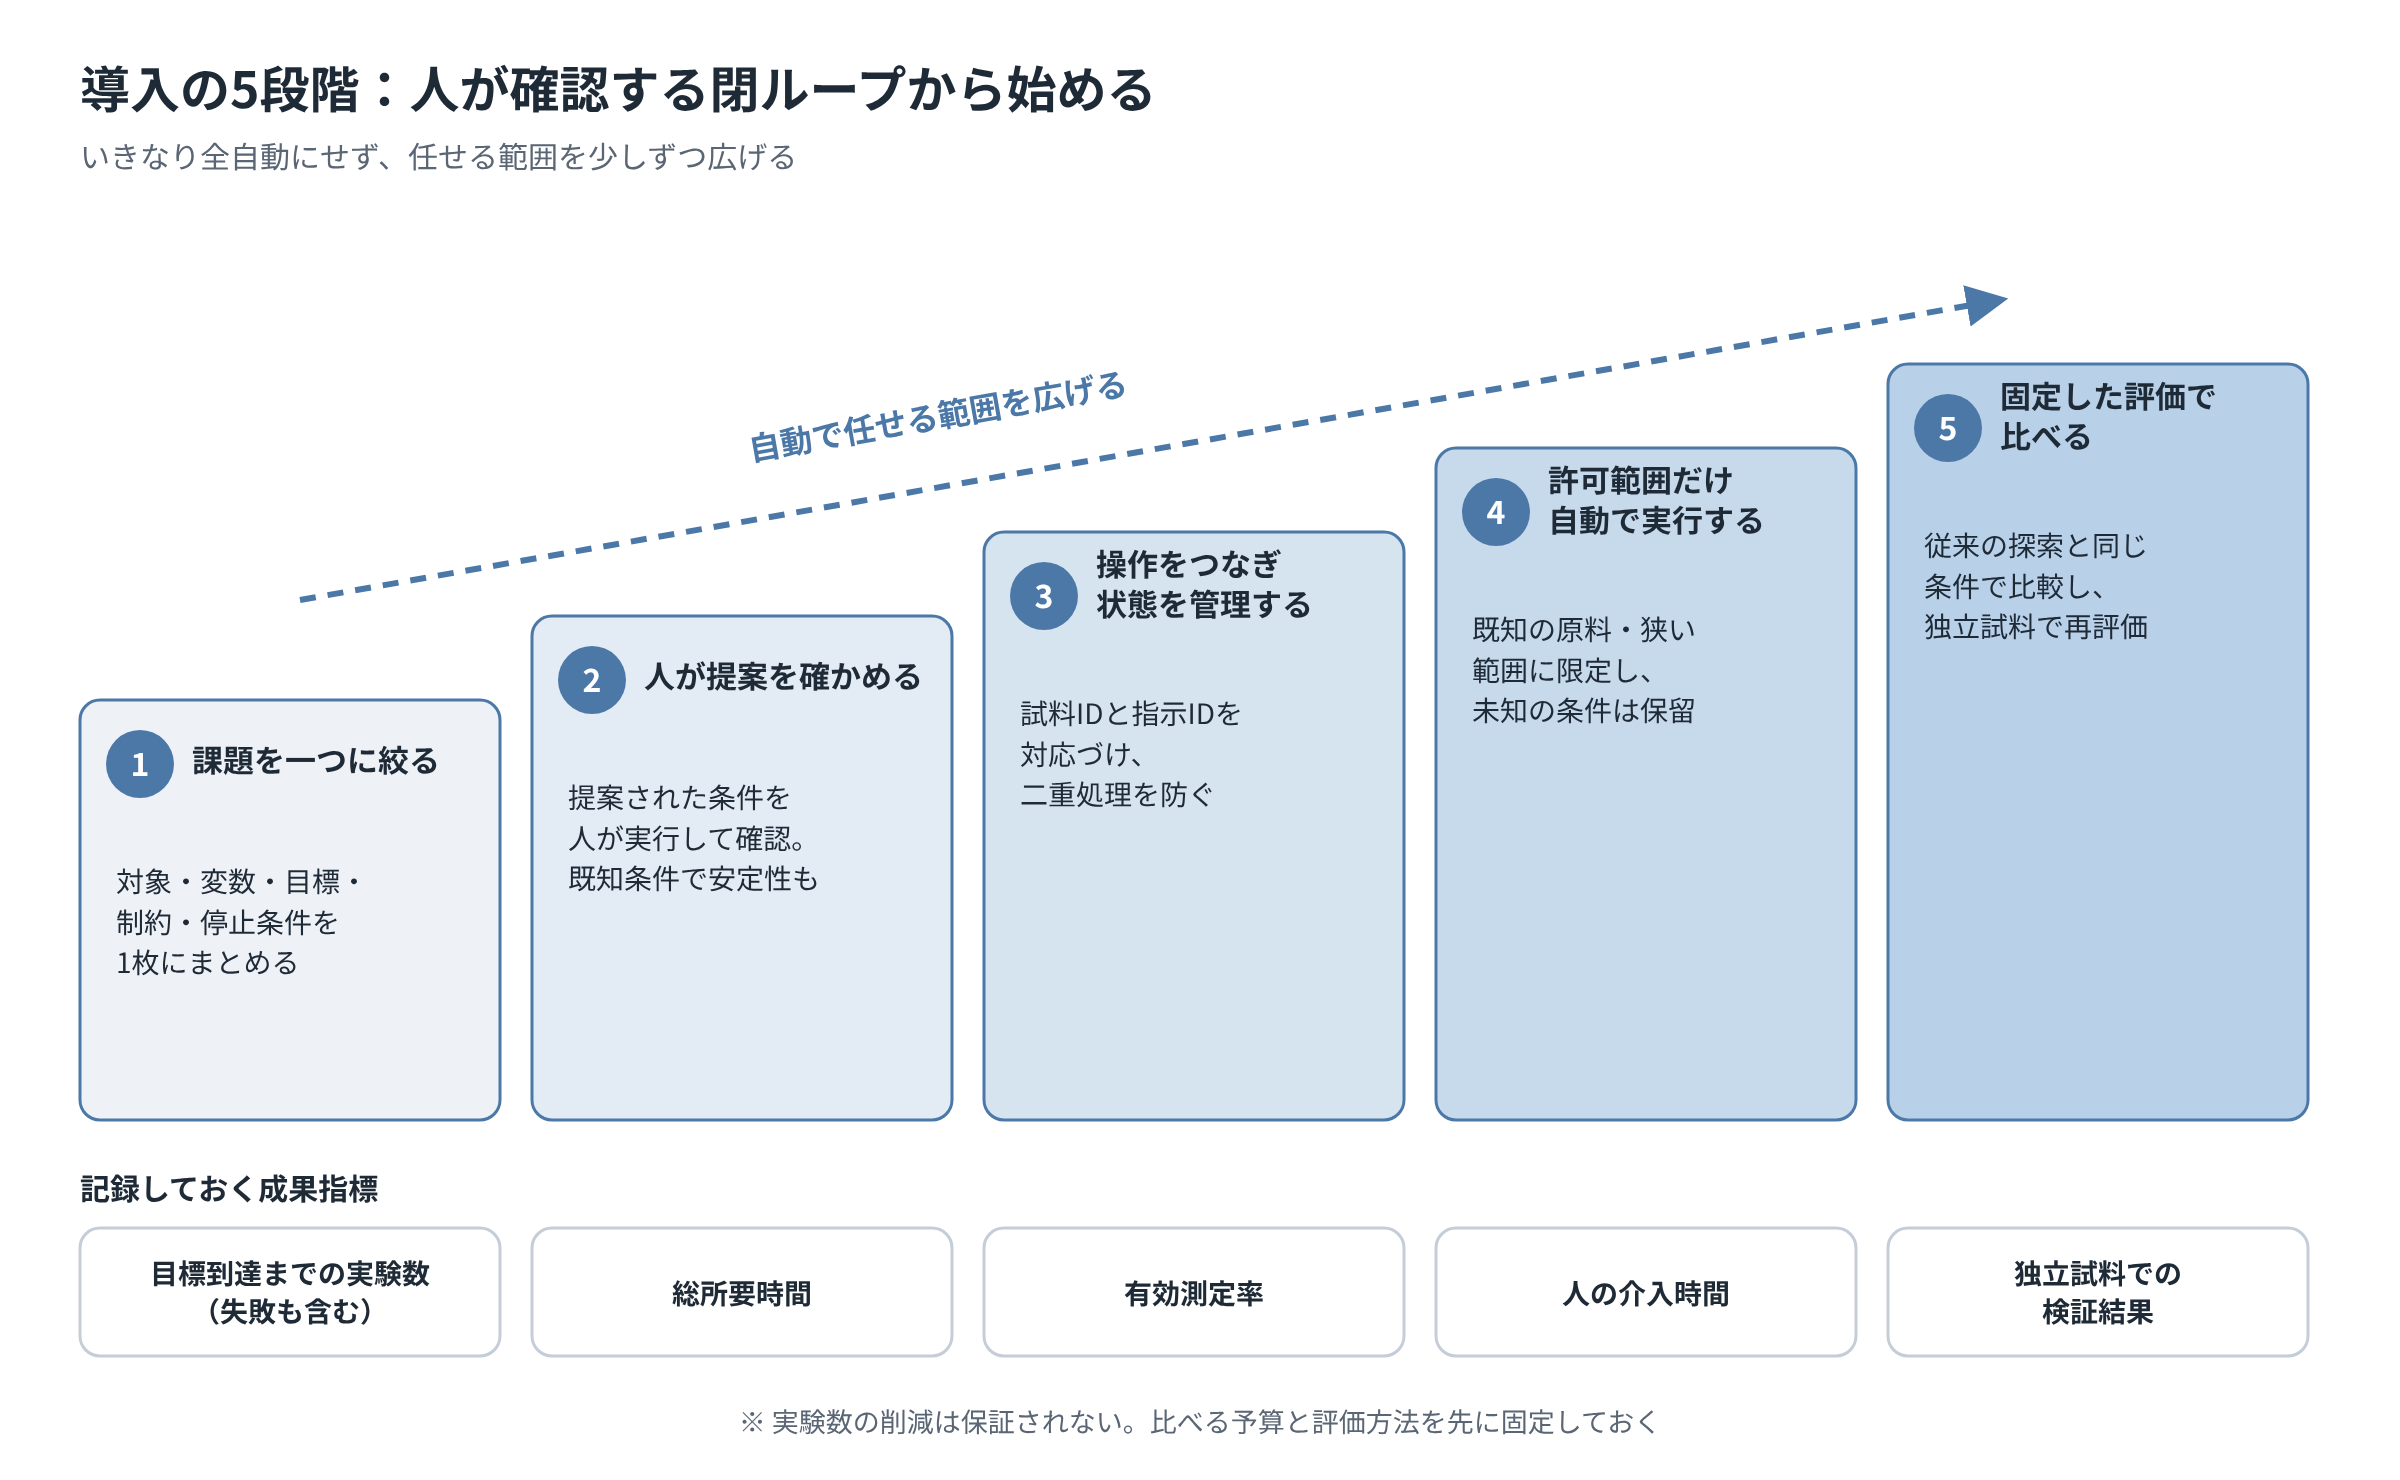
1.一つの研究課題と評価方法に絞る
対象材料、変える条件、目標指標、制約、停止条件を一枚にまとめます。何を探索しないかも明確にします。目的が「高性能」だけでは、速度、コスト、再現性のどれを重視するかが決まりません。複数の目標があるなら、優先順位や許容範囲を研究担当者が決めます。
2.人が行う実験でデータと提案を確かめる
最初は装置を自動操作せず、提案された条件を人が確認して実行します。提案の単位、範囲、実行可能性をチェックし、元データから評価値まで追跡できるかを確認します。少数の既知条件で測定手順の安定性を確認してから、探索範囲を広げます。
3.一連の操作を接続し、状態を管理する
装置ごとの実行中、完了、失敗、保留を明確にし、試料IDと指示IDを対応付けます。測定結果にはモデルの版、解析方法の版、装置条件を残します。通信が切れたときに同じ試料を二重処理しないか、完了通知だけ失われた場合に安全に確認できるかも検証します。
共有装置では、試料の待ち時間や順序も結果に影響する可能性があります。予約と実際の実行を区別し、待機による変質があるなら時間を記録します。探索アルゴリズムだけでなく、実験室の運用を一つのシステムとして扱います。
4.許可された範囲だけ自動実行する
最初は既知の原料と狭い条件範囲に限定します。候補提案の後に安全性・実行可能性を検査し、不適合なら保留します。探索範囲の拡張、原料の変更、手順の変更は、人の承認を伴う別の変更として扱います。
Human-in-the-loopでは、通常条件を自動実行し、未知条件を人へ確認し、装置異常で停止するなど、介入点を設計します。判断に必要な説明と時間、停止権限を確保してください。
5.固定した評価計画で成果を比較する
同じ課題、同じ予算、同じ測定系で従来の探索と比較します。対象条件と測定方法を固定し、探索後に最良候補を独立した試料で再評価してください。
| 指標 | 記録する内容 | 解釈上の注意 |
|---|---|---|
| 目標到達までの実験数 | 再測定・失敗も含む総試行数 | 成功した測定だけ数えない |
| 総所要時間 | 準備、待機、測定、解析、復旧を含む時間 | 装置の動作時間だけでは比較しない |
| 有効測定率 | 品質確認を通過した測定数/全試行数 | 無効となった理由も記録する |
| 人の介入時間 | 承認、補充、確認、障害復旧の時間 | 手作業削減と保守負担を分ける |
| 独立検証の結果 | 別試料・別日で目標を満たすか | 探索中の最高値だけを成果にしない |
これらは運用評価のための編集部の提案です。比較期間で原料や設備が変わった場合、性能差を自律実験の効果だけに帰属させないようにします。
現場への実装では、管理責任と業務上の成果をつなぐ必要があります。予測精度だけで取り組みを評価することの限界は、研究開発DXの進め方・KPIも参考になります。
導入効果を比較・検証する方法
自律実験の価値は、比較対象と同じ条件で測ります。新しい候補だけでなく、参照測定・失敗・再測定・独立検証に使う予算を先に配分してください。以下は編集部による評価設計の例です。
| 評価すること | 比較条件・記録 |
|---|---|
| 条件選択の効果 | 同じ初期データ、探索範囲、制約、総予算で従来計画やランダム探索と比較 |
| 目標到達 | 独立検証の判定方法を固定。未達も集計 |
| 総実験数 | 失敗、参照測定、再測定、最終検証を含める |
| 時間と負担 | 準備・待機・解析・復旧を含む所要時間と、人の介入時間 |
| 装置接続の価値 | 条件選択を同じにした手動運用と比較し、接続による時間短縮を分けて評価 |
| 持続的な運用 | 有効測定率、未処理の保留件数、復旧・保守の負担 |
Python例のcomparison.csvは、同じ初期条件・探索16回・検証2回で適応的選択とランダム選択を比べます。verified_target_metの達成率とverification_meanの分布を方法別に確認し、一つの良い実行だけで優劣を判断しません。実際の研究では材料ロットや測定日の影響も考慮します。
この比較は候補選択の教材であり、装置の自動化や所要時間の改善を検証するものではありません。また、探索途中で最大だった測定値と、独立検証の性能を分けて評価します。誤差で偶然高くなった候補を成果として扱わないためです。
失敗例:良い数字に見えても研究が進まない理由
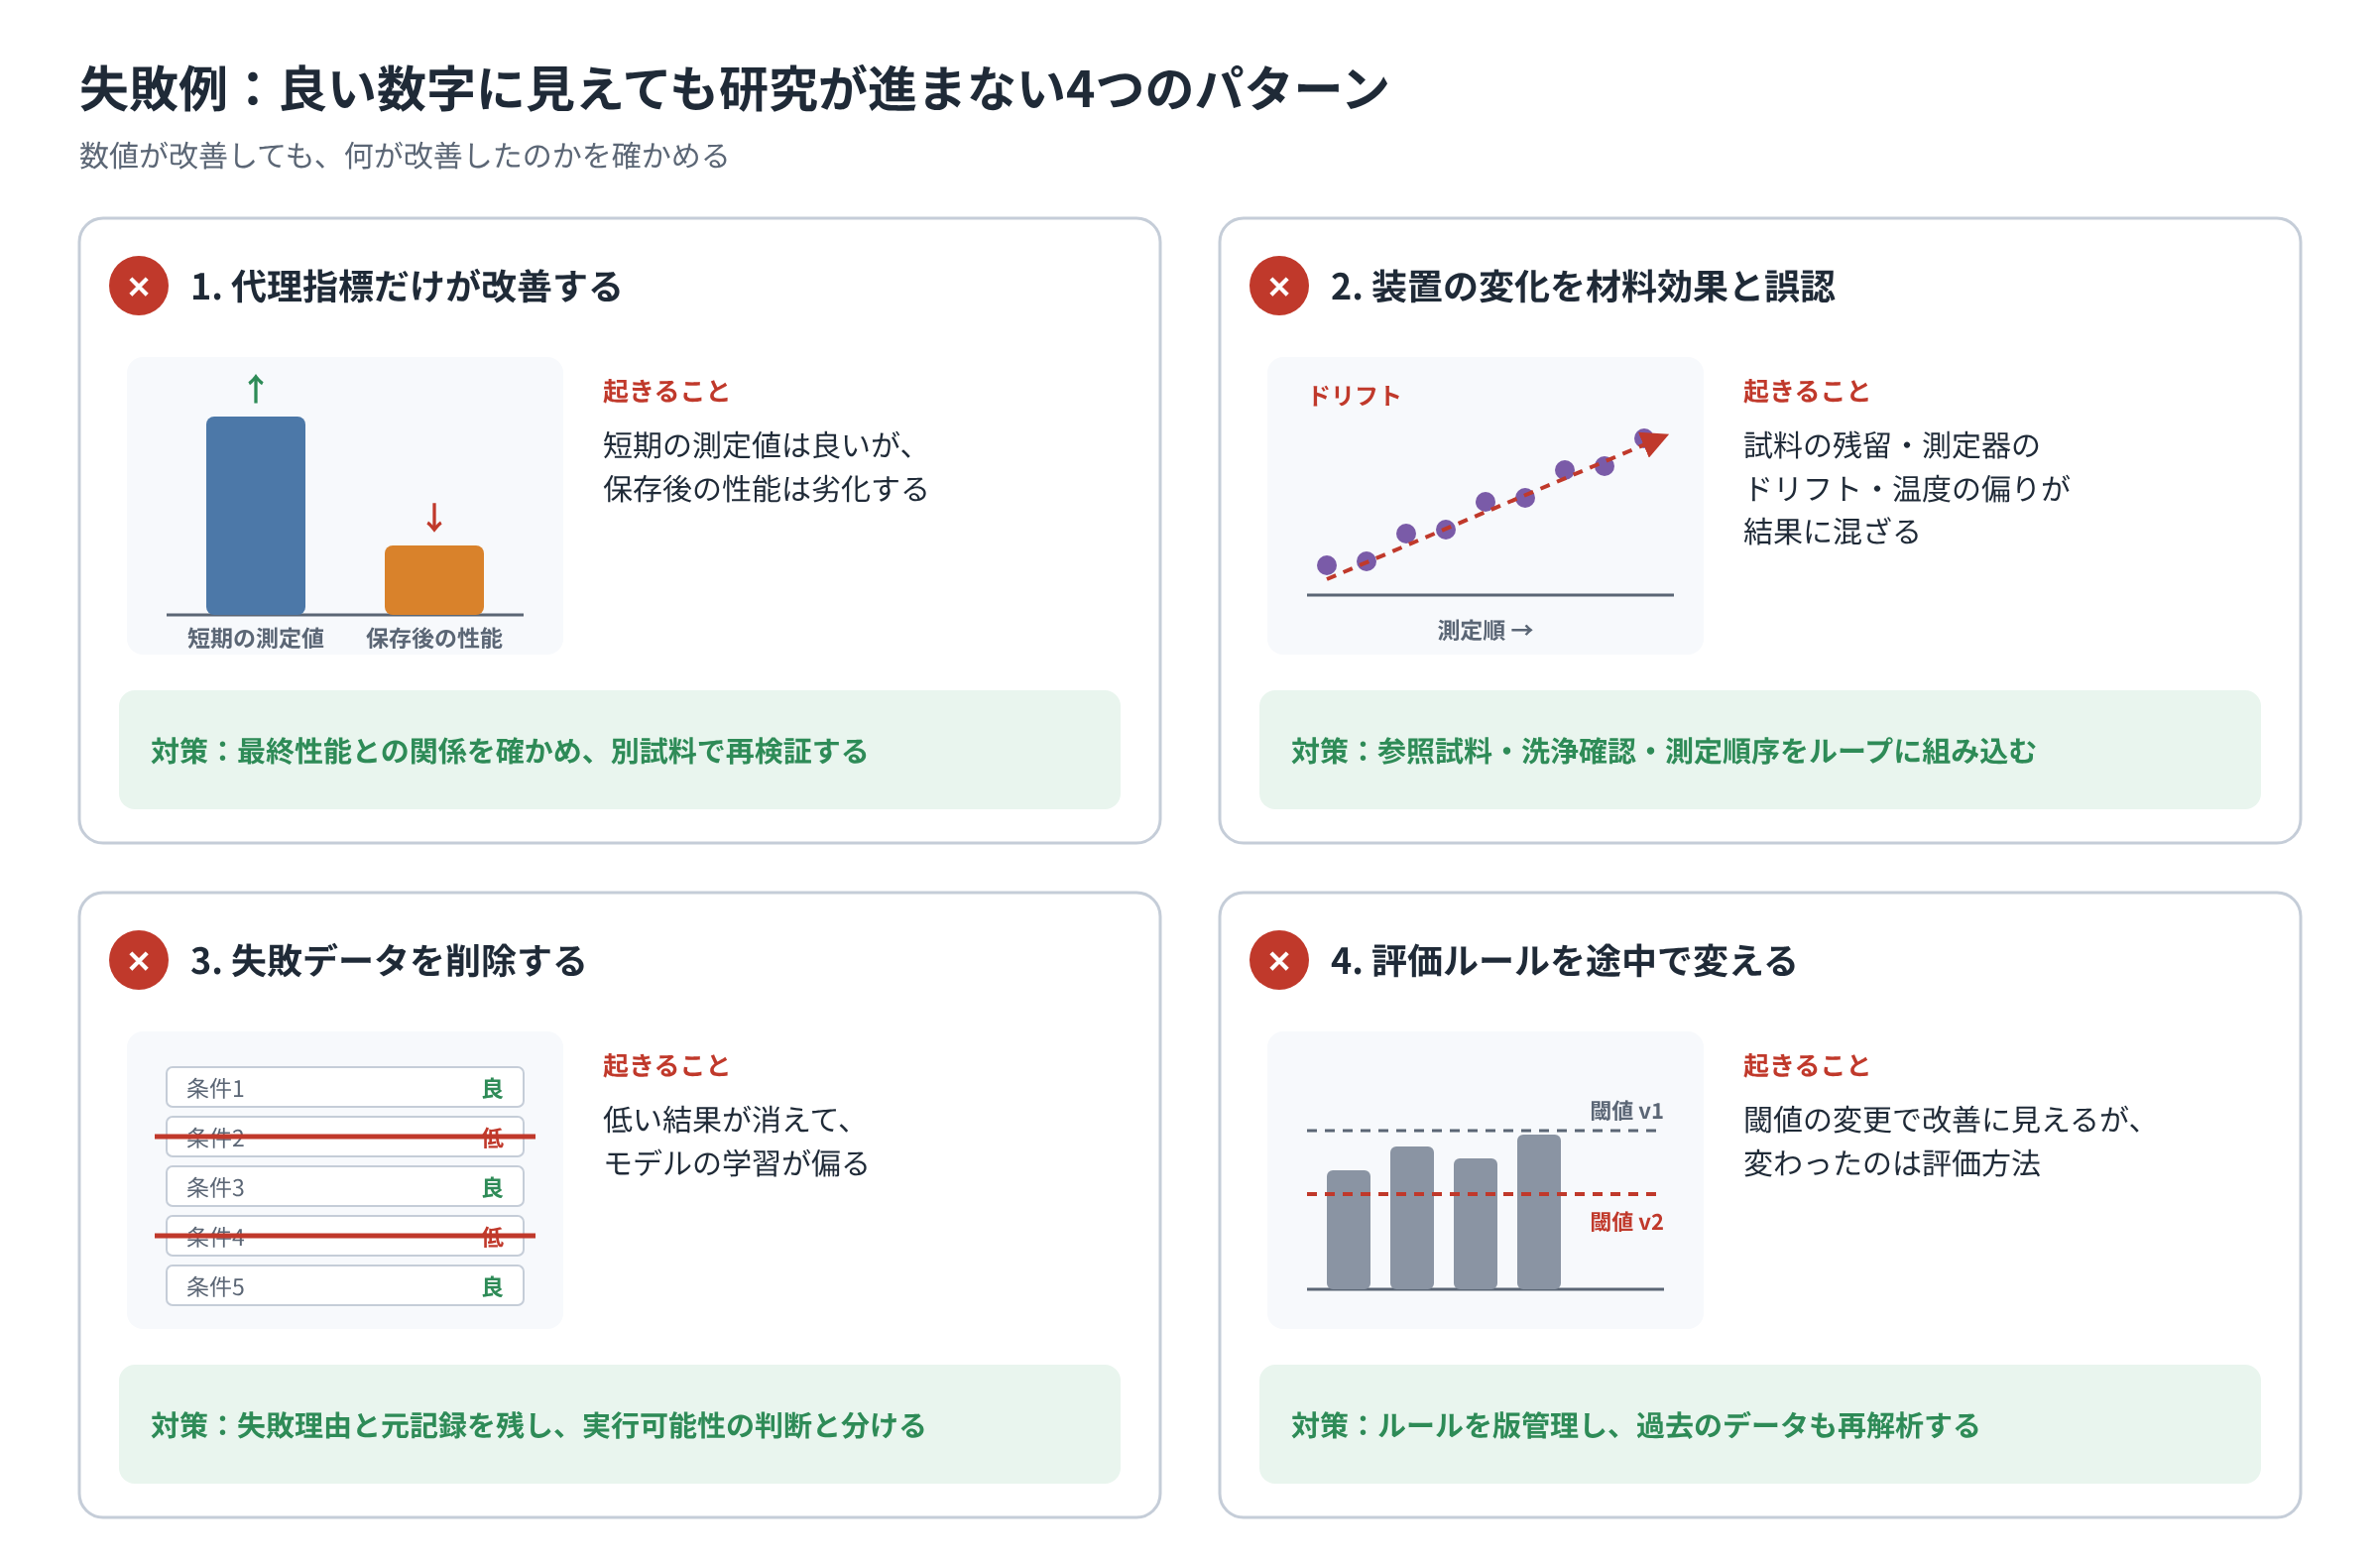
代理指標だけを改善する
速く測れる指標を最適化した結果、最終製品に必要な性能が改善しないことがあります。仮想例として、短時間の測定では良くても保存後に性能が落ちる材料が考えられます。短期の探索指標と最終の確認指標を分け、候補を別の日・別の試料で再検証します。
汚染や装置の変化を材料の効果と誤認する
試料の残留、測定器のドリフト、温度の偏りなどが、条件の効果に見えることがあります。アルゴリズムは高い値の原因が材料なのか測定系なのかを、データだけで正しく区別できるとは限りません。参照試料、洗浄確認、測定順序の検討をループに含めます。
失敗データを一律に削除する
低性能の結果を削除すると、モデルは不利な条件を学びにくくなります。一方、測定不能を任意の低い数値に置き換えると、存在しない性能値を学習します。失敗理由と元の記録を残し、性能のモデルと実行可能性の判断を必要に応じて分けます。
探索の途中で評価ルールを変える
途中で解析閾値を変えたのに同じ指標として集約すると、改善に見える変化が解析方法の変更かもしれません。変更は版管理し、必要なら過去データを同じ方法で再解析します。旧版の結果も保存し、どの判断に使われたかを追跡します。
技術的限界、不確かさ、安全性と責任範囲
自律実験は、設定した候補空間の外側まで自由に理解できるわけではありません。探索範囲に必要な条件が含まれていなければ、ループを長く回しても望む解に到達しません。改善が止まった際は、アルゴリズムの変更だけでなく、研究仮説と測定方法を見直す必要があります。
測定誤差、モデルの仮定、少数データ、未知の条件による不確かさが残ります。不確かさの数値が小さくても、モデルが誤った前提を持っていれば信頼できる保証にはなりません。予測と実測の比較、条件ごとの誤差、未知条件での保留を設計します。
生成AIが文献や手順から候補を提案する場合、存在しない出典、単位の取り違え、重要条件の省略が起こり得ます。自然言語の提案は、構造化された実行指示と安全検査へ変換し、出典と条件の妥当性を確認します。文章が自然であることを、装置が安全に実行できる根拠にしないでください。
安全制約は探索モデルと独立して確認できるようにします。既知の温度範囲内でも、原料の組合せや順序によってリスクが変わります。未知の操作を自動的に安全と扱わず、リスク評価、設備の保護機能、アクセス権限、停止後の手順を専門担当者と設計します。
自律実験の成果は、研究者による検証の対象です。材料の新規性、構造の同定、性能の再現性、用途への適合性は、単一の成功スコアでは証明できません。A-Labの訂正[5]は、自動判定された結果にも再解析と修正が必要になることを具体的に示しています。
研究目的、測定、安全範囲、モデル更新の承認者を定め、各判断で使った版と記録を残します。
導入前チェックリスト
- 目標指標と最終用途の関係を説明できる。
- 操作条件、禁止条件、組合せ制約を明示した。
- 試料・指示・測定・解析結果がIDでつながっている。
- 低性能、合成失敗、測定失敗を区別して記録する。
- 参照試料、校正、洗浄、再測定の計画がある。
- 未知条件・異常・通信断で停止または保留する。
- 研究者が介入する条件と復帰手順を決めた。
- 比較予算と成果指標を事前に固定した。
- 最良候補を独立した試料で確認する。
- モデル・解析・手順の版と承認者を追跡できる。
FAQ:よくある疑問
ロボットアームは必須ですか?
必須ではありません。ポンプや自動測定装置などで必要な操作を実行できれば、閉ループを構成できます。まず自動化したい仕事と測定系を定義し、その後で機器を選びます。
生成AIだけで自律実験をつくれますか?
提案や記録整理を支援できますが、測定、制御、品質確認、安全検査、状態管理が別途必要です。生成AIの出力をそのまま装置に渡す構成ではなく、検証可能な指示へ変換する仕組みを設計します。
少数データでも始められますか?
狭い範囲の条件探索は検討できます。ただし、測定の再現性と初期条件の偏りを確認してください。利用できる実験数を探索だけに使わず、既知条件と再測定にも配分します。
自律実験なら必ず実験数が減りますか?
保証はありません。探索空間、測定ノイズ、制約、目標によって変わります。比較対象を決め、実験数だけでなく総時間と人の介入も含めて評価します。
成功した候補をそのまま量産へ移せますか?
別の検証が必要です。ラボでの条件と量産で材料が受ける履歴が一致するとは限りません。設備差、品質管理、安定性、コストを確認し、自律探索の成果と製造条件の確立を分けます。
まとめ
自律実験は、実験計画・実行・評価・次の判断をつなぐ閉ループです。材料開発を加速するには、アルゴリズムだけでなく、安定した測定、記録、失敗処理と人の介入点が必要です。
最初は一つの課題で、人が確認できる小さなループをつくってください。比較基準と停止条件を決め、独立した測定で成果を確かめてから範囲を広げます。研究者の役割は、手作業を繰り返すことから、研究目的、評価の妥当性、安全性と成果の確証を設計することへ広がります。
参考文献
[1]MacLeod, B. P. et al. Self-driving laboratory for accelerated discovery of thin-film materials. Science Advances, 2020, 6(20), eaaz8867. DOI: 10.1126/sciadv.aaz8867. 書誌・抄録。
[2]Tamura, R.; Tsuda, K.; Matsuda, S. NIMS-OS: an automation software to implement a closed loop between artificial intelligence and robotic experiments in materials science. Science and Technology of Advanced Materials: Methods, 2023, 3(1), 2232297. DOI: 10.1080/27660400.2023.2232297. NIMS公式発表(2023年7月20日)。
[3]Sim, M. et al. ChemOS 2.0: An orchestration architecture for chemical self-driving laboratories. Matter, 2024. DOI: 10.1016/j.matt.2024.04.022。
[4]Szymanski, N. J. et al. An autonomous laboratory for the accelerated synthesis of inorganic materials. Nature, 2023, 624, 86–91. 2026年の訂正反映済み本文を参照. DOI: 10.1038/s41586-023-06734-w。
[5]Szymanski, N. J. et al. Author Correction: An autonomous laboratory for the accelerated synthesis of inorganic materials. Nature, 2026, 650, E1. 2026年1月19日オンライン公開. DOI: 10.1038/s41586-025-09992-y. 著者所属大学掲載PDF。
[6]Xu, G.; Zhang, R.; Luo, T. Self-Driving Laboratory Optimizes the Lower Critical Solution Temperature of Thermoresponsive Polymers. Advanced Intelligent Discovery, 2026, e202500177(Early View). 2026年1月29日オンライン公開. DOI: 10.1002/aidi.202500177。
[7]Liang, H. et al. Self-driving thin film laboratory: autonomous epitaxial atomic-layer synthesis via real-time computer vision analysis of electron diffraction. arXiv, 2026年2月24日. プレプリント. arXiv:2602.20432。
資料確認日:2026年10月5日。文献[6]は雑誌掲載版へ更新しました。文献[7]は引用したプレプリントの報告として紹介し、査読済み論文とは区別しています。