
「実験を何回すればよいか」「直交表に条件を入れれば十分か」「因子を一つずつ変える方法では何が足りないか」。材料開発で実験計画法を使い始めると、この三つの疑問にぶつかります。条件表を作る前に決めるべきなのは、今回の実験から何を判断したいかです。
実験計画法(DOE:Design of Experiments)は、因子の効果や交互作用を調べ、条件の比較や最適化に必要な情報を得るために、実験条件・実験順序・反復の取り方を設計する方法体系です。単なる実験回数の削減術ではありません。推定したい関係と、実際に得られるデータを対応させることが中心になります[1]。
本記事では、一元配置法・二元配置法・直交表・D最適計画を、条件表と材料研究の利用場面から解説します。MIの初期データ設計に使うLHS、応答曲面、混合計画との違いも整理し、計画を選んで実験・解析・確認へ進むための基礎を示します。
先に結論
- 条件表より先に、目的・応答・実験単位・制約を決める。
- 重要因子を絞る計画と、交互作用や曲率を推定する計画は同じではない。
- 独立反復、無作為化、ブロック化を、設備の実情に合わせて組み込む。
- 直交表や部分実施要因計画では、効果の交絡を確認する。
- モデルの確認と独立した確認実験を含めて、実験予算を配分する。
実験計画法とは?「知りたいこと」とデータをつなぐ方法
実験計画法では、変更する入力を「因子」、測定する出力を「応答」と呼びます。例えば、乾燥温度と乾燥時間を変えて膜の残留溶媒量を測るなら、温度・時間が因子、残留溶媒量が応答です。どの組合せを、どの順序で、どれだけ繰り返すかを事前に考えます[1]。
このとき「性能が上がったか」と「なぜ上がったか」は別の問いです。候補条件の比較だけなら単純な設計で足りる場合があります。温度と時間の交互作用を区別したいなら、それを識別できる組合せが必要です。応答の途中にピークがあると考えるなら、曲率を調べられる設計へ進みます。
また、DOEは一度ですべてを解決する方法ではありません。NISTの手順は、目的設定、変数選択、計画選択、実施、仮定の確認、解析、結果の利用という流れを示し、結果に応じて小さな実験を段階的に追加する考え方を説明しています[2]。
最初の計画を小さくすることと、根拠の弱い結論で打ち切ることは別です。どこまで分かったら次へ進むかを先に決め、確認に必要な実験を残しておきます。
数値例で理解する主効果と交互作用
膜の乾燥温度と時間を変え、値が大きいほどよい品質指標を測る仮想例です。実測値でも、推奨運転条件でもありません。
| 乾燥温度 | 短時間 | 長時間 | 時間を平均した値 |
|---|---|---|---|
| 低温 | 40 | 70 | 55 |
| 高温 | 80 | 60 | 70 |
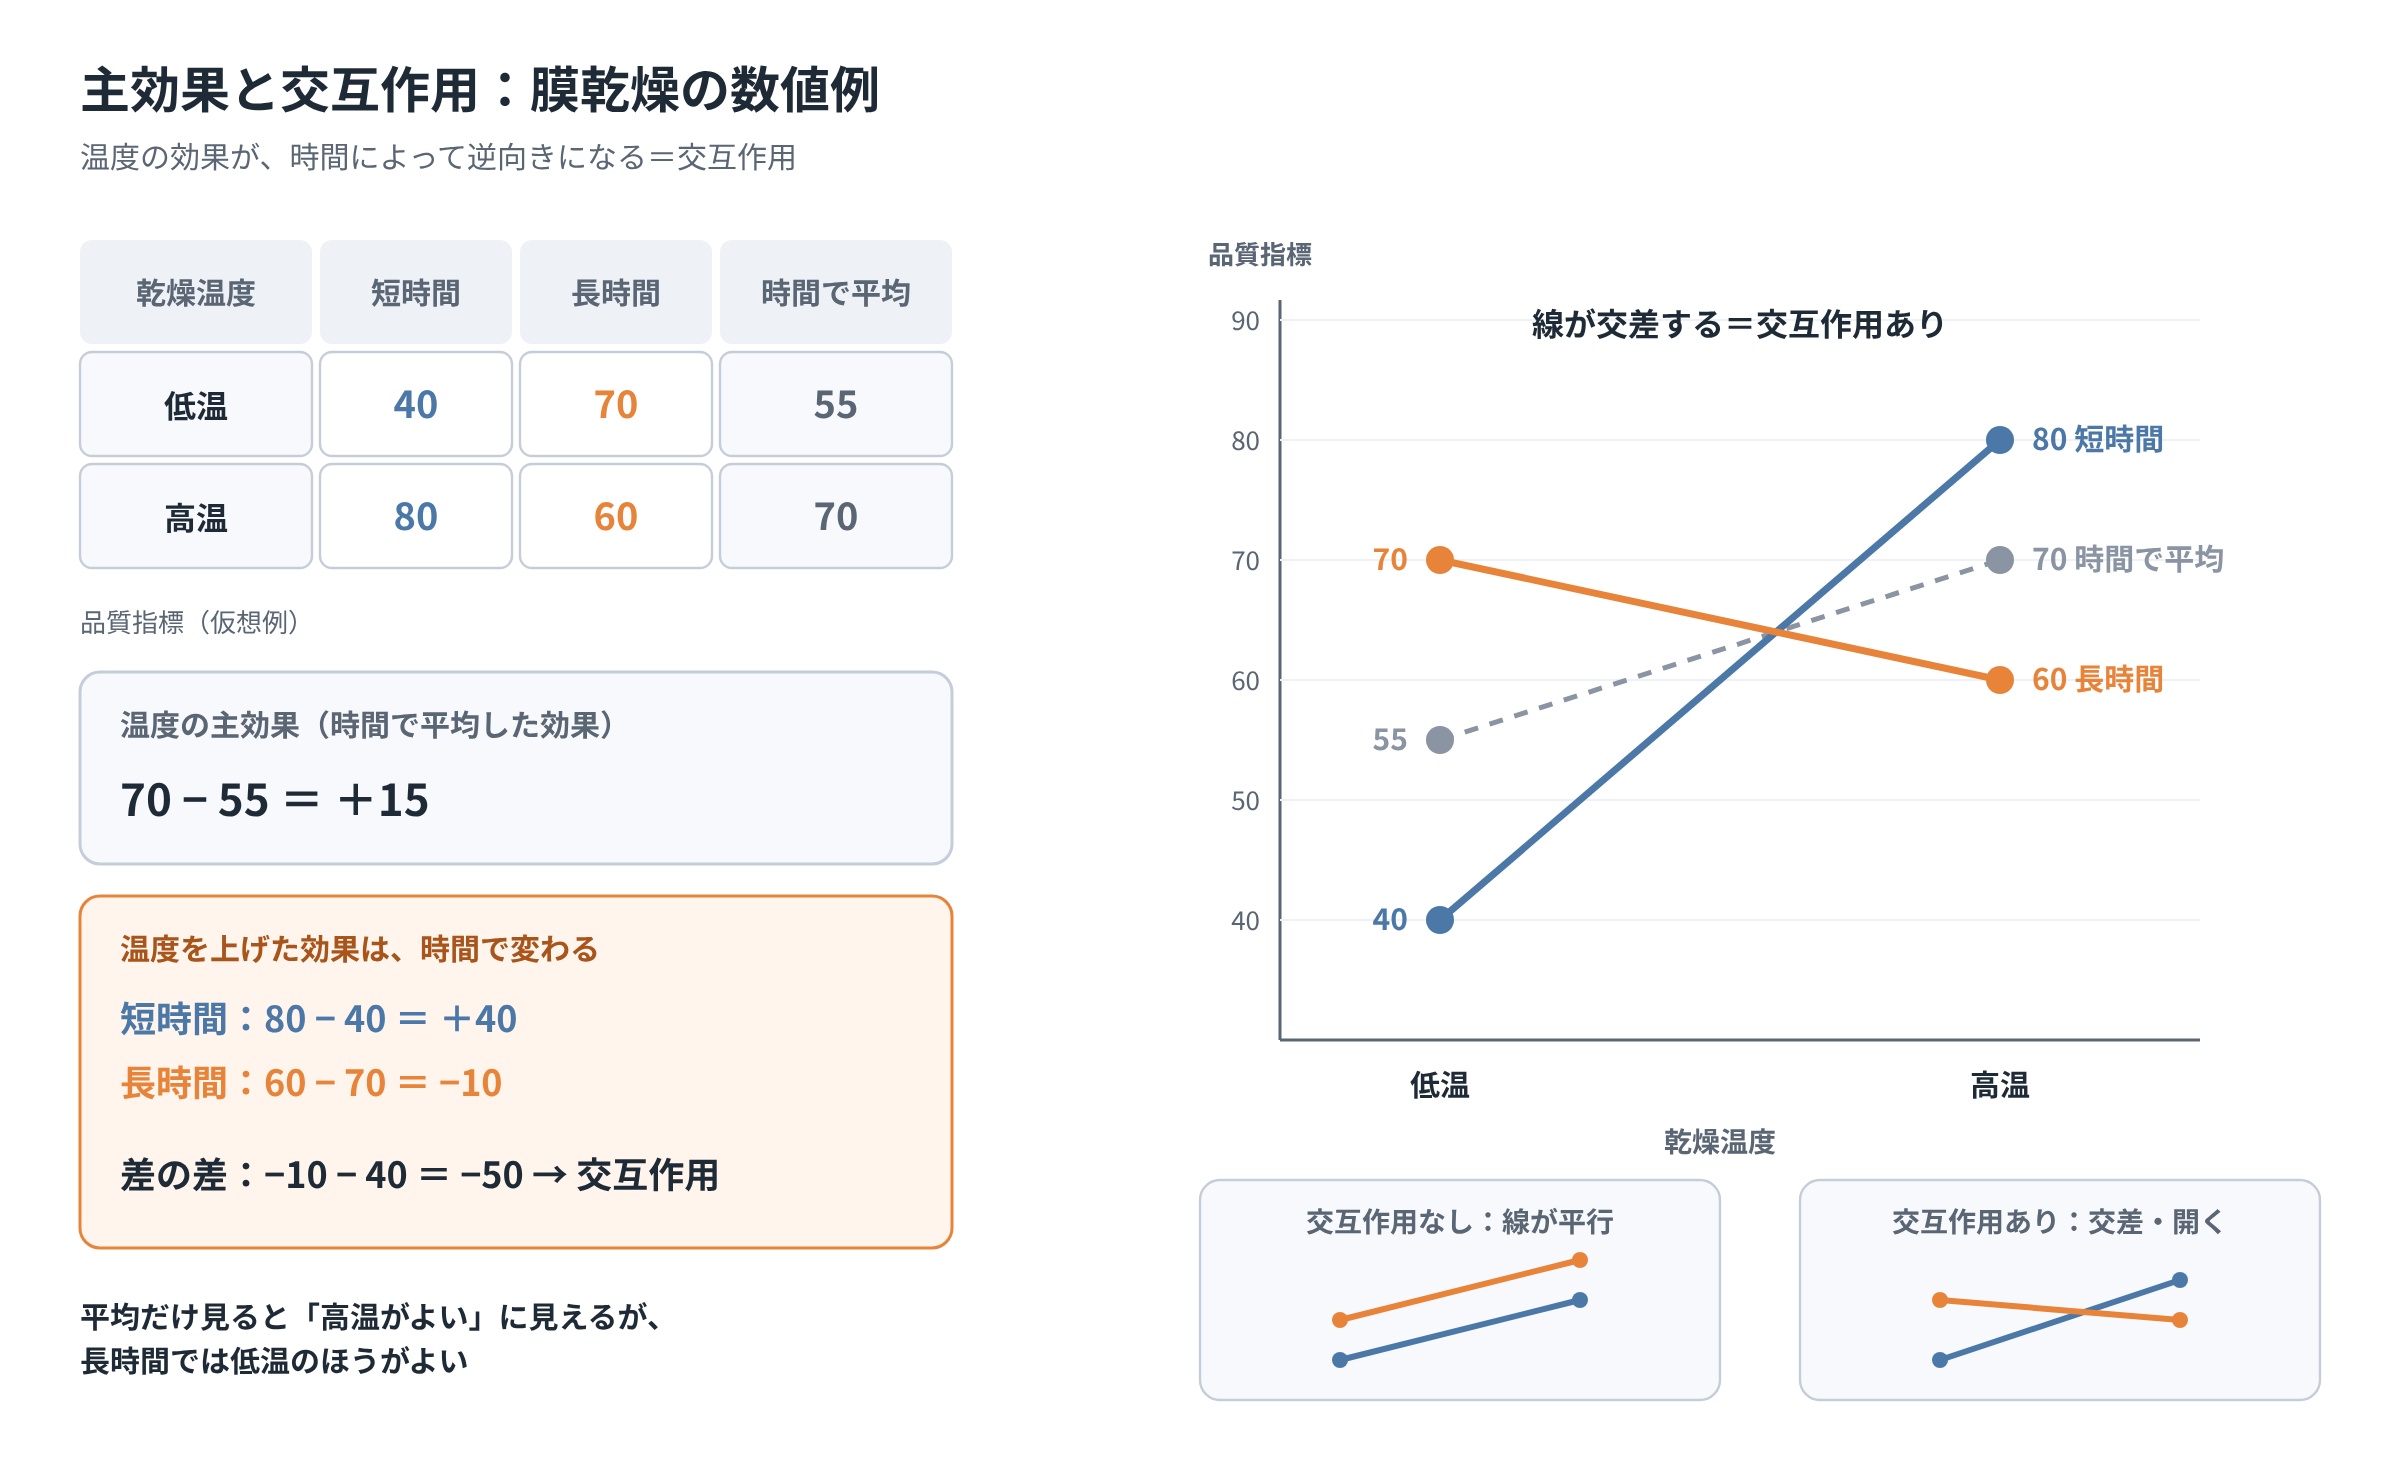
温度の平均的な効果は70−55=+15です。しかし、短時間で温度を上げた効果は80−40=+40、長時間では60−70=−10です。温度の効果が時間によって変わり、差の差は−10−40=−50となります。これが交互作用の具体的な意味です。
短時間だけを試して「高温がよい」と判断すると、長時間では逆の結果になります。この例では高温・短時間を確認実験の候補にできますが、4点だけで再現性や水準間の最適条件を断定できません。各条件の独立反復でばらつきを評価し、候補を新たな試料・別日で確認します。OFATとの詳しい比較は後半で説明します。
最初に読む順序
初めてDOEに触れる場合は、基本用語、一元配置、二元配置、反復・無作為化・ブロック化の順に読み、直交表とD最適計画へ進むと理解しやすくなります。主効果を絞る目的と、交互作用・曲率を推定する目的を分けて計画を選びます。
材料研究者が押さえたい基本用語
| 用語 | 意味 | 現場での確認点 |
|---|---|---|
| 因子 | 実験で変更する変数 | 設定値と実測値を区別する |
| 水準 | 因子に設定する値・種類 | 実施可能範囲と選定理由を記録する |
| 応答 | 評価する結果 | 単位、測定法、採用基準を統一する |
| 主効果 | 他の条件について平均した、因子の水準変更による応答の差 | 交互作用が強いと平均だけでは説明が不足する |
| 交互作用 | ある因子の効果が、別の因子の水準に依存すること | 単独因子の順位だけで結論を出さない |
| 実験単位 | 条件を独立に割り当てる最小の単位 | 試料、合成バッチ、炉の運転などを区別する |
| 交絡 | 複数の効果をデータから分離して推定できない状態 | 無視してよい効果の仮定を明示する |
| 確認実験 | 得られた結論や提案条件を追加実験で確かめること | モデル作成に使ったデータだけで採用しない |
主効果と交互作用は、単に「相関がある」という意味ではありません。二因子モデルでは、各因子の項に加えて両者の積の項を用い、条件の組合せで効果が変わる関係を表します[1]。ただし、推定結果の物理的な意味は、材料分析や追加実験と合わせて判断します。
一元配置法:一つの因子について、水準間の差を調べる
一元配置法は、一つの因子の複数水準を比較する実験配置です。例えば粉体の表面処理方法A・B・Cによって、分散後の粒径が変わるかを調べます。「一元」は因子が一つという意味で、水準が一つという意味ではありません。各条件を実験単位へ無作為に割り付け、結果を一元配置分散分析などで解析します[13]。
次は説明用の仮想計画です。各処理で独立に粉体を調製した後、同じ測定手順で評価します。
| 処理方法(因子の水準) | 独立な調製 | 主な記録 |
|---|---|---|
| A | 3バッチ | 各バッチの粒径、調製日、原料ロット |
| B | 3バッチ | 同上 |
| C | 3バッチ | 同上 |
この例は3水準×3独立反復=9バッチです。「3反復」は説明のための設定で、必要数の推奨値ではありません。想定する差、ばらつき、誤判断の許容度から反復数を検討します。同じ分散液を3回測定するだけでは、3バッチを調製したことにはなりません。
解析では何を確認するのか
分散分析は、水準間の平均の違いを、水準内のばらつきと比較します。「すべての平均が等しい」という仮説に対して差を調べますが、有意な結果だけでは、どの組合せが違うかまでは決まりません。必要に応じて事前に定めた比較や多重比較を行い、平均差・不確かさ・実用上の改善量を併記します[13]。
独立性、残差の分布、ばらつきの均一性も点検します。日やロットが処理と重なる場合は、一元配置で単純に処理差と解釈せず、ブロックや階層を含む設計・解析を検討します。
使いどころ:粉体処理の比較、材料グレードの選定、測定前処理の比較など、関心のある因子が一つに絞られた課題です。一元配置法とOFATは同義ではありません。OFATは複数因子を扱う際に一つずつ動かす進め方、一元配置は一因子の比較配置です。
二元配置法:二つの因子と、その組合せの効果を調べる
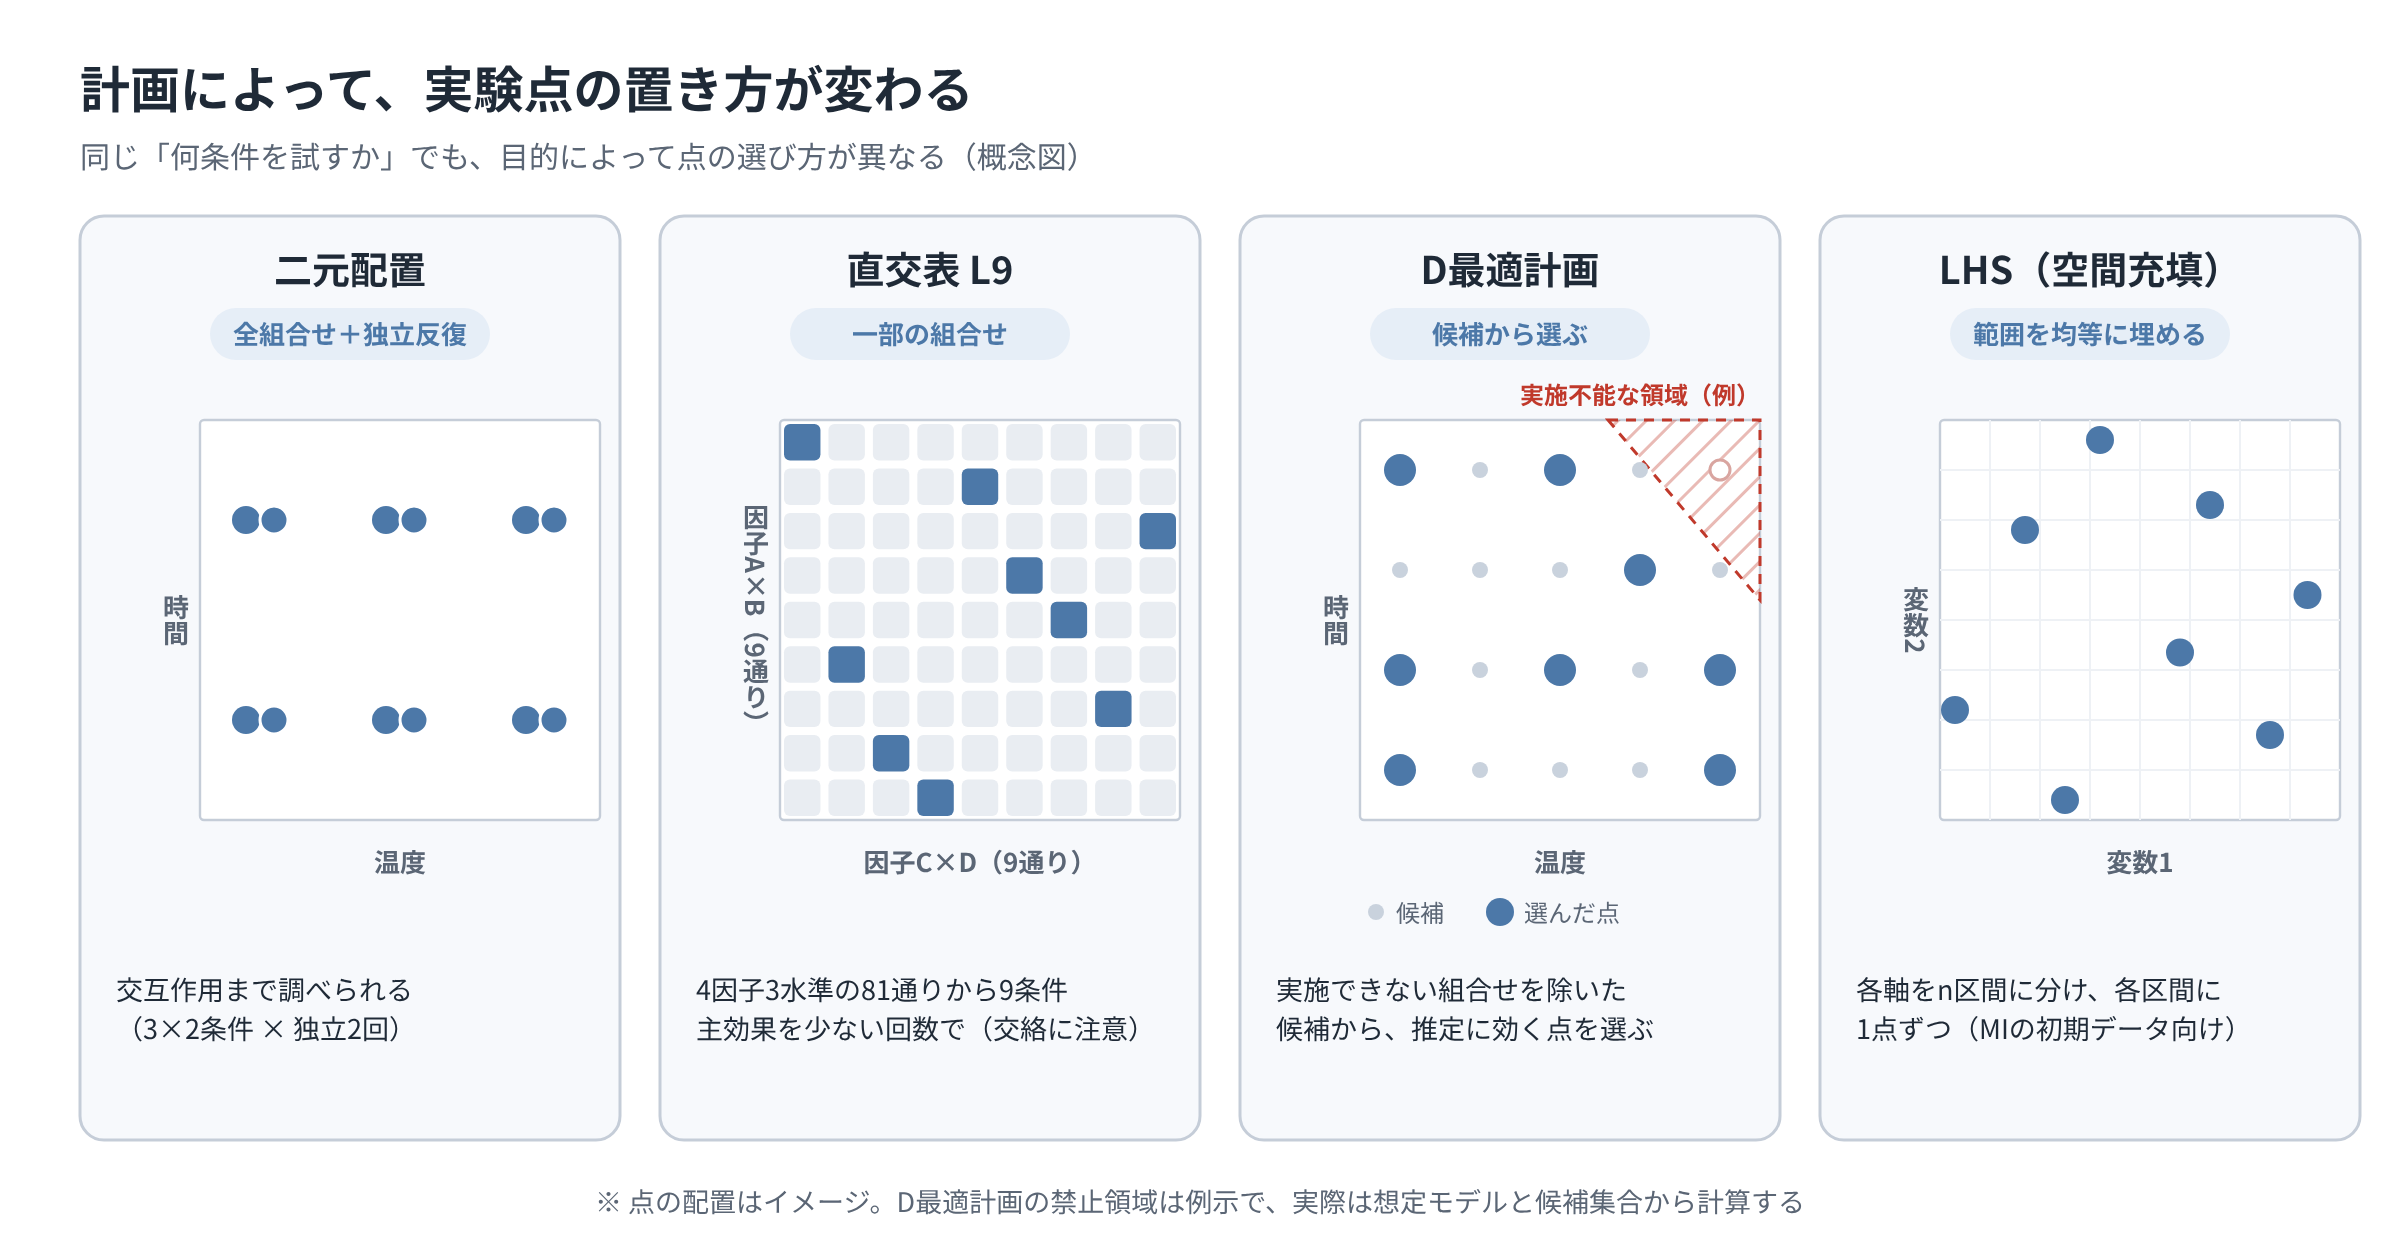
二元配置法は、二つの因子を組み合わせて配置する方法です。「二元」は二因子、「二水準」は一因子に設定する値が二つという意味で、別の概念です。例えば、焼結温度を3水準、保持時間を2水準とすれば、全組合せは3×2=6条件になります。各条件で独立に2回焼結すれば、合計12回の実験です[14]。
| 焼結温度 | 保持時間:短 | 保持時間:長 |
|---|---|---|
| 低 | 独立2回 | 独立2回 |
| 中 | 独立2回 | 独立2回 |
| 高 | 独立2回 | 独立2回 |
数値温度は材料と設備に応じて決めます。この表は説明用で、実際の運転条件ではありません。温度を炉の運転ごとに変え、同じ運転内で複数試料を処理するなら、試料数と独立な炉の運転数を区別します。
主効果だけでなく、交互作用を見る
解析する関係は「全体平均+温度の効果+時間の効果+温度×時間の交互作用+誤差」です[14]。低温では長時間が有利でも、高温では長時間にすると欠陥が増えるなら、温度の効果は時間に依存します。交互作用が強い場合、平均した主効果だけで「高温がよい」と結論づけず、条件ごとの違いを示します。
実務では組合せごとの平均と個々の測定点を描き、時間別に温度と応答の関係を線で結ぶと理解しやすくなります。カテゴリとしての比較が目的なら分散分析、温度・時間の連続的な関係を推定したいなら回帰や応答曲面も検討します。
反復なしの注意:各組合せを1回ずつ測定して、交互作用まで含む完全なモデルを当てはめると、誤差を独立に推定する残差自由度がなくなります。交互作用を除いた解析には、それを無視できるという仮定が必要です。反復なしの二元配置を、交互作用まで十分検証できる計画と扱わないようにします。
使いどころ:熱処理温度×時間、材料種×表面処理、成形圧力×乾燥条件など、二因子の組合せを理解したい課題です。一方を日や装置という背景因子にする場合は、二つとも最適化対象という扱いにはせず、ブロック計画として目的を明示します。
直交表:少ない組合せで、複数因子の主効果を調べる
直交表は、因子の水準が偏らず組み合わされるように作られた実験配置表です。例えばL9は、4列に三水準の因子を配置できる9行の表です[15]。全組合せを試す3の4乗=81条件と比べて少ない条件を実施できますが、同じ情報をすべて取得できるわけではありません。
例として、粉末成形でA=成形圧力、B=保持時間、C=原料の粒径区分、D=乾燥条件を各三水準で扱います。次は標準的なL9の配置です。1・2・3は水準番号であり、実施順や性能順位ではありません。
| 条件番号 | A | B | C | D |
|---|---|---|---|---|
| 1 | 1 | 1 | 1 | 1 |
| 2 | 1 | 2 | 2 | 2 |
| 3 | 1 | 3 | 3 | 3 |
| 4 | 2 | 1 | 2 | 3 |
| 5 | 2 | 2 | 3 | 1 |
| 6 | 2 | 3 | 1 | 2 |
| 7 | 3 | 1 | 3 | 2 |
| 8 | 3 | 2 | 1 | 3 |
| 9 | 3 | 3 | 2 | 1 |
Aの水準1の平均は条件1・2・3、水準2は条件4・5・6、水準3は条件7・8・9から計算できます。Aの各水準でB・C・Dの各水準が均等に現れるため、主効果を比較しやすい配置になります。実施する際は条件番号の順番をそのまま使わず、設備制約を踏まえて実施順を設計します。
L9の9条件で、何が分からないのか
三水準因子の主効果には2自由度が必要です。4因子なら2×4=8自由度で、9観測の全体平均を除く8自由度を使い切ります。各条件1回、4因子のカテゴリ主効果をすべて含むモデルでは、残差自由度が残りません。この状態で誤差が分かったかのように有意差を判断できません。
さらに、二つの三水準因子の交互作用には4自由度が必要です。4因子を満載したL9では、主効果と全交互作用を独立に推定できません。関心のある交互作用があるなら、因子を減らす、配置を変える、別計画へ進むなどを検討します。独立反復を加えると誤差推定は可能になりますが、同じ9条件を繰り返すだけでは元の交絡は解消しません。
使いどころ:実施可能な組合せに大きな制約がなく、まず主効果を中心に工程因子を比較したい場面です。強い交互作用が予想される探索や、機械学習で広い領域の非線形関係を予測するデータ収集には、そのまま十分とは限りません。
また、直交表を使うこととタグチメソッド全体は同義ではありません。タグチの頑健設計では、制御因子とノイズ因子を分け、変動に強い条件を検討する考え方もあります。SN比などを用いるときは、何を品質の良さとするかを定義します[18]。
L9では交互作用が特定の列へ現れ、主効果と混ざる
本記事の標準L9では、第1列にA、第2列にBを割り付けると、A×Bの交互作用の4自由度は、第3列・第4列の主効果が占める空間に対応します。この配置に基づく性質で、単に「交互作用を調べられない」というだけではありません。第3列にC、第4列にDを入れた場合、C・Dの効果として見える差に、A×Bの交互作用が混ざる可能性があります[15]。
例えば成形圧力と保持時間の組合せが性能へ強く影響するとき、別の列へ割り付けた粒径や乾燥条件を重要因子と取り違えるおそれがあります。ここでいう「特定列へ現れる」は交互作用成分が列の効果と交絡する意味であり、交互作用が一つの列だけに丸ごと現れるという意味ではありません。強い交互作用が予想される場合、L9へ4因子を満載して主効果だけを解釈する使い方には注意が必要です。
L18などの混合直交表を有力な選択肢にする
標準的なL18(2¹×3⁷)は18条件で、二水準因子を1つ、三水準因子を最大7つ扱える混合直交表です。材料種を二水準、温度・時間・添加量などを三水準にしたい場合、表に合わせて無理に水準数をそろえるより、L18を検討することを勧めます。三水準因子のみでも、主効果を調べる目的で候補になります[15]。
L18では交互作用の影響が複数列へ分散する場合があり、L9の特定列への交絡とは異なる性質を利用できます。ただし、交互作用の影響が消えるわけではなく、すべての列への割付が同じ性質を持つわけでもありません。宮川・吉田の研究は、L18の主効果と交互作用の交絡を分類し、割付による違いを検討しています。公開抄録では、三水準因子だけを最大6因子扱う場合、第3列以降へ割り付ける方法が交絡を抑えると示されています。これは同論文で検討した条件での指針で、あらゆる課題に共通する割付規則ではありません[19]。
| 目的・条件 | 検討する計画 | 確認すること |
|---|---|---|
| 少数の三水準因子を少ない条件で調べる | L9 | 交互作用の交絡と誤差推定の余地 |
| 二水準・三水準が混在し、主効果を調べる | L18などの混合直交表 | 列への割付、交互作用による主効果の偏り |
| 三水準因子の主効果を調べ、L9の交絡が懸念される | L18を比較検討 | 採用列の交絡構造と追加実験の必要性 |
| 特定の交互作用を分離して推定する | 完全実施要因計画・対象の交互作用を含むD最適計画など | 必要な項の推定可能性、ランク、反復 |
L18は主効果の探索に有力ですが、「交互作用まで自動的に分かる表」として選ぶものではありません。二水準1因子と三水準7因子の主効果をすべて入れると、切片を含めて16係数となり、18観測では主効果モデルの残差自由度は2です。その残差には未モデル化の交互作用なども入り得るため、純粋な実験誤差と同一視せず、独立反復と確認実験を別途検討します。
D最適計画:モデルと実施可能な候補に合わせて、実験点を選ぶ
D最適計画は、事前に決めたモデルの係数を効率よく推定するために、実験条件を計算で選ぶ方法です。直交表へ入らない混合水準、実施不能な組合せ、任意の実験予算を扱うときに検討できます。独立・等分散の誤差を持つ線形モデルを前提に、モデル行列Xの情報行列XTXの行列式を大きくし、係数推定の不確かさを全体として小さくする基準を使います[16]。
「モデル行列」は条件表そのものではなく、切片、因子、交互作用、二乗項、カテゴリの符号化など、推定する項を列にした行列です。D最適の「最適」は、このモデルと候補集合、実験数、誤差の仮定に対する意味です。材料性能を直接最大化するという意味ではありません。
材料研究での設計手順
- 候補集合:例えば材料グレード3種、温度5水準、時間4水準の60候補を作り、既知の実施不能な組合せを除く。
- モデル:グレードのカテゴリ効果、温度・時間の一次項、温度×時間、必要な二乗項などを事前に指定する。
- 予算:独立反復と確認実験を含む総予算を決め、設計へ使える回数を割り当てる。
- 生成と点検:モデル行列のランク、推定できる項、予測誤差、反復、背景変動を点検する。
- 実施と追加:条件を測り、残差とモデルの妥当性を確認し、不足があれば計画を追加する。
これは説明用の手順で、具体的な選択結果や削減効果を示す実験報告ではありません。例えばグレードを2列のダミー変数で表し、切片、温度・時間、両者の交互作用、温度と時間の二乗項を含めると、係数は合計8個です。指定した候補から、この8項を識別できる配置を選びます。モデルにp個の独立な係数があるなら、推定には少なくともp行分の独立な情報が必要です。ただし、n=pの飽和計画で当てはめられることと、誤差・適合性・再現性を検証できることは別です。
NISTの公開例では、三因子の5×2×2=20候補から、切片・三つの主効果・一因子の二乗項を推定するモデルを指定し、12回の計画を生成しています。選ばれた条件はモデルに必要な情報に対応します。この例の12回を、別の材料課題へそのまま適用することはできません[16]。
MIへ使う際の注意
候補材料を組成や構造の特徴量で表し、線形回帰モデルの学習用候補を選ぶ利用も考えられます。ただし、主効果だけで設計して実際には強い交互作用があれば、重要な情報を取り逃がします。カテゴリを数値1・2・3と入力するだけでは、等間隔の順序という意図しない仮定を入れる場合があります。
D最適計画は通常、ガウス過程やランダムフォレストなど任意の機械学習モデルの予測性能を最大化する万能基準ではありません。非線形性や領域全体の予測が主目的なら、モデルに適した設計、予測分散に基づく基準、空間充填計画などと比較します。計算アルゴリズムが大域的な最適計画を必ず見つけるとも限らないため、同じ条件で複数の初期化を比較する方法もあります[16]。
MIの初期データにはLHSなどの空間充填計画も検討する
連続した温度・時間・圧力の領域から、広く初期データを集めたい場合は、ラテン超方格サンプリング(LHS)が選択肢です。各変数の範囲をn区間に分け、それぞれから1点ずつ取り、変数間で組み合わせます[17]。特定の低次モデルの係数推定よりも、入力領域での偏りを抑えることに着目します。
ただし、各軸で均等に配置しても、多次元空間で点同士が必ず十分離れるとは限りません。距離や投影の偏りを確認し、制約領域では、単に不可能な点を削除して終わらず、配置を再点検します。組成比の合計制約には、その制約に適した設計が必要です。
| 知りたいこと | 最初に検討する手法 | 材料研究での例 |
|---|---|---|
| 一因子の水準間の差 | 一元配置 | 材料グレードや前処理の比較 |
| 二因子の組合せと交互作用 | 反復を含む二元配置 | 熱処理温度×保持時間 |
| 複数因子の主効果を少ない条件で比較 | 直交表・部分実施要因計画 | 工程因子の初期スクリーニング |
| 指定モデルの係数を制約下で推定 | D最適計画 | 禁止条件・混合水準を含む計画 |
| 連続領域の初期データを広く集める | LHSなどの空間充填計画 | MI・シミュレーションの初期学習 |
| 局所の曲率と最適条件 | 応答曲面計画 | 重要因子を絞った後の条件最適化 |
実務では「一元配置で比較→二元配置で組合せ確認→応答曲面で局所探索」と進める場合もあれば、既存の制約からD最適計画を使う場合もあります。この順序は必須ではありません。下記の交互作用の例と設計手順を、今回の目的に合わせて読み進めてください。
一因子ずつ変える方法では、交互作用を見逃すことがある
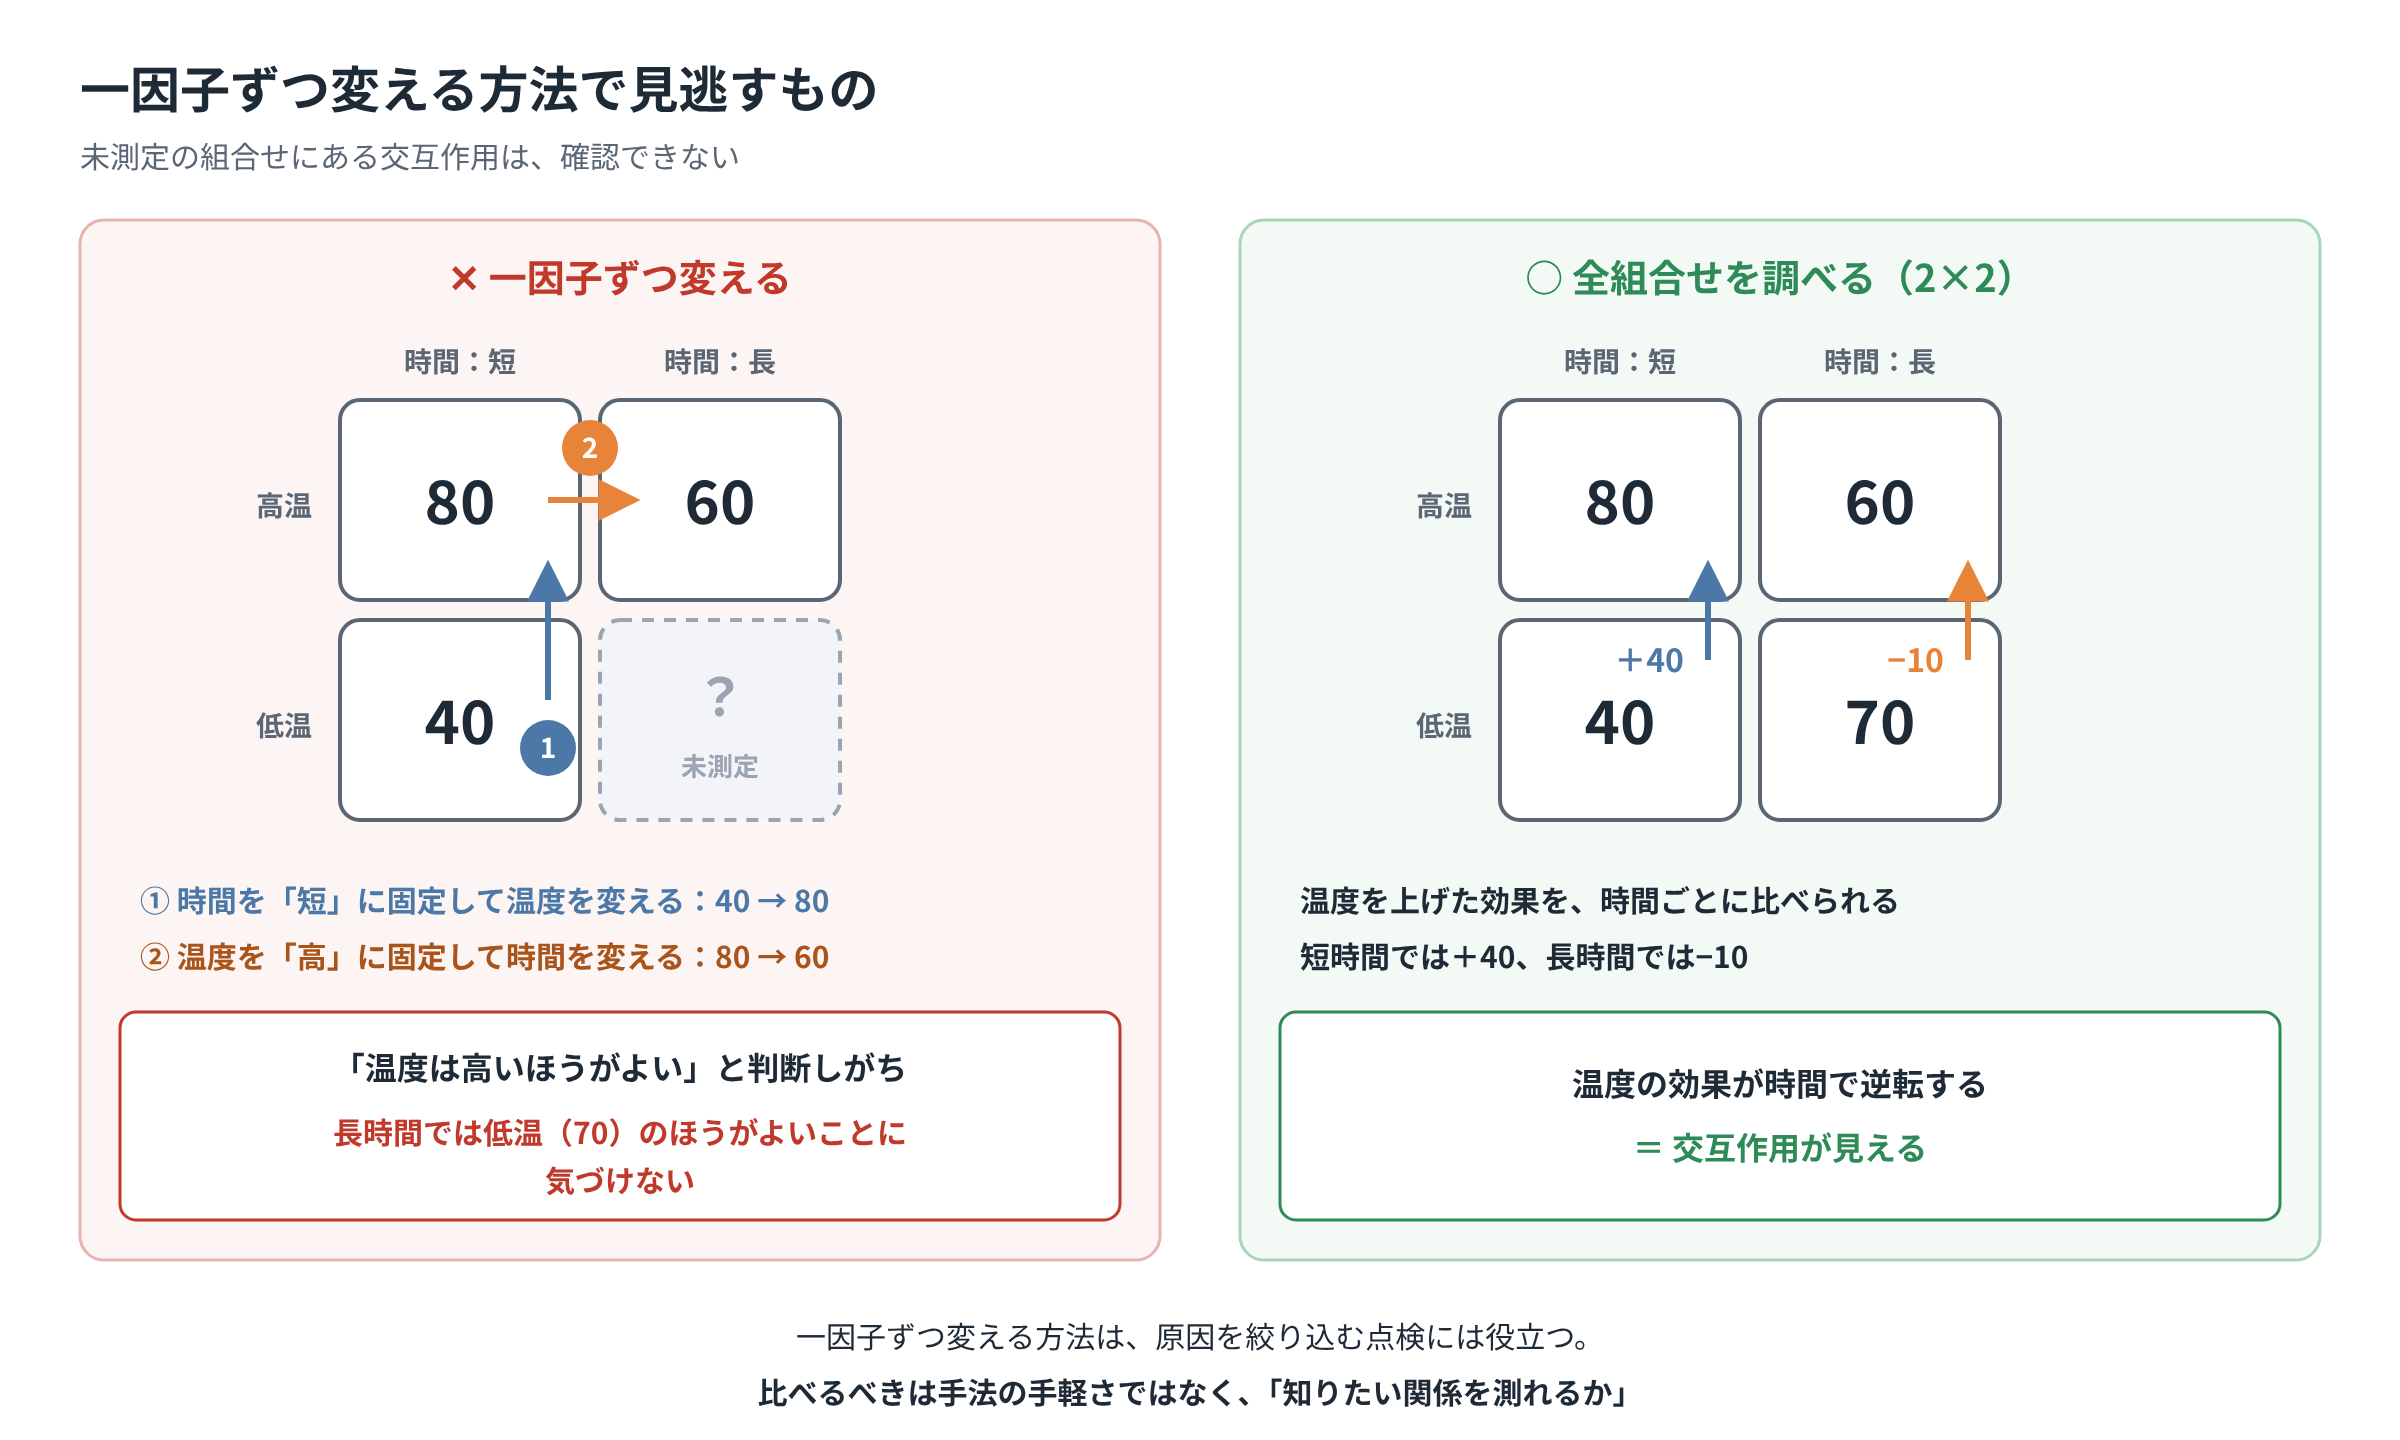
説明のため、膜の乾燥温度を低・高、時間を短・長とした仮想例を考えます。以下は実測データではなく、交互作用の意味を示す架空の指標です。
| 乾燥条件 | 時間:短 | 時間:長 |
|---|---|---|
| 温度:低 | 品質指標40 | 品質指標70 |
| 温度:高 | 品質指標80 | 品質指標60 |
短時間では温度を上げると40から80へ改善しますが、長時間では70から60へ低下します。温度の効果が時間に依存しているため、交互作用があります。短時間の条件だけを見て「高温がよい」と一般化すると、長時間の条件では判断を誤ります。
一因子ずつ変えるOFAT(One Factor At a Time)は、原因を限定した点検や初期の実施可能性確認には役立ちます。しかし、特定の基準条件から一本ずつ動かすだけでは、未測定の組合せにある交互作用を確認できません。DOEが常に少ない回数で勝つと決めつけず、知りたい関係を測れるかで比較します。
なお、この4条件を一度ずつ測るだけでは、測定誤差や試料作製のばらつきを十分に評価できません。モデルに多くの項を入れれば説明できても、その関係が再現するかは別途確認が必要です。
目的から計画を選ぶ:直交表を最初に決めない
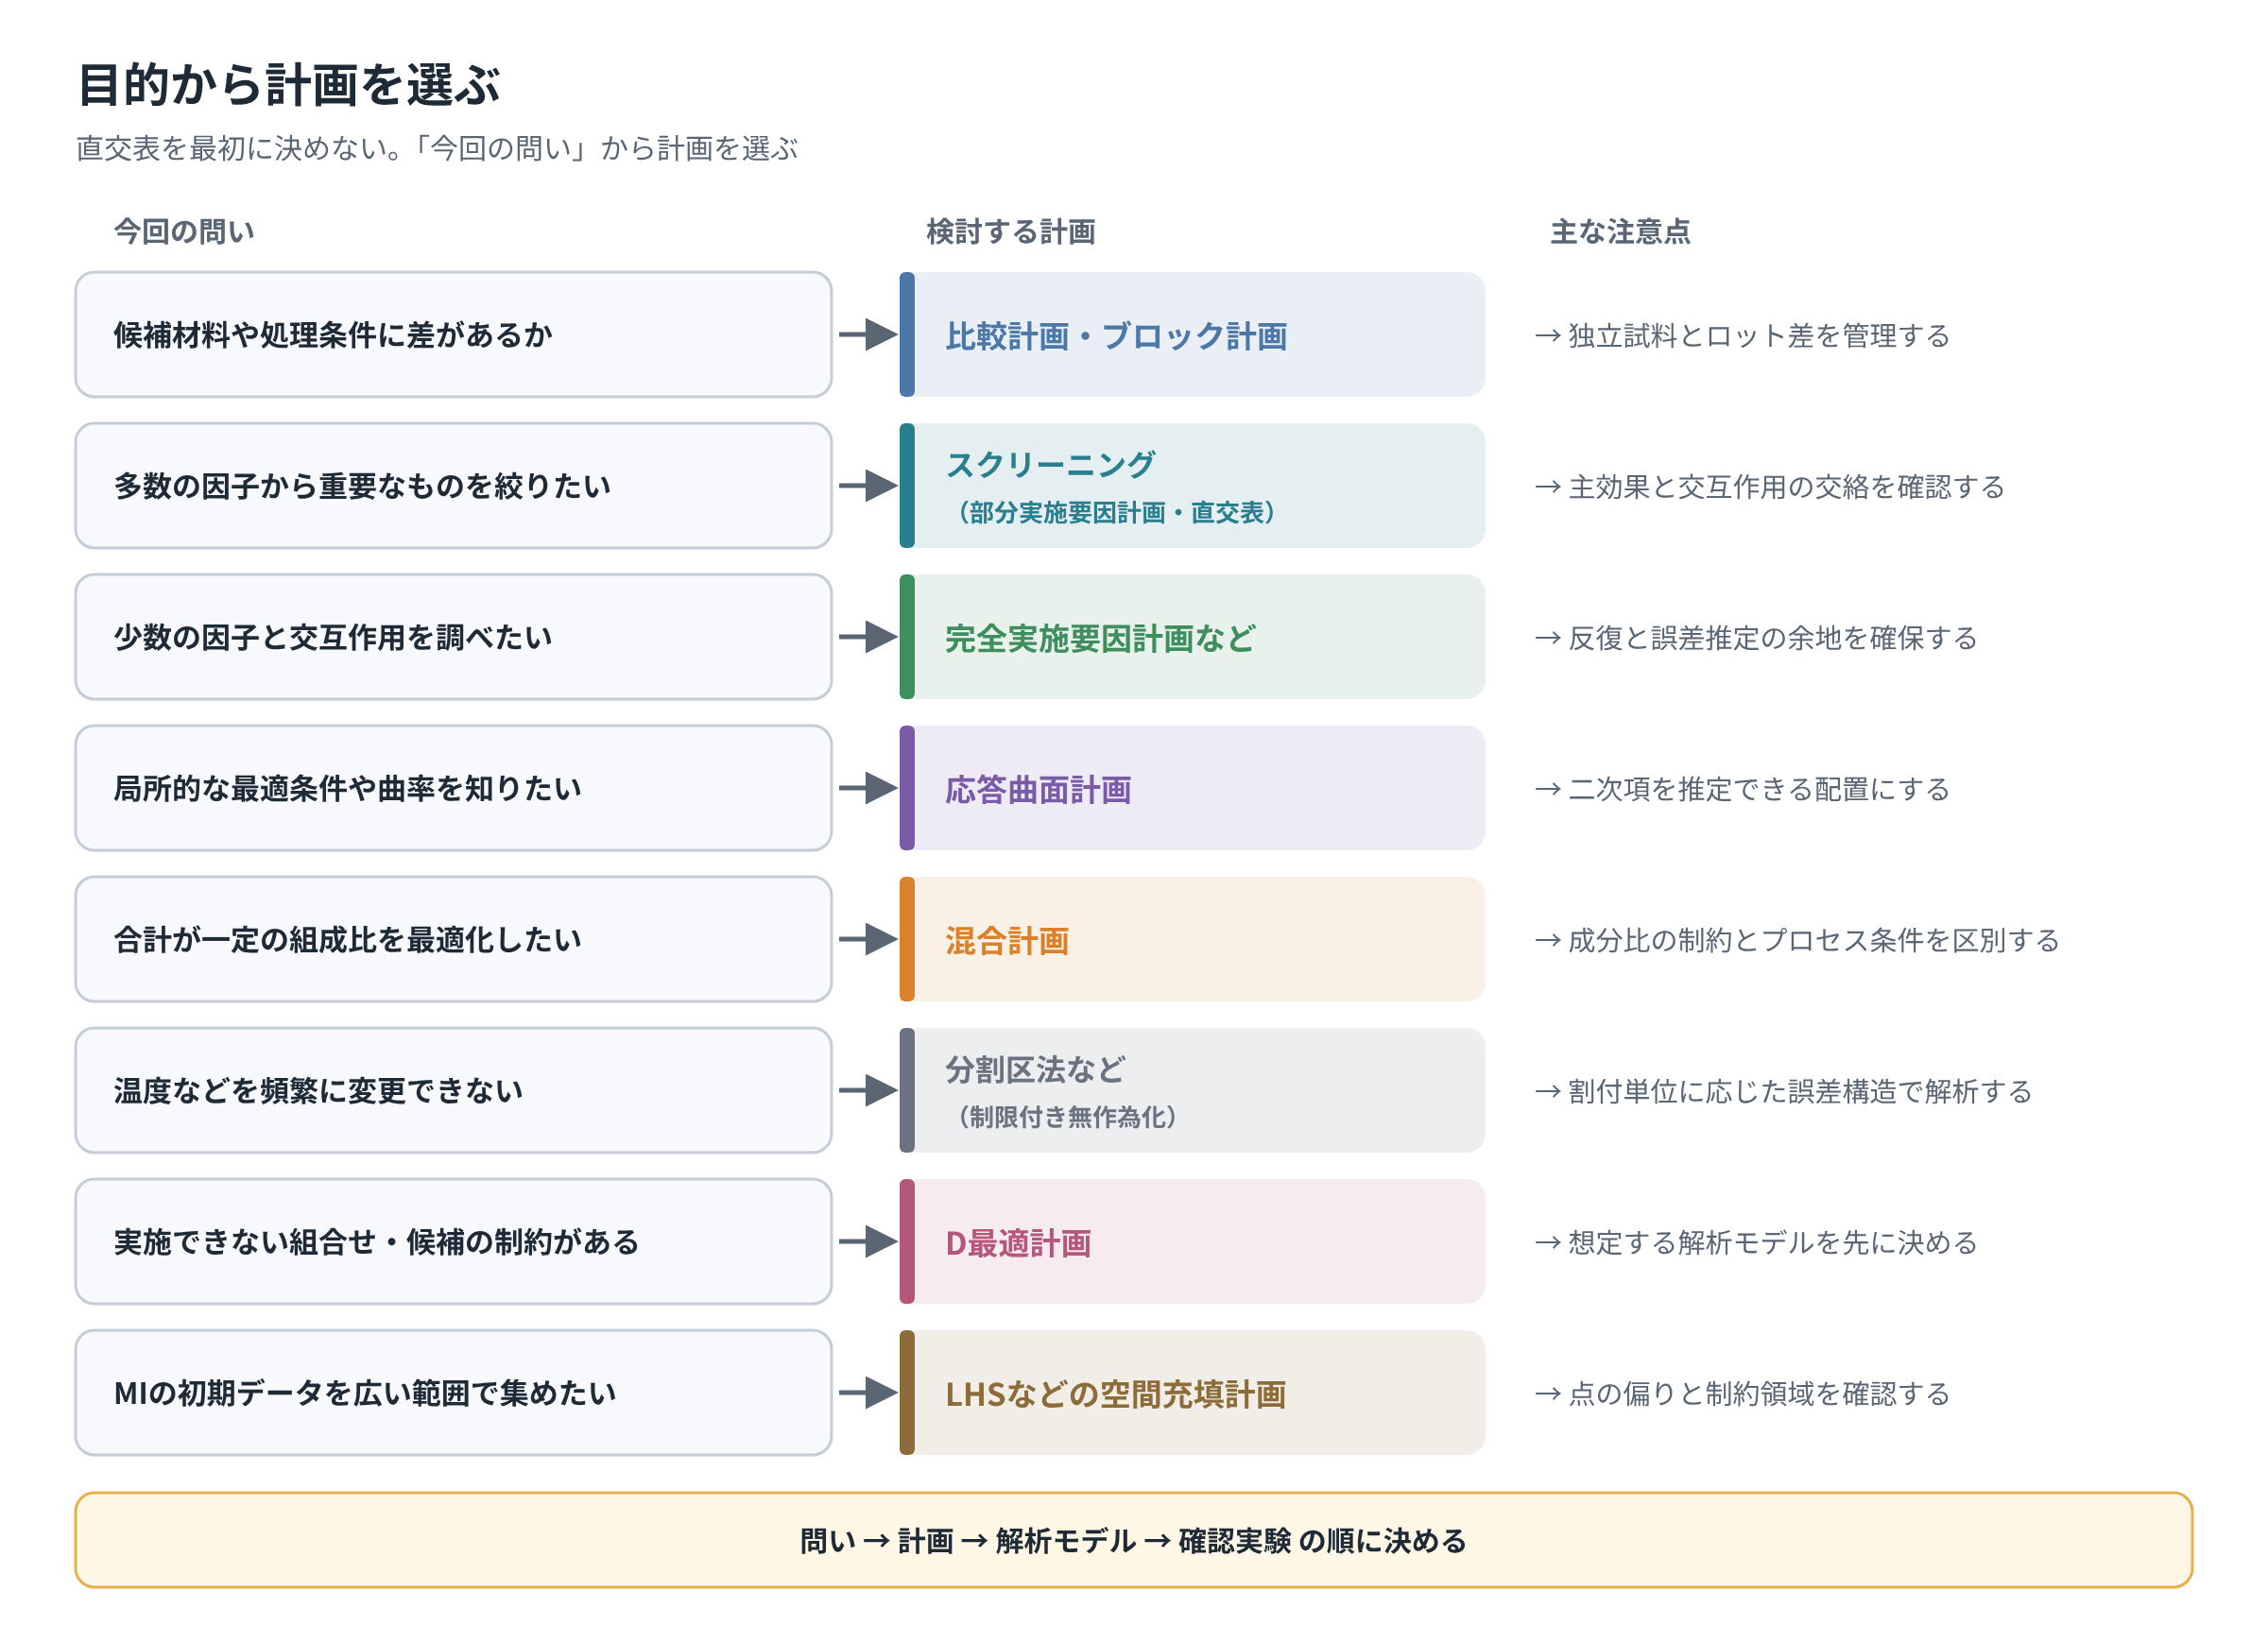
NISTは、比較、スクリーニング、応答曲面、混合、回帰モデルの推定という目的に応じて設計を選ぶ考え方を示しています。因子数と資源、誤った判断を抑える必要性も選択に関係します[3]。次の表は、その考え方を材料開発向けに整理したものです。
| 今回の問い | 検討する計画 | 主な注意点 |
|---|---|---|
| 候補材料や処理条件に差があるか | 無作為化した比較計画、ブロック計画 | 独立試料とロット差を管理する |
| 多数の因子から重要なものを絞りたい | 部分実施要因計画などのスクリーニング | 主効果と交互作用の交絡を確認する |
| 少数の因子と交互作用を調べたい | 完全実施要因計画など | 反復と誤差推定の余地を確保する |
| 局所的な最適条件や曲率を知りたい | 応答曲面計画 | 二次項を推定できる配置にする |
| 合計が一定の組成比を最適化したい | 混合計画 | 成分比の制約とプロセス条件を区別する |
| 温度などを頻繁に変更できない | 分割区法などの制限付き無作為化 | 条件の割付単位に応じた誤差構造で解析する |
完全実施と部分実施の違い
二水準の因子が3個なら、すべての組合せは2×2×2=8条件です。因子が6個なら64条件になります。部分実施要因計画は、その一部を適切に選んで実験する方法です。削減した実験で何を推定できるかは、計画の交絡構造に依存します[6]。
例えば解像度IIIの二水準計画では主効果が二因子交互作用と交絡し、解像度IVでは主効果と二因子交互作用の交絡を避けられる一方、二因子交互作用同士が交絡する場合があります。解像度が同じでも個々の交絡パターンは異なるため、数字だけで選ばず、知りたい効果の組合せを確認します[6]。
直交表は「交互作用を全部調べられる表」ではない
直交性は、指定した列の効果を分離して推定しやすくする性質です。しかし、直交表に因子を割り付けただけで、関心のある全交互作用が独立に推定できるわけではありません。採用するモデル、列への割付、自由度、交絡を一緒に確認します。
また「L9なら9回で十分」とは限りません。9条件という計画の大きさと、独立反復、中心点、失敗時の再実施、確認実験を含む総数は別です。表に合わせて研究課題を縮める前に、計画を研究課題へ合わせます。
反復・無作為化・ブロック化を現場へ組み込む
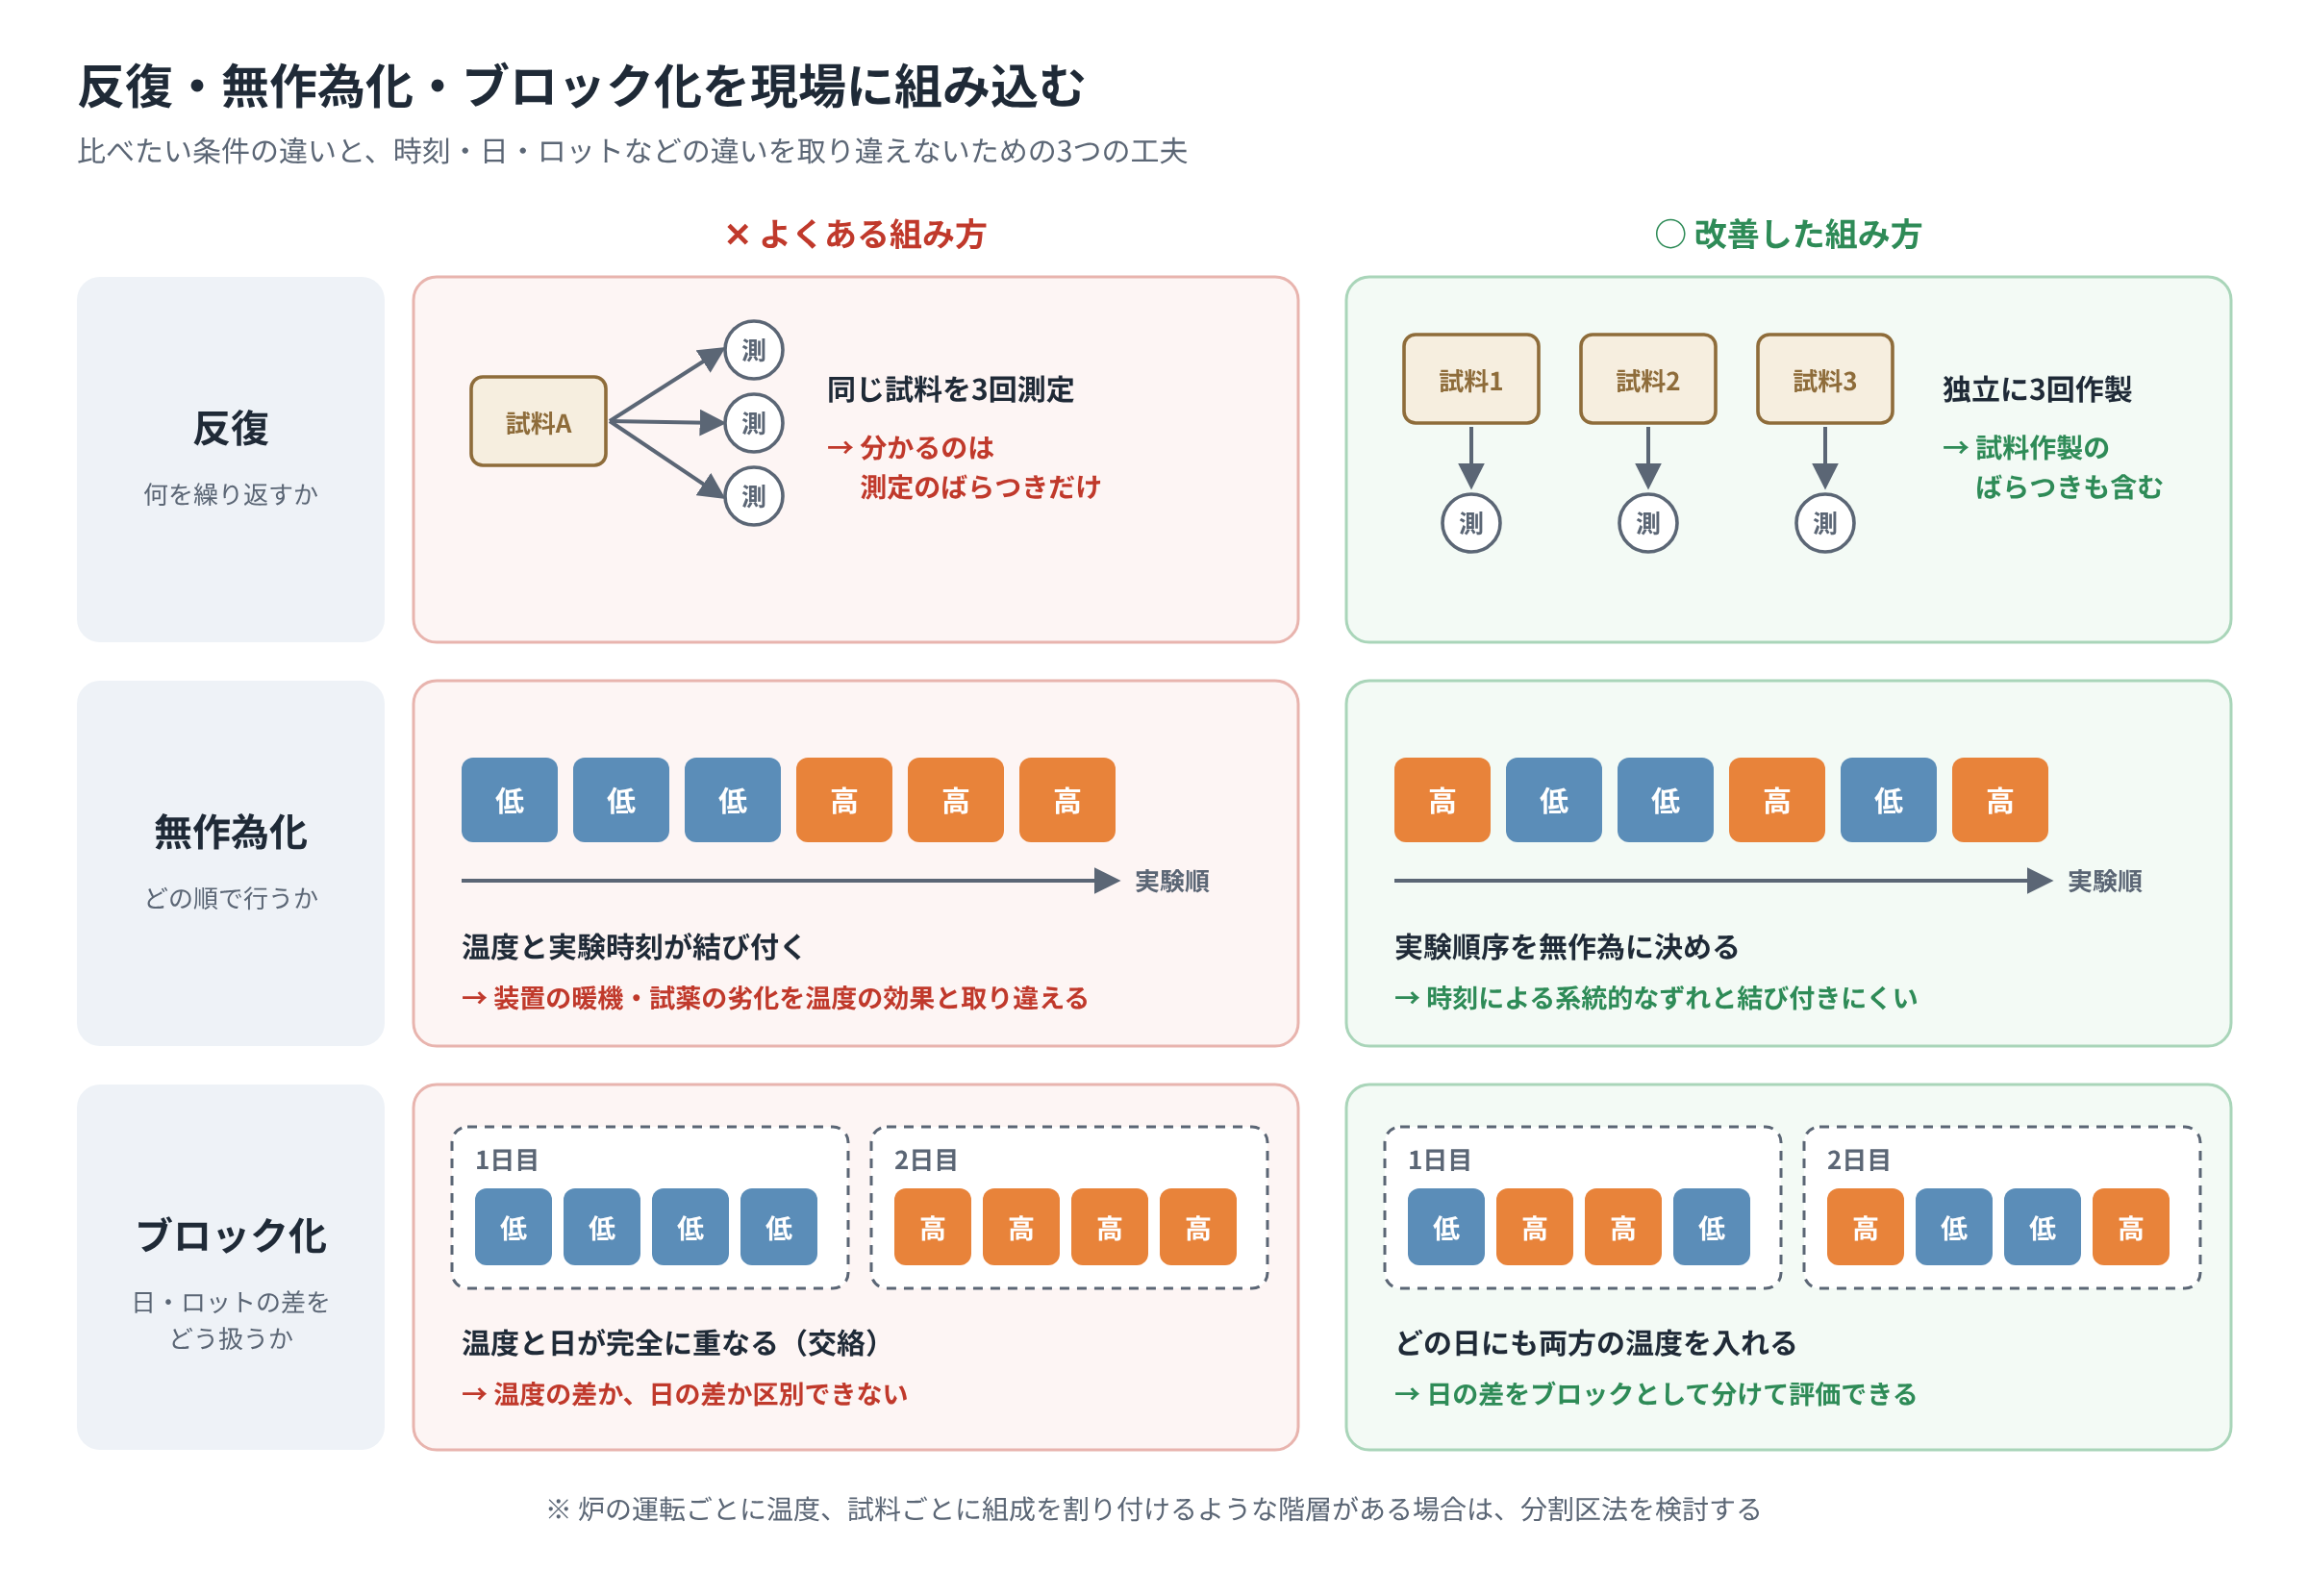
独立反復と同じ試料の繰り返し測定を分ける
同じ試料を3回測ると測定のばらつきを調べられますが、試料作製を3回独立に繰り返したことにはなりません。フィルムを別々に作る、粉体を別バッチで調製するなど、今回の結論を適用する単位に合わせて反復を設計します。
NISTは、反復によってモデルに依存しない誤差の推定が可能になり、モデルの当てはまりを点検する助けになると説明しています[4]。ただし、同じバッチ由来の試片には共通の影響があります。解析用の行数を、そのまま独立な実験数として扱わないことが重要です。
無作為化はドリフトを消す魔法ではない
温度の低い条件から高い条件へ順番に実施すると、温度と実験時刻が結び付きます。装置の暖機、試薬の劣化、測定器のドリフトが起きると、それを温度の効果と取り違える可能性があります。実験順序を無作為化することは、この系統的な結び付きを弱めるための基本手段です[4]。
無作為化しても変動そのものは残ります。実施順、日時、装置状態、標準試料の結果を記録し、残差を時系列でも点検します。
日・ロット・装置の差はブロックとして設計する
1日で全条件を実施できない場合、日ごとに条件をまとめる必要があります。このとき「低温は初日、高温は翌日」とすると、温度と日が完全に重なります。ブロック計画では、除きたい背景変動を意識して条件を配置し、その変動を解析で扱います[5]。
すべての因子を同じ頻度で変えられるとは限りません。例えば炉温は運転ごと、試料組成は炉内の試料ごとに割り付ける場合、割付単位が階層になります。分割区法などを検討し、炉の運転間の変動と試料間の変動を区別します。同じ炉に入れた試料数だけを根拠に炉温効果の精度を評価してはいけません[9]。
応答曲面と混合計画:材料開発で間違えやすい二つの場面
中心点だけで各因子の二次項を推定できるとは限らない
二水準の要因計画に中心点を加えると、単純な一次・交互作用モデルからの曲率を検出する手掛かりが得られます。しかし、中心点だけでは各因子の純二次効果を個別に推定できません。中心複合計画やBox–Behnken計画など、二次モデルに対応する設計を検討します[7]。
曲率が検出されなかったことも、探索範囲全体が完全に線形である証明ではありません。ノイズ、範囲、測定点の配置で検出力が変わります。局所モデルを遠くへ外挿せず、必要な領域で追加確認します。
組成比の合計が一定なら、因子を独立に動かせない
三成分の割合の合計が100%なら、一成分を増やすと別成分を減らす必要があります。普通の独立因子のように各割合を自由に上下させる計画では、実験不能な条件が生まれます。混合計画では、成分比の制約に対応した実験領域とモデルを用います[8]。
割合に加えて総添加量、混合時間、乾燥条件が変わる場合は、それらを区別して設計します。「組成比を変えた効果」と「総量を変えた効果」が一緒にならないようにします。
公開資料から見る利用場面:装置・製剤・分析法
NIST:渦電流探傷装置の感度を調べる
NISTの公開ケーススタディは、金属のき裂検出を目的とする装置について、巻線数、巻線間隔、線径の三因子を二水準で扱います。8条件の完全実施要因計画を無作為な順序で実施し、重要因子、感度を高める設定、予測式を調べる設計です[10]。
この事例は、DOEが材料の組成探索だけでなく、評価装置の設計にも使えることを示します。8条件という数はこの課題の設計であり、あらゆる三因子実験で反復や確認が不要という意味ではありません。
製剤:成分比と製造条件を区別する
Hareらの2025年のチュートリアルは、製剤の成分割合の合計が1になる制約に対応する混合計画を説明し、混合変数とプロセス変数を組み合わせたケーススタディを紹介しています[11]。ここでは公開抄録で確認できた方法の範囲を紹介し、個々の処方の性能改善率などは引用しません。
材料配合でも、成分の割合と加工条件を一つの表で扱う前に、変数の制約を整理する必要があります。公開論文の計画を別の材料へ移す際も、同じ応答モデルや実施可能領域が成り立つとは限りません。
ICH Q14:分析法の頑健性とパラメータ範囲を調べる
FDAが2024年3月に公表したICH Q14のガイダンスは、分析法のパラメータとその交互作用を多変量実験で調べる考え方を示しています[12]。これは特定の製品の成功報告ではなく、分析法開発の公的指針です。
例えば測定条件を少し変えたときに、必要な性能が維持される範囲を調べることは、材料評価法でも役立つ問いです。ただし、この一般的な応用説明から医薬品の規制上の承認や適合性を判断することはできません。用途に応じた評価・検証が必要です。
実験計画シートの記入例
以下は膜形成工程を想定した仮想例です。条件数、独立反復数、測定回数を区別して記録します。反復数3は説明用で、想定する差・ばらつき・検出力から必要数を決めます。
| 記録項目 | 記入例 |
|---|---|
| 今回の判断 | 乾燥温度・時間の組合せを比較し、品質改善候補を選ぶ |
| 因子・水準 | 温度:低・高、時間:短・長。実数値は実施可能範囲から決める |
| 応答 | 残留溶媒量と膜欠陥率。測定手順・単位・採用基準を固定する |
| 実験単位 | 独立に調製・乾燥する膜の作製バッチ。炉の共通運転がある場合は階層を扱う |
| 計画・モデル | 二因子二水準の4条件。主効果と温度×時間を含む |
| 独立反復 | 各条件3回なら計12回の独立作製。同じ膜の3回測定とは区別する |
| 順序・背景条件 | 設備制約の範囲で無作為化。日・原料ロット・装置・実施順を記録 |
| 解析 | 個々の点、条件別平均、交互作用、効果の不確かさ、残差を確認 |
| 確認実験 | 選んだ候補を別日に3回独立作製。必要に応じて従来条件も並行比較 |
| 総予算 | 計画12回+候補確認3回=15回。対照・再実施・追加探索は別途確保 |
| 採用判断 | 性能差、ばらつき、品質制約、費用を満たすか確認。不十分なら追加計画 |
最初のDOEを進める7ステップ
次の手順はNISTの実施フロー[2]をもとに、材料開発で確認する事項を編集部が具体化したものです。
1.今回の判断を一文にする
「強度を上げる」だけでは不十分です。「候補因子を絞る」「既存条件との差を確かめる」「工程の許容範囲を定める」など、実験後の意思決定を明示します。複数の目的があれば優先順位を決め、最低限守る品質指標も書きます。
2.応答と測定方法を固定する
試片形状、前処理、測定温度、単位、平均値の作り方を統一します。検出限界や装置停止など、通常の数値にならない結果の扱いも決めます。測定の再現性が不足したまま条件差を解析すると、工程差と測定差が混ざります。
記録項目の整理には、材料データの品質を高める方法も参考になります。
3.因子・水準・実験単位を決める
設定範囲は安全性、設備、材料の安定性から制限します。実験不能な組合せを先に除き、変えられる因子と記録だけする背景条件を分けます。名目温度と実測温度がずれる設備では、両方を記録します。
4.モデルと計画を対で選ぶ
主効果だけでよいか、特定の交互作用が必要か、二次項が必要かを決めます。その項が推定可能かを計画行列、交絡、自由度で確認します。因子が多ければ、最初から全交互作用を求めず、スクリーニングと追加計画に分けます。
5.順序・反復・背景変動を設計する
実験条件の一覧とは別に、実施順と試料識別子を作ります。複数日にまたがるときは日をどう扱うか決め、変更しにくい条件には割付単位を設定します。確認実験と失敗時の余裕を予算に残します。
6.実施後に仮定と残差を確認する
解析に入る前に、条件逸脱、欠測、装置異常を確認します。結果を見て都合の悪い点だけ削除せず、除外理由を記録します。残差に時間的な傾向や条件ごとの広がりの違いがある場合、平均のモデルだけでは不十分かもしれません。
7.確認実験で採用の可否を判断する
モデルが提案した条件を、新たな試料や別日で確認します。初回データの最大値だけで採用せず、性能差が測定・製造のばらつきに対して十分かを評価します。再現しなければモデル、記録、設備状態を再点検します。
DOEをMI・ベイズ最適化・自律実験へつなげる
DOEのデータを機械学習へ使う場合も、入力範囲と独立性を確認します。少数の固定水準から得た局所データは、広い条件範囲の予測に十分とは限りません。因子効果の推定に適した配置と、全領域を広く予測するための配置が同じでないことがあります。
少数データでの評価設計は、材料開発の少数データで機械学習を使う方法で整理しています。
DOE自体も応答曲面による最適化を含みます。一方、ベイズ最適化は、代理モデルと不確かさから次の候補を選ぶ方法です。詳しい使い分けは、実験計画法とベイズ最適化の違いを参照してください。
自動装置へ条件表を渡すだけでもDOEを実行できますが、結果に応じて計画を変更するなら、候補生成、実施可能性確認、異常時の停止、データ登録までが必要になります。自律実験・Self-driving Labの仕組みとつなげる際も、実験単位と反復の意味を保持します。自動で作った試料が独立かどうかは、装置の台数ではなく実際の割付と作製過程で判断します。
よくある失敗と技術的な限界
- 表を先に選ぶ:必要な交互作用を推定できず、後から追加実験が必要になる。
- 試片数を独立反復数とする:共通バッチの影響を見落とし、精度を過大評価する。
- 日と条件を重ねる:装置や環境の差を因子効果と区別できなくなる。
- 二水準だけで最適点を断定する:水準間の曲率や範囲外の挙動が未確認のままになる。
- 組成制約を無視する:実施できない条件や、解釈しにくいモデルを作る。
- p値だけで採否を決める:実用上の差、ばらつき、費用、再現性が判断から抜ける。
DOEの結論は、採用した因子、範囲、材料系、設備、解析モデルの内側で評価します。高い決定係数があっても、未測定条件での性能や量産時の再現性は保証されません。完全に条件を制御できない場合や、欠測で計画が崩れた場合は、何が推定できなくなったかを確認します。
因果解釈も、条件の割付、背景変動、実験単位、モデルの妥当性に依存します。統計的な交互作用が見つかっただけで材料メカニズムを確定せず、分析や別の条件で検証します。
実験範囲の承認、設備の運転、品質判定、実装の責任は担当者が持ちます。測定系の異常、想定外の材料挙動、条件逸脱、予算超過が起きたときの停止・再計画の基準をあらかじめ決めます。ソフトが出した条件表を、そのまま運転許可として扱わないことが必要です。
導入前チェックリスト
- 今回の実験で決めることと、対象外の問いを明示したか。
- 応答の定義・単位・測定手順・採用基準を共有したか。
- 因子の設定値、実測値、実施可能範囲を整理したか。
- 条件を割り付ける実験単位と、独立反復を定義したか。
- 知りたい効果と交互作用を、計画から識別できるか。
- 無作為化できない条件と、その理由を記録したか。
- 日、ロット、装置、炉の運転の影響を扱えるか。
- 欠測・異常・再実施の判断基準を決めたか。
- 生データ、実施順、試料識別子、条件逸脱を保存するか。
- 確認実験の予算と、採用・停止・再計画の責任者を確保したか。
FAQ:材料研究者が迷いやすい点
DOEを使えば必ず実験回数が減りますか?
必ず減るとは限りません。交互作用や再現性まで調べるなら、単純な比較より実験数が増える場合があります。回数だけでなく、判断に必要な情報とやり直しを含む総費用で評価します。
最初からすべての因子を入れるべきですか?
目的に応じます。重要因子が不明ならスクリーニングを検討できますが、強い交互作用を無視できるかを確認します。既知の重要因子を固定してしまう場合も、その根拠と適用範囲を記録します。
各条件を3回測れば、独立反復になりますか?
同じ試料を3回測るだけなら、試料作製の独立反復ではありません。測定の反復、試料の反復、バッチの反復を区別し、何のばらつきを推定しているかを明示します。
中心点を追加すれば、二次モデルを作れますか?
二水準の要因計画に中心点を追加するだけでは、各因子の純二次項を個別に推定できません。目的に合う応答曲面計画へ拡張します[7]。
実験中に計画を変更してもよいですか?
段階的な追加は可能です。ただし、変更理由、途中結果、追加条件、解析方針を記録します。都合のよい結果が出るまで条件や評価方法を変えると、元の問いへの検証として解釈しにくくなります。
生成AIへ計画を作らせてもよいですか?
因子候補や記録項目の整理には利用できます。提案された計画が必要な項を推定できるか、設備制約を満たすか、独立性を扱えるかは別途確認します。計画の採用と運転の責任は研究・設備担当者が持ちます。
まとめ
一因子の水準差なら一元配置、二因子の組合せと交互作用なら二元配置、複数因子の主効果の比較なら直交表や部分実施要因計画を検討します。制約のある候補から指定モデルの係数を推定したいならD最適計画、連続領域の初期学習データを広く集めたいならLHSなどが選択肢です。
まず今回の実験で何を決めるかを明示し、応答・実験単位・因子・制約を整理します。計画で何が分かり、何が分からないかを確認してから実施します。
独立反復、無作為化、ブロック化、交絡の確認は、結果を説明できる実験にするための基礎です。曲率や混合制約、変更しにくい設備条件がある場合は、それに対応した計画と解析を選びます。
最初から大きな計画ですべてを解く必要はありません。小さな計画で得た知識を次へつなぎ、独立した確認実験を経て判断します。DOEをMIや自律実験へ接続するときも、この設計の意味を保つことが重要です。
参考文献
[19]宮川雅巳・吉田勝美. “Interaction Pattern in L18 Orthogonal Array and Guide to Assignment.” 品質, 22(2), 12–18 (1992). DOI: 10.20684/quality.22.2_12. L18の割付に関する説明は公開抄録の範囲を参照(2026年10月6日確認)。
ウェブ資料の存在・書誌情報は2026年10月6日に確認しました。公的ガイドの説明、公開ケーススタディ、編集部の仮想例を本文で区別しています。
- NIST/SEMATECH. e-Handbook of Statistical Methods, 5.1.1. What is experimental design? 公式ページ.
- NIST/SEMATECH. 同上, 5.1.3. What are the steps of DOE? 公式ページ.
- NIST/SEMATECH. 同上, 5.3.3. How do you select an experimental design? 公式ページ.
- NIST/SEMATECH. 同上, 4.3.3. What are some general design principles for process modeling? 公式ページ.
- NIST/SEMATECH. 同上, 5.3.3.2. Randomized block designs. 公式ページ.
- NIST/SEMATECH. 同上, 5.3.3.4.4. Fractional factorial design specifications and design resolution. 公式ページ.
- NIST/SEMATECH. 同上, 5.3.3.6. Response surface designs. 公式ページ.
- NIST/SEMATECH. 同上, 5.5.4. What is a mixture design? 公式ページ.
- NIST/SEMATECH. 同上, 5.5.5. How can I account for nested variation (restricted randomization)? 公式ページ.
- NIST/SEMATECH. 同上, 5.6.1.1. Eddy Current Probe Sensitivity Case Study: Background and Data. 公式ページ.
- Hare, L. B., Altan, S., Coppenolle, H. “Mixture Experimentation in Pharmaceutical Formulations: A Tutorial.” Pharmaceutical Statistics, 24(1), e2426 (2025; オンライン公開2024年8月5日). DOI: 10.1002/pst.2426. 本記事は公開抄録の概説を参照。
- FDA / ICH. Q14 Analytical Procedure Development: Guidance for Industry (March 2024), Sections 2.1, 5.1–5.2. 公式PDF.
- NIST/SEMATECH. e-Handbook of Statistical Methods, 1.3.5.4. One-Factor ANOVA. 公式ページ(2026年10月6日確認).
- NIST/SEMATECH. 同上, 1.3.5.5. Multi-factor Analysis of Variance. 公式ページ(2026年10月6日確認).
- NIST/SEMATECH. 同上, 5.3.3.10. Three-level, mixed-level and fractional factorial designs. 公式ページ(2026年10月6日確認).
- NIST/SEMATECH. 同上, 5.5.2.1. D-Optimal designs. 公式ページ(2026年10月6日確認).
- SciPy community. LatinHypercube, SciPy Reference Guide. 公式ページ(2026年10月6日確認).
- NIST/SEMATECH. e-Handbook of Statistical Methods, 5.5.6. What are Taguchi designs? 公式ページ(2026年10月6日確認).