
「研究開発DXとは、電子実験ノートやAIを導入することなのか」「研究者の仕事を効率化できても、事業成果につながらなければDXと呼べないのか」「何をKPIにすればよいのか」。研究開発部門でDXを始めると、こうした疑問が生じます。
結論からいえば、研究開発DXとは、デジタル技術を使って研究業務を置き換えるだけでなく、テーマ選定、実験、解析、意思決定、知識共有、製造・事業への接続を再設計し、研究開発から生まれる価値と学習速度を高める変革です。ツール導入は手段であり、研究成果、意思決定、組織能力まで変わって初めてDXといえます。
本記事では、研究開発DXとIT導入・デジタル化の違い、対象領域、進め方、KPI、公開事例、失敗パターン、技術的限界、責任範囲を整理します。個別施策の導入方法ではなく、研究開発DX全体を設計するための親記事です。
研究開発DXとは
研究開発DXは、研究開発活動の目的を維持したまま紙を電子化することではありません。研究課題の設定から、実験・計算・解析、レビュー、知財化、スケールアップ、製品化までの情報と意思決定をつなぎ、より良い仮説を、より短いサイクルで、より信頼できる証拠に基づいて評価できる状態へ変えることです。
OECDのFrascati Manualは、研究開発を「新規性、創造性、不確実性、体系性、再現・移転可能性」を満たす活動として整理しています[1]。このうち不確実性は、定型業務のDXと研究開発DXを分ける重要な特徴です。最初から正解の工程が分からないため、効率だけでなく、失敗から得られる情報、探索範囲、判断の質を管理する必要があります。
経済産業省のデジタルガバナンス・コード3.0は、データとデジタル技術による環境変化を踏まえた経営ビジョン、戦略、組織、人材、ITシステム、成果指標、ガバナンスを一体で扱っています[2]。研究開発DXも同様に、ツールの導入計画ではなく、研究戦略と事業価値から逆算して設計します。
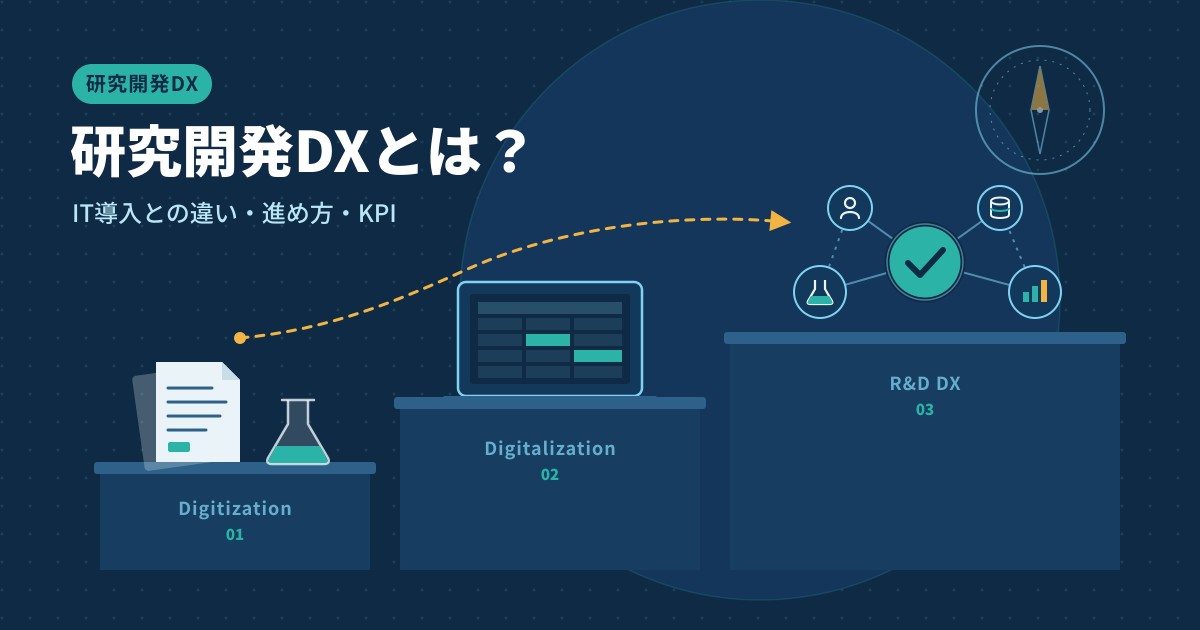
IT導入・デジタル化・研究開発DXの違い
| 段階 | 主な目的 | 研究開発での例 | 成果の見方 |
|---|---|---|---|
| Digitization | アナログ情報の電子化 | 紙の実験記録をPDF化 | 検索時間、保管コスト |
| Digitalization | 既存業務のデジタル改善 | ELN、LIMS、自動解析、装置連携 | 工数、処理数、ミス率 |
| 研究開発DX | プロセス・役割・意思決定の変革 | データ再利用、MI、閉ループ探索、事業連携 | 学習速度、成功確率、事業価値 |
電子実験ノートを導入しても、入力項目が部署ごとに異なり、検索できず、レビューやテーマ判断に使われなければ、記録媒体の変更にとどまります。一方、既存の表計算や共有フォルダを使っていても、データ定義、判断基準、再利用ルール、部門間連携が変われば、DXの重要な一歩になります。
OECDは、デジタル化が研究課題の設定、実験、知識共有、共同研究、研究評価など科学活動の全段階に影響すると整理しています[3]。したがって、研究開発DXを「研究者の作業時間削減」だけに限定すると、本来の効果である組織学習や外部連携を捉えられません。
研究開発DXが一般業務のDXと異なる理由
結果と手順が事前に確定しない
定型業務では、標準工程を自動化すれば品質と効率を改善できます。しかし研究では、仮説が否定され、測定法が変わり、評価指標自体が見直されます。システムは固定された正解を強制するのではなく、手順版、変更理由、失敗、未確定情報を記録できる必要があります。
データが少なく、条件依存性が強い
研究データは、少数、不均衡、多目的で、装置、担当者、バッチ、環境、前処理に依存します。大量データを前提とする一般的なAI導入手順はそのまま適用できません。データ数より、取得過程と適用範囲を管理することが重要です。
暗黙知と知的財産を扱う
なぜその条件を選んだか、どの異常を重要と判断したかは、数値だけでは残りません。一方、すべてを無制限に共有すると、営業秘密、共同研究契約、輸出管理、特許の新規性に影響します。共有を増やすことと、アクセス権・持ち出し・保存期間を管理することを同時に進めます。
成果までの時間差が長い
研究成果が売上や利益に表れるまで数年かかることがあります。短期の工数削減だけで評価すると、データ基盤、人材育成、標準化への投資が打ち切られます。先行指標と事業成果を階層化し、時間差を前提に評価します。
研究開発DXの対象領域
| 領域 | 代表的な施策 | 変える判断 |
|---|---|---|
| テーマ・ポートフォリオ | 外部情報統合、技術マップ、評価基準 | 何に投資し、何を止めるか |
| 実験・計測 | ELN、LIMS、装置連携、自動化 | 次に何を測り、いつ止めるか |
| 解析・予測 | 統計解析、MI、画像解析、シミュレーション | どの仮説を優先するか |
| 研究データ | メタデータ、ID、DB、権限、品質管理 | どのデータを信頼・再利用するか |
| 知識活用 | 検索、RAG、ナレッジグラフ、文献解析 | 既存知識をどう再利用するか |
| 製造・事業接続 | PI、スケールアップ、品質予測、技術移管 | 研究成果をどこで事業化するか |
材料開発の探索・予測を中心に進める場合はマテリアルズ・インフォマティクスとは?、研究データの欠損やメタデータを整える場合は材料データの品質を高める方法が関連します。研究開発DXは、これらを個別技術で終わらせず、研究プロセスと組織運用へつなぐ枠組みです。
研究開発DXを支える5つの基盤
1.研究・事業戦略
最初に、どの競争力を高めるのかを決めます。探索範囲を広げる、開発期間を短縮する、成功確率を上げる、技術移管を早める、研究資産を再利用するなど、狙いによって必要なデータと技術は異なります。ISO 56002は、イノベーション活動を継続的に改善するマネジメントシステムの指針を示しています[4]。
2.データ基盤
試料、原料、処方、プロセス、測定、解析、判断を一貫したIDで結びます。元データを保全し、単位、手順版、装置、校正、担当、日時、欠損理由を記録します。DB構築はゴールではなく、検索、比較、モデル化、レビューで使われて初めて価値が生まれます。
3.技術基盤
ELN、LIMS、データベース、クラウド、MI、シミュレーション、生成AI、実験自動化を、目的に応じて組み合わせます。米国のMaterials Genome Initiative 2021戦略は、AI、実験、計算、データ基盤、人材を連携させ、材料の研究開発と展開を加速する方針を示しています[5]。
ロボットや装置連携を含む場合は、実験自動化とは?で、対象工程の選び方、装置連携、データ基盤、安全設計を解説しています。
4.人材と組織
研究者、データサイエンティスト、計算科学者、データエンジニア、ソフトウェアエンジニア、知財、品質、安全、事業部が関わります。全員を同じスキルにするのではなく、課題責任者、データ責任者、モデル責任者、基盤責任者を明確にします。中央CoEは共通基盤と専門性を担い、研究テーマ側は目的、データ意味、実験検証、最終判断を担う形が基本です。
5.ガバナンス
アクセス権、データ分類、外部サービス利用、モデル検証、変更管理、監査ログ、廃止手順を定めます。ガバナンスは利用禁止の仕組みではなく、許可される利用範囲と責任を明確にして、安全な展開を速めるための仕組みです。
研究開発DXの進め方:7ステップ
ステップ1.経営課題と研究課題を接続する
「AIを使う」ではなく、「候補材料を絞る期間を半減する」「スケールアップでの手戻りを減らす」「過去の失敗実験を再利用する」のように定義します。事業価値が遠い基盤テーマでは、将来の利用部門、利用場面、判断の変化を仮説として示します。
ステップ2.現状の意思決定を可視化する
業務フローだけでなく、誰が、どの情報を見て、どの基準で、いつ継続・中止・追加実験を決めているかを整理します。時間がかかる場所より、判断に必要な情報が欠ける場所を優先すると、単純な作業効率化を超えた効果が得られます。
ステップ3.テーマを選定する
価値、データ準備度、検証可能性、横展開性、現場オーナー、リスクで評価します。高い予測精度が得られそうでも、実験検証できないテーマや、意思決定に使われないテーマは優先しません。短期成果テーマと基盤整備テーマを混ぜ、ポートフォリオとして管理します。
ステップ4.最小実用単位を設計する
PoCではモデルや画面を作るだけでなく、誰が、いつ、何に使い、結果が外れたらどうするかまで含めます。入力、出力、検証、承認、例外対応を一つの小さな業務として動かし、利用ログと判断結果を取ります。PoCから実装へ進める条件は研究開発DXがPoCで止まる理由で詳しく説明しています。
ステップ5.データとシステムの責任を定める
データ項目の意味、品質基準、正本、修正権限、保存期間を決めます。モデルについては、学習データ、版、適用範囲、評価指標、再学習条件、停止条件を管理します。研究テーマ終了後も誰が維持するかを、試作段階から決めておきます。
ステップ6.人と業務を含めて検証する
技術性能だけでなく、研究者が使えるか、判断が変わるか、レビュー時間が短くなるか、説明可能かを確認します。現場からの修正要求を「抵抗」とみなさず、暗黙知や責任条件を仕様へ変換する機会として扱います。
ステップ7.継続・拡大・停止を判断する
事前にゲートを設け、価値が確認できれば対象を拡大し、条件不足なら追加検証し、利用されない場合は停止します。システムを残すことを成功条件にせず、得られたデータ定義、検証方法、失敗理由を次のテーマへ再利用します。
研究開発DXのKPI設計
研究開発DXのKPIは、処理件数やライセンス数だけでは不十分です。活動、業務変化、研究成果、事業成果を階層化し、因果仮説を明示します。2026年2月に改訂された経済産業省・IPAのDX推進指標も、デジタルガバナンス・コード3.0に基づき、経営ビジョン、戦略、組織、人材、ITシステム、成果把握などを成熟度として診断する構成です[6]。
| KPI階層 | 指標例 | 注意点 |
|---|---|---|
| 基盤・活動 | 標準項目率、データ登録率、教育修了率 | 実施しただけで成果としない |
| 利用・定着 | 月間利用者、意思決定利用率、再利用件数 | ログイン数だけで評価しない |
| 業務成果 | 拘束時間、リードタイム、再測定率、手戻り | 品質低下を同時に監視 |
| 研究成果 | 仮説検証速度、探索効率、予測の適用範囲 | 特許件数だけに偏らない |
| 事業成果 | 開発期間、技術移管率、採用率、利益貢献 | 時間差と外部要因を考慮 |
| リスク・品質 | 逸脱、誤判断、情報漏えい、停止時間 | ゼロ件報告が安全を意味しない |
たとえば「データ登録率→過去データ再利用率→追加実験削減→意思決定期間短縮」というつながりを仮説化します。途中の指標が改善しない場合、最終成果を待たずにデータ定義や利用場面を見直せます。KPIは個人評価へ直結させすぎると、登録件数の水増しや失敗データの非登録を招くため注意が必要です。
公開事例から見る研究開発DX
材料研究:データを共通資産にする
NIMSのDICEは、材料データベース、研究データの収集・構造化・蓄積、解析環境などを含む材料研究向けデジタルエコシステムです[7]。この事例が示すのは、個別の機械学習モデルより先に、データを継続的に集め、識別し、再利用する仕組みが必要だということです。
医薬品開発:モデルを意思決定と規制対話へ接続する
米国FDAのModel-Informed Drug Developmentプログラムは、非臨床・臨床データに基づく曝露、薬理、生物、統計モデルを医薬品開発と審査に統合するための対話を支援しています[8]。モデルを作るだけでなく、前提、適用範囲、不確かさを明示し、意思決定者との共通理解を作ることが重要です。
研究データ:再利用可能性を設計する
FAIR原則は、データをFindable、Accessible、Interoperable、Reusableにする指針です[9]。FAIRは全面公開を意味しません。機密データでも、権限のある利用者が発見でき、意味を理解し、条件を守って再利用できるよう、メタデータとアクセス手続きを整えます。
AI活用:性能だけでなくリスクをライフサイクルで管理する
NIST AI RMF 1.0は、AIリスク管理をGovern、Map、Measure、Manageの機能で整理し、設計、開発、利用、評価を通じた信頼性管理を求めています[10]。研究開発では、学習データ外の予測、説明不足、バイアス、機密情報、再現不能な生成結果を含め、利用場面ごとに管理します。
よくある失敗パターン
ツール導入をゴールにする
ELN、AI、クラウドの導入件数を成果にすると、利用場面と判断が変わらないまま運用負荷だけが増えます。導入前に、誰のどの判断がどう変わるかを一文で説明できる状態にします。
全社共通化を急ぎすぎる
研究分野ごとに試料、単位、評価法、機密区分が異なります。すべてを最初から統一すると、項目が肥大化し、現場が入力できません。共通ID、時刻、単位、由来、権限など最小共通部分と、分野固有部分を分けます。
成功データだけを集める
成功条件だけを蓄積すると、モデルは失敗領域や停止条件を学べません。失敗理由、測定不能、条件逸脱、探索しなかった理由を、再利用可能な形で残します。ただし、異常値をそのまま学習に使うのではなく、測定エラーと科学的な負の結果を区別します。
専門部署へ丸投げする
データサイエンス部署だけでは、データ意味、実験制約、採用基準を決められません。研究者だけでは、基盤、ソフトウェア品質、運用設計を担いきれません。課題責任とモデル・基盤責任を分け、共同で受入基準を作ります。
短期ROIだけで判断する
データ基盤や人材育成は、最初のテーマだけでは採算が合わないことがあります。一方、将来価値だけを主張すると投資が無制限になります。短期の業務成果、横展開価値、戦略的な選択肢を分け、段階投資の条件を定めます。
PoCの終了条件がない
精度が上がる限り試作を続けると、実装責任が曖昧になります。開始時に、継続、追加検証、停止の条件と判断者を決めます。経済産業省のDXレポート2.2も、デジタル産業への変革には経営者のビジョン、行動、企業間関係、人材といった複数の変化が必要であることを示しています[11]。
技術的限界・不確かさ・責任範囲
研究開発DXは、研究の不確実性を消すものではありません。データが増えても、測定バイアス、未観測因子、外挿、スケール差、因果と相関の混同は残ります。生成AIは文献整理やコード作成を支援できますが、引用の実在、計算結果、機密情報、科学的妥当性を自動的には保証しません。
最終的な研究判断の責任は、ツールや外部ベンダーではなく、組織が定めた責任者に残します。モデルは提案と根拠、不確かさ、適用範囲を示し、研究者は実験・物理・化学的妥当性を確認し、管理者はリスクと事業判断を承認します。高リスクな条件では自動停止または人の承認を必須にします。
また、デジタル化によって記録が詳細になるほど、アクセス権、ログ、削除、共同研究終了後のデータ処理が重要になります。保存できることと、保存してよいことは同じではありません。法務、知財、情報セキュリティ、品質、安全部門と責任範囲を合意します。
研究開発DXの開始前チェックリスト
- 研究・事業上の課題を、AIやツール名を使わずに説明できる
- 変えたい意思決定と、その利用者・責任者が明確である
- 現状のデータ取得、レビュー、承認、例外処理を把握している
- 試料ID、単位、手順版、装置、欠損理由など最低限のデータ定義がある
- 短期成果テーマと共通基盤テーマを分けて評価している
- PoC後の運用責任者、費用、保守方法が決まっている
- モデルの適用範囲、不確かさ、再学習・停止条件を定義できる
- 知財、契約、輸出管理、個人情報、機密区分を確認している
- 活動、利用、研究成果、事業成果、リスクのKPIがつながっている
- 継続、拡大、追加検証、停止を判断するゲートがある
よくある質問
Q1.研究開発DXは、まずELN導入から始めるべきですか?
必ずしもそうではありません。記録検索と共有が主要課題ならELNは有力ですが、測定ファイル、試料ID、レビュー、装置連携が課題なら別の施策が先です。意思決定に必要な情報の流れを確認し、ボトルネックから着手します。
Q2.研究開発DXとMIの違いは何ですか?
MIは材料データと計算・機械学習を使って材料探索や予測を支援する技術・方法論です。研究開発DXはMIを含み、データ基盤、実験、自動化、組織、業務、ガバナンス、事業接続までを変革対象にします。
Q3.研究者の自由度を下げませんか?
過度な標準化は探索を妨げます。標準化するのは、ID、単位、由来、権限、安全、監査など再利用と責任に必要な部分です。仮説、考察、探索手順は柔軟に残し、例外を認める手続きも設計します。
Q4.何人規模の専門組織が必要ですか?
一律の正解はありません。テーマ数、分野、内製範囲で異なります。少人数では、研究側の責任者とデータ・ITの兼任チームから始め、共通課題が増えた段階でCoE機能を強化します。人数より、課題・データ・モデル・基盤・運用の責任が抜けていないことが重要です。
Q5.DXの成果が売上に表れない場合、どう評価しますか?
売上までの因果を分解します。データ再利用、仮説検証速度、候補絞り込み、技術移管、製品採用といった先行指標を置き、事業成果との関係を追跡します。ただし、先行指標だけを恒久的な成功条件にせず、一定期間ごとに事業仮説を見直します。
まとめ
研究開発DXは、紙を電子化したりAIモデルを導入したりするだけの活動ではありません。研究戦略、データ、技術、人材、組織、ガバナンスをつなぎ、仮説検証と意思決定の質・速度を高める変革です。
成功の鍵は、経営課題と研究課題を接続し、変えたい意思決定を明確にすることです。最小実用単位で人と業務を含めて検証し、活動、利用、研究成果、事業成果、リスクを階層化して測ります。研究者の判断責任と探索の自由を残しながら、データと再現性を組織資産へ変えることが、持続的な研究開発DXにつながります。
参考文献
- [1]OECD, Frascati Manual 2015: Guidelines for Collecting and Reporting Data on Research and Experimental Development, OECD Publishing (2015). DOI: 10.1787/9789264239012-en
- [2]経済産業省「デジタルガバナンス・コード3.0~DX経営による企業価値向上に向けて~」(2024年9月)https://www.meti.go.jp/policy/it_policy/investment/dgc/dgc3.0.pdf
- [3]OECD, The Digitalisation of Science, Technology and Innovation: Key Developments and Policies, OECD Publishing (2020). DOI: 10.1787/b9e4a2c0-en
- [4]International Organization for Standardization, ISO 56002:2019, Innovation management — Innovation management system — Guidance. https://www.iso.org/standard/68221.html
- [5]National Science and Technology Council, Materials Genome Initiative Strategic Plan (2021). https://www.mgi.gov/sites/mgi/files/MGI-2021-Strategic-Plan.pdf
- [6]経済産業省・情報処理推進機構「DX推進指標を改訂しました」(2026年2月13日)https://www.meti.go.jp/press/2025/02/20260213001/20260213001.html
- [7]国立研究開発法人物質・材料研究機構「DICEとは」https://dice.nims.go.jp/about.html(参照日:2026年10月5日)
- [8]U.S. Food and Drug Administration, “Model-Informed Drug Development Paired Meeting Program.” https://www.fda.gov/drugs/development-resources/model-informed-drug-development-paired-meeting-program(参照日:2026年10月5日)
- [9]Wilkinson, M. D. et al., “The FAIR Guiding Principles for scientific data management and stewardship,” Scientific Data, 3, 160018 (2016). DOI: 10.1038/sdata.2016.18
- [10]National Institute of Standards and Technology, Artificial Intelligence Risk Management Framework (AI RMF 1.0), NIST AI 100-1 (2023). DOI: 10.6028/NIST.AI.100-1
- [11]経済産業省「DXレポート2.2の背景と概要」(2022年)https://www.meti.go.jp/policy/it_policy/dx/002_05_00.pdf