
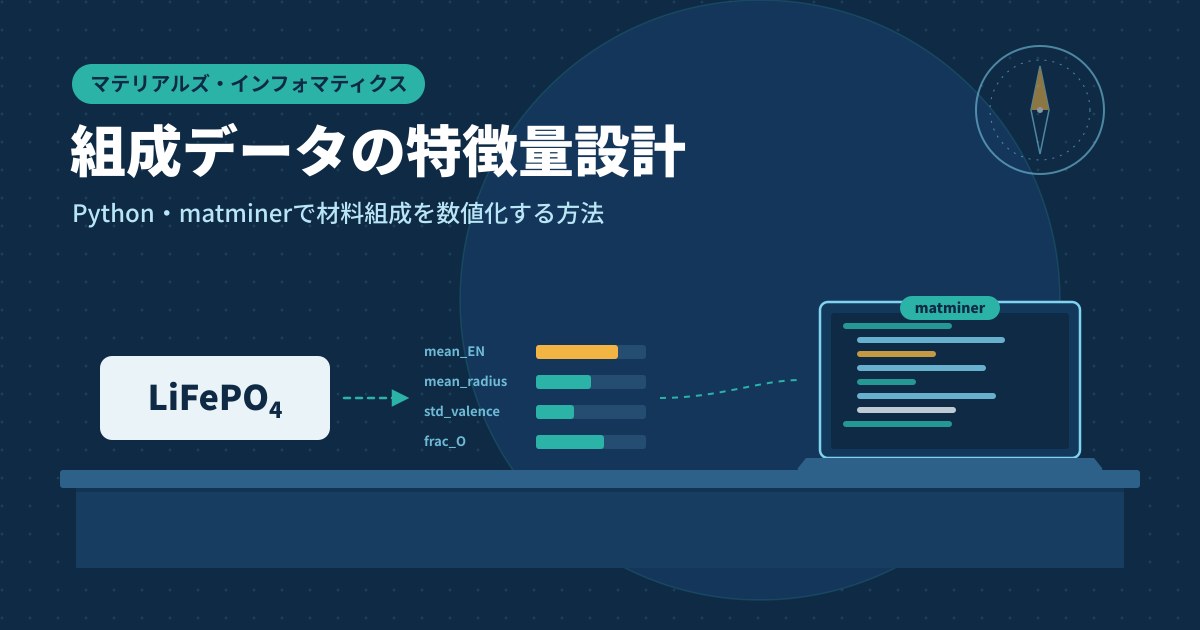
「材料の組成式はあるけれど、機械学習へどう入力すればよいのか」。マテリアルズ・インフォマティクス(MI)を始めると、最初に悩みやすい点です。Fe2O3やAl2O3という文字を表に並べるだけでは、一般的な回帰モデルへそのまま数値として渡せません。材料を、意味の決まった数値の列へ変換する必要があります。
その数値の列が特徴量です。本記事では「組成式を読み込む→元素の割合を計算する→元素の性質をまとめる→CSVへ保存する」の順に進みます。まずFe2O3を手で計算し、Pythonで同じ結果を確かめます。最後に、複数の材料をまとめて変換する完全なコードを使います。
この記事のゴールは、組成式入りのCSVから特徴量CSVを作り、出力が正しいか確認できることです。予測モデルの学習や新材料の性能保証までは行いません。教材の組成一覧は編集部が計算練習用に作ったもので、実験データや実測物性を収集したものではありません。
1.特徴量は「材料を表す数値の項目」
最初に覚える三つの言葉
| 言葉 | 意味 | 本記事の例 |
|---|---|---|
| 組成 | 何が、どの割合で含まれるか | FeとOの比が2:3 |
| 特徴量 | モデルへ渡す数値の項目 | Feの割合、Oの割合 |
| 記述子 | 材料を数値で表した指標 | 原子番号の加重平均 |
特徴量と記述子は重なって使われる言葉です。本記事では、数値の列全体を特徴量、元素の性質から計算した指標を記述子と呼びます。英語の用語をすべて覚える必要はありません。まず「各列が何を数えているか」を説明できれば十分です。
材料の数値化には組成以外に、結晶構造、微細構造、製造条件なども使えます。全体の位置づけは材料開発における特徴量設計で解説しています。本記事はその中の組成に絞り、実際の変換を練習します。
二つの表現を順に作る
最初は元素の割合をそのまま使います。Feが40%、Oが60%なら、Fe列へ0.4、O列へ0.6を入れます。これは元の組成との対応が分かりやすい表現です。
次に、原子番号や電気陰性度などの元素の性質を、割合で重み付けしてまとめます。「どんな元素が含まれるか」を複数の指標で表す方法です。matminerは、こうした組成や構造からの特徴量生成を、Pythonのデータ解析へつなげるツールとして開発されています。[3]
| 段階 | 入力 | 出力 | まず確認すること |
|---|---|---|---|
| 組成の読取り | Fe2O3 | Fe:2、O:3 | 元の記録と一致するか |
| 元素分率の計算 | Fe:2、O:3 | Fe:0.4、O:0.6 | 合計が1になるか |
| 記述子の計算 | 分率と元素物性 | 平均、範囲など | 手計算と一致するか |
| CSV保存 | 数値の表 | 材料ID付きのファイル | 材料IDと列順を保てたか |
2.原子比、質量比、原料配合比を区別する
Fe2O3の「2:3」は質量比ではない
Fe2O3は、FeとOの原子数の比が2:3であることを表します。合計5に対し、Feの原子分率は2÷5=0.4、Oは3÷5=0.6です。原子分率は「全原子に対する割合」で、ここでは0〜1の値を使います。
鉄原子と酸素原子は質量が違います。このためFeの質量分率は0.4ではありません。原子量をFe=55.845、O=15.9994として計算すると、Feの質量分率は約0.6994です。実行確認でも同じ値が得られました。
Feの質量分率=(2×55.845)÷(2×55.845+3×15.9994)
pymatgenには原子分率を求めるget_atomic_fractionと、質量分率を求めるget_wt_fractionが別々に用意されています。[1] 同じ「割合」でも、数えている基準が違います。
| データの種類 | 何を基準にするか | 注意点 |
|---|---|---|
| 原子比・原子分率 | 原子の数 | 本記事の組成式はこの基準で読む |
| 質量比・質量分率 | 質量 | 原子分率へ直すには原子量が必要 |
| 原料配合比 | 投入した原料量 | 原料の純度、反応、揮発などにより最終組成と異なる |
「配合した量」と「材料の組成」は同じとは限らない
例えばガラスの原料配合では、酸化物の配合割合が記録される場合があります。そこから元素の割合へ進むには、各原料の組成と配合の基準を確認する必要があります。さらに、揮発や反応を伴う工程では、計算した投入組成と実測した最終組成が一致するとは限りません。
製薬の製剤配合や高分子のモノマー配合も、複数の成分とその役割を持つデータです。配合比を無機材料の組成式へそのまま置き換えることはできません。本記事のコードは、元素と量が確定した組成式を扱います。原料名から最終組成を推定する機能はありません。
手元の表が「wt%」「at%」「mol%」のどれか分からない場合は、変換を始める前に記録を確認してください。合計が100になることだけでは基準を判断できません。記録の整理は材料データの品質を高める方法も参考になります。
3.まずPythonで一つの組成を読む
実行環境を用意する
Pythonで新しい作業用フォルダーを作り、その中にコードとCSVを置きます。ターミナルはコマンドを入力する画面です。Windowsではコマンドプロンプトなど、macOSではターミナルを使えます。Pythonを既に使っている場合は、普段の実行環境でも構いません。
本記事はPython 3.12.14、matminer 0.9.3、pymatgen 2026.9.24、pymatgen-core 2026.10.2、NumPy 2.3.5、pandas 2.2.3で実行確認しました。pymatgenの本体機能を担うpymatgen-coreの版も記録しています。Webの公式資料と、ここで確認した版は区別します。
python -m pip install matminer==0.9.3 pymatgen==2026.9.24 pymatgen-core==2026.10.2 numpy==2.3.5 pandas==2.2.3インストールできたら、次の短いコードをone_composition.pyという名前で保存します。Fe2O3は半角の英数字で入力します。見た目を整えたFe₂O₃の下付き文字は、コードの入力には使いません。
from pymatgen.core import Composition

comp = Composition("Fe2O3")
print(comp.get_atomic_fraction("Fe"))
print(comp.get_atomic_fraction("O"))
print(comp.get_wt_fraction("Fe"))
python one_composition.py順に0.4、0.6、約0.6994が表示されます。Compositionは、文字で書いた組成を、元素と量の対応として扱うための仕組みです。[1] ここまで動けば、組成の読取りと割合の計算ができています。
同じ割合の組成は同じ数値になる
Fe2O3とFe4O6は、FeとOの比がどちらも2:3です。原子分率は同じになります。一方、FeOならFeとOが1:1なので、どちらも0.5です。
組成の数値化では、式の文字列が違っても同じ表現になることがあります。ただし、分率が同じだから、結晶構造や物性まで同じと判断することはできません。ここで確認できるのは元素の割合です。
4.元素分率を列として並べる
元素の割合をそのまま特徴量にする
matminerのElementFractionは、組成中の各元素の原子分率を、原子番号の順に並べたベクトルへ変換します。[2] ベクトルは、ここでは「決まった順序に並んだ数値の列」と考えてください。
| 組成式 | O列 | Al列 | Fe列 |
|---|---|---|---|
| Fe2O3 | 0.6 | 0 | 0.4 |
| Al2O3 | 0.6 | 0.4 | 0 |
| Fe4O6 | 0.6 | 0 | 0.4 |
表では読みやすく3列だけを示しています。確認した版のElementFractionは118元素を返しますが、本教材の一括変換コードはHからLrまでの103元素列を保存します。原子番号104以降の入力は対象外として検出します。含まれない元素には0が入ります。この0は「含まれないと分かっている」という意味であり、組成が不明な空欄とは違います。
from pymatgen.core import Composition
from matminer.featurizers.composition import ElementFraction

featurizer = ElementFraction()
values = featurizer.featurize(Composition("Fe2O3"))
result = dict(zip(featurizer.feature_labels(), values))
print(result["Fe"], result["O"])
出力は0.4と0.6です。feature_labelsは列名、featurizeは数値を作る処理、zipは対応する列名と数値を組にする処理です。まずFe列とO列を確認してから、全体の表を見てください。

列の順序を変えない
学習時のFe列が、予測時に別の元素を表してしまうとモデルは正しく使えません。列名と順序を保存します。本コードでは毎回同じ元素列を生成し、設定ファイルにも順序を残します。
教材に全く登場しない元素列はすべて0です。予測モデルで不要な列を除く場合も、学習側で決めた列を予測側へ引き継いでください。候補に新しい元素が現れたとき、列が存在するだけで予測可能とは限りません。
5.元素の性質をまとめた記述子を作る
加重平均は「多く含まれる元素を多く数える」
元素分率は組成を直接表します。一方、元素物性の記述子は、各元素の性質を組成比でまとめます。本記事では計算が追いやすい原子番号から説明します。
Feの原子番号は26、Oは8です。単純に二つを平均すると17ですが、Fe2O3ではFeが40%、Oが60%です。この割合を反映した平均は0.4×26+0.6×8=15.2です。多く含まれる元素ほど計算への寄与を大きくするため「加重平均」と呼びます。
平均・範囲・分散・平均絶対偏差を区別する
| 指標 | Fe2O3の計算 | 結果 |
|---|---|---|
| 加重平均 | 0.4×26+0.6×8 | 15.2 |
| 範囲 | 26−8 | 18 |
| 加重分散 | 0.4×(26−15.2)²+0.6×(8−15.2)² | 77.76 |
| 加重標準偏差 | 加重分散の平方根 | 約8.818 |
| 加重平均絶対偏差 | 0.4×abs(26−15.2)+0.6×abs(8−15.2) | 8.64 |
absは符号を除いた大きさです。範囲は、含まれる元素の最大値と最小値の差です。分散は平均からの差を二乗してまとめ、標準偏差はその平方根を取ります。平均絶対偏差は差の絶対値をまとめます。これらは異なる指標で、名前を入れ替えてはいけません。
元素が一種類だけなら、範囲やこれらのばらつきの指標は0です。複数元素がある場合、平均に加えて広がりを表すことで、平均だけでは区別しにくい組成を表す手掛かりになります。ただし、同じ記述子になる異なる組成はあり得ます。
matminerで同じ計算を行う
ElementPropertyは、指定した元素物性と統計量から記述子を作ります。データソースと計算する統計量を選べることが、公式資料で説明されています。[2] 本記事では大量の特徴量を一度に生成せず、原子番号、原子量、電気陰性度の3種類に絞ります。
from pymatgen.core import Composition
from matminer.featurizers.composition import ElementProperty

featurizer = ElementProperty(
    data_source="magpie",
    features=["Number"],
    stats=["mean", "range", "avg_dev"],
    impute_nan=False,
)
print(featurizer.featurize(Composition("Fe2O3")))
出力は[15.2, 18.0, 8.64]です。meanは加重平均、rangeは範囲、avg_devは加重平均絶対偏差です。分散77.76は、この出力には含まれません。完全コードでは分散と標準偏差を別途計算し、manual_Z_varianceとmanual_Z_stdへ保存します。
電気陰性度は、化学結合中で電子を引き付ける傾向を表す指標です。組成中の平均や差を材料表現として使いますが、平均値がそのまま化合物の実測物性になるわけではありません。どの元素物性が予測対象に役立つかは、別途評価が必要です。
6.CSVをまとめて変換する
最初は10行のサンプルで動かす
composition_samples.csvとcomposition_features.pyを同じ作業フォルダーへ置きます。CSVは、各項目をカンマで区切った表です。サンプルには酸化物、窒化物、合金の組成を入れています。物性値の列はありません。
sample_id,formula
S01,Fe2O3
S02,Fe4O6
S03,Al2O3
S04,SiO2
S05,MgO
S06,TiN
S07,AlN
S08,Fe0.7Ni0.3
S09,Cu0.8Zn0.2
S10,Si3N4
sample_idは材料の行を識別する番号、formulaは組成式です。Fe0.7Ni0.3も原子数の割合として読みます。質量70%のFeと30%のNiという意味ではありません。
python composition_features.py確認環境では「Input: 10; converted: 10; errors: 0」と表示され、composition_resultsフォルダーへ結果が保存されました。Matminerから、将来の欠損補完設定に関する警告が表示される場合があります。本コードはimpute_nan=Falseを明示し、欠損を自動補完しません。これは計算が失敗したという表示とは区別します。
出力はこの順番で開く
| ファイル | 内容 | 最初に見る場所 |
|---|---|---|
| conversion_errors.csv | 変換できなかった行と理由 | エラーがあるか |
| element_fractions.csv | 103元素の原子分率 | S01のFe=0.4、O=0.6 |
| element_properties.csv | 15記述子と手計算確認用3列 | mean Number=15.2 |
| composition_metadata.csv | 元組成、同一比率のキーなど | 元のsample_idとの対応 |
| feature_settings.json | ソフトの版、列順、計算設定 | データソース、欠損補完の設定 |
JSONは設定を項目名と値で残す形式です。初心者はまずCSVを開けば十分ですが、後から同じ計算を再現するために設定も一緒に保存してください。element_properties.csvでは、3元素物性×5統計量で15列を作り、手計算確認用の平均・分散・標準偏差を3列加えます。sample_idは識別用で、特徴量ではありません。
完全なコード
次のコードをcomposition_features.pyとして保存します。入力を検査し、組成を読み、元素分率と記述子を計算し、結果を保存する順序です。最初から全行を暗記する必要はありません。上の短いコードが、CSVの各行について繰り返されると考えてください。
完全なPythonコードを表示(composition_features.pyとして保存)
"""Beginner tutorial: known elemental formulas -> numeric features.
Input: sample_id,formula. No target properties or model fitting.
"""
import argparse
import json
import re
from pathlib import Path
from importlib.metadata import version
import numpy as np
import pandas as pd
from pymatgen.core import Composition, Element
from matminer.featurizers.composition import ElementFraction, ElementProperty

PROPERTIES = ['Number', 'AtomicWeight', 'Electronegativity']
STATS = ['minimum', 'maximum', 'range', 'mean', 'avg_dev']

def parse_formula(formula):
    text = str(formula).strip()
    if not text or not re.fullmatch(r'[A-Za-z0-9.()]+', text):
        raise ValueError('Use an ordinary ASCII elemental formula; no charges, placeholders or adduct symbols.')
    comp = Composition(text, strict=True)
    if not comp or comp.num_atoms <= 0:
        raise ValueError('Empty composition.')
    for element, amount in comp.items():
        if not isinstance(element, Element) or not 1 <= element.Z <= 103:
            raise ValueError('Only real elements H through Lr are supported by this tutorial.')
        if not np.isfinite(amount) or amount <= 0:
            raise ValueError('Element amounts must be positive and finite.')
    return comp

def composition_key(comp):
    # A reproducible, approximate identifier for grouping; verify near-equal compositions manually.
    return '|'.join(f'{e.symbol}:{comp.get_atomic_fraction(e):.12f}'
                    for e in sorted(comp.elements, key=lambda e:e.Z))

def generate(frame, destination):
    if not {'sample_id', 'formula'}.issubset(frame.columns):
        raise ValueError('CSV needs sample_id and formula columns.')
    if frame.empty:
        raise ValueError('Input CSV is empty.')
    ids = frame['sample_id']
    if ids.isna().any() or ids.astype(str).str.strip().eq('').any() or ids.astype(str).duplicated().any():
        raise ValueError('sample_id must be nonempty and unique.')
    fractions = ElementFraction()
    descriptors = ElementProperty(data_source='magpie', features=PROPERTIES,
                                  stats=STATS, impute_nan=False)
    fraction_names = fractions.feature_labels()[:103]
    descriptor_names = descriptors.feature_labels()
    f_rows, d_rows, metadata, errors = [], [], [], []
    for _, row in frame.iterrows():
        sample_id = str(row['sample_id'])
        try:
            if pd.isna(row['formula']):
                raise ValueError('Missing formula; do not interpret as an absent element.')
            comp = parse_formula(row['formula'])
            f = np.asarray(fractions.featurize(comp), dtype=float)[:103]
            d = np.asarray(descriptors.featurize(comp), dtype=float)
            if not np.isfinite(f).all() or not np.isfinite(d).all():
                raise ValueError('An elemental property is missing; no automatic substitution was made.')
            if not np.isclose(f.sum(), 1., atol=1e-10):
                raise ValueError('Atomic fractions do not sum to one.')
            weights = np.array([comp.get_atomic_fraction(e) for e in comp.elements])
            numbers = np.array([e.Z for e in comp.elements], dtype=float)
            mean_z = float(np.dot(weights, numbers))
            variance_z = float(np.dot(weights, (numbers-mean_z)**2))
            f_rows.append({'sample_id':sample_id, **dict(zip(fraction_names,f))})
            d_rows.append({'sample_id':sample_id, **dict(zip(descriptor_names,d)),
                           'manual_Z_mean':mean_z, 'manual_Z_variance':variance_z,
                           'manual_Z_std':np.sqrt(variance_z)})
            metadata.append({'sample_id':sample_id, 'formula':str(row['formula']),
                'composition_key':composition_key(comp),
                'element_count':len(comp.elements)})
        except (ValueError, TypeError, KeyError, OverflowError) as exc:
            errors.append({'sample_id':sample_id, 'formula':str(row['formula']), 'reason':str(exc)})
    destination = Path(destination)
    destination.mkdir(parents=True, exist_ok=True)
    error_frame = pd.DataFrame(errors, columns=['sample_id','formula','reason'])
    error_frame.to_csv(destination/'conversion_errors.csv', index=False)
    if not f_rows:
        raise ValueError('No complete rows were converted. Inspect conversion_errors.csv.')
    pd.DataFrame(f_rows, columns=['sample_id',*fraction_names]).to_csv(destination/'element_fractions.csv',index=False)
    pd.DataFrame(d_rows, columns=['sample_id',*descriptor_names,'manual_Z_mean','manual_Z_variance','manual_Z_std']).to_csv(destination/'element_properties.csv',index=False)
    pd.DataFrame(metadata).to_csv(destination/'composition_metadata.csv',index=False)
    settings = {'versions':{p:version(p) for p in ['numpy','pandas','pymatgen','matminer']},
        'element_order':fraction_names, 'data_source':'MagpieData bundled with matminer',
        'properties':PROPERTIES, 'statistics':STATS, 'impute_nan':False,
        'input_rows':len(frame), 'complete_rows':len(f_rows), 'error_rows':len(errors),
        'composition_key_decimals':12,
        'scope':'Known elemental stoichiometry, not raw-material recipes, structures or measured properties.'}
    (destination/'feature_settings.json').write_text(json.dumps(settings,ensure_ascii=False,indent=2),encoding='utf-8')
    print(f'Input: {len(frame)}; converted: {len(f_rows)}; errors: {len(errors)}')
    print('Saved:', destination.resolve())
    if errors:
        print('Review conversion_errors.csv before using the features; incomplete rows were excluded.')
    return pd.DataFrame(f_rows), pd.DataFrame(d_rows), error_frame

def main():
    parser = argparse.ArgumentParser(description=__doc__)
    parser.add_argument('--input', default='composition_samples.csv')
    parser.add_argument('--output', default='composition_results')
    args = parser.parse_args()
    frame = pd.read_csv(args.input, dtype={'sample_id':'string','formula':'string'}, keep_default_na=False)
    generate(frame, args.output)

if __name__ == '__main__':
    main()
7.自分のCSVに置き換える
必須の列名を合わせる
自分の表にsample_idとformulaの2列を用意し、my_compositions.csvという名前で保存します。他の列を残しても構いませんが、このコードは物性値や製造条件を処理しません。CSVはUTF-8で保存してください。日本語の列名や文字化けを含む場合は、実行前に確認します。
python composition_features.py --input my_compositions.csv --output my_features各行のsample_idを一意にします。同じ組成を異なる試料で測定した場合も、別のsample_idを付けます。同一の組成だからといって元データを削除する必要はありません。
composition_keyは元素分率を小数12桁で並べた照合用キーです。Fe2O3とFe4O6は同じキーになります。ごく小さな組成差が丸められる可能性があるため、同一試料の証明や厳密な化学式識別子として使いません。微量添加を含むデータでは、記録精度に合う照合基準を決めます。
エラーを0で埋めない
| 困りごと | 対応 |
|---|---|
| formulaが空欄 | 組成が不明な理由を確認する。全元素0へ置き換えない |
| 下付き文字・全角文字 | 元の記録を確認して半角の組成式へ直す |
| Fe1-xNixなど未確定の式 | xの数値を決め、具体的な組成へ展開する |
| 元素物性が欠損 | データソースと対象元素を確認。補完の根拠を検討する |
| sample_idが重複 | 行と試料の対応を確認し、一意なIDへ直す |
| 水和物・電荷・同位体の表記 | 教材の対象外。意味を保つ別の入力設計を行う |
変換できない行はconversion_errors.csvへ残し、数値出力から除きます。全行が変換できなければ停止します。数値ファイルができた場合も、元の行数と変換済み行数を照合してください。エラー行を確認せずに結果だけで学習すると、対象材料の偏りを作ることがあります。
ASCIIのピリオドは小数係数として使います。水和物をCuSO4.5H2Oのように入力すると、結晶水の区切りか小数かが曖昧です。本教材では、その表記を使いません。ツールが文字を読めたことと、化学的な意味が正しいことは別です。
8.作った特徴量をモデルへ渡す前に
固定した計算と、データから学ぶ前処理を分ける
既知の元素データを使い、各組成から同じルールで特徴量を作る処理は、目的物性を見て学習する処理ではありません。一方、欠損を学習データの平均で補う、標準化する、特徴量を選ぶといった処理は、評価用データを使って決めないようにします。
原子番号の加重平均が計算できたことと、それが予測精度を上げることは別です。元素分率のみ、記述子のみ、必要な組み合わせを、同じ評価分割で比較します。組み合わせを見て何度も選び直す場合は、評価結果への合わせ込みにも注意します。
同じ組成や同じバッチの試料を学習側と評価側へ分けると、未知材料への予測を楽観的に評価する場合があります。分割の考え方は材料データで交差検証を設計する方法を参照してください。数値特徴量だけでなく、元のsample_id、組成、バッチ情報も保持します。
最初からすべての列を学習へ入れない
元素分率は合計が1です。各列が独立に変わる変数ではなく、ある元素が増えると他の割合が変わります。線形モデルの係数を「この元素だけを独立に増やした効果」と読むと、解釈を誤ることがあります。
元素分率の全0列、重複する記述子、データ数に対して多すぎる列を確認します。確認用のmanual_Z_meanはMagpieData mean Numberと重複するため、学習へ両方を入れる必要はありません。sample_idやcomposition_keyも、物性を予測する数値特徴量として渡しません。
9.組成だけでは表せないこと
同じ組成でも材料の状態は違う
TiO2という組成式だけでは、結晶構造の違いは分かりません。合金でも熱処理や組織が異なれば性質は変わり得ます。組成式に含まれない情報を、組成の統計量が自動で復元するわけではありません。
高分子では分子量や分岐、共重合構造など、元素分率だけでは区別しにくい情報があります。製薬の分子も、同じ分子式でも原子のつながり方が異なる場合があります。こうした対象へ進むときは、分子構造や工程など、目的に合った表現を追加します。
未知元素の列があっても予測は保証されない
103元素の列を作るため、学習に現れなかった元素にも列があります。しかし、その列に関する関係をモデルが学習したことにはなりません。元素物性の記述子へ変換しても、既知の記述子範囲から大きく外れる場合があります。
適用範囲を確認する考え方はモデルの適用範囲(AD)で解説しています。本記事の変換コードはAD判定や予測信頼度の計算を実装していません。特徴量を生成できたことを、予測の信頼性と同一視しないでください。
10.確認チェックリスト・FAQ・まとめ
作業が終わったら確認すること
- 原子比・質量比・原料配合比を区別したか。
- 元の組成式とsample_idを保持したか。
- 原子分率の合計が1で、Fe2O3の確認値が一致したか。
- 0と不明値を混同せず、conversion_errors.csvを確認したか。
- 元素物性のデータソース、ソフトの版、列順を保存したか。
- 確認用の重複列と識別IDを学習特徴量から分けたか。
- 学習時と予測時で同じ列・同じ計算を使う準備ができたか。
- 組成だけで表せない構造や工程を把握したか。
Q.小数を含む組成も使えますか?
Fe0.7Ni0.3のように量が確定した式は使えます。これは原子数の割合です。未知のxや負の係数を含む式は対象外です。酸素欠損などを扱う場合も、測定・設計した量の意味を確認して入力してください。
Q.酸化数を指定しないと計算できませんか?
本記事の元素分率と元素物性記述子には、酸化数を使いません。酸化数やイオンの性質を使う記述子へ拡張する場合は、その決定方法と不確かさが別に必要です。自動推定した値を測定事実と同じに扱わないでください。
Q.同じ組成式なら重複行を削除してよいですか?
同じ試料の二重登録か、独立試料か、製造条件が違うかを確認します。組成が同じという理由だけで削除しません。数値化では同じ特徴量になるため、違いを表す情報を別に残すことが必要です。
Q.どの記述子が最も良いですか?
対象材料と予測する物性によって違います。まず元素分率を基準にし、意味を説明できる少数の記述子を比較します。本記事の3元素物性と5統計量は学習用の選択で、最良の予測精度を保証する組み合わせではありません。
Q.表のエラーが多いときはどうしますか?
個別の修正より先に、原料名が入っていないか、式の表記が統一されているか、比率の基準が同じかを確認します。一括置換で化学的意味を変えないよう、原記録と訂正履歴を残してください。
まとめ:一つの計算を確かめてから、一括変換へ進む
最初に、Fe2O3からFe=0.4、O=0.6が得られることを確かめます。次に、原子番号の加重平均15.2、範囲18、平均絶対偏差8.64を確認します。最後にサンプルCSVをまとめて変換し、エラー、列名、材料IDとの対応を見ます。
この流れができれば、自分の組成データを数値化する入口に立てています。その後は目的物性や製造条件を整理し、適切な交差検証で表現を評価します。特徴量を増やすことより、入力と計算結果の意味を説明できることを優先してください。
参考文献
[1]pymatgen developers. pymatgen.core, Composition API documentation. 更新型公式資料、2026年10月7日閲覧。https://pymatgen.org/pymatgen.core.html
[2]matminer developers. matminer.featurizers.composition package. 更新型公式資料、2026年10月7日閲覧。https://hackingmaterials.lbl.gov/matminer/matminer.featurizers.composition.html (公式Web資料は0.10.0rc0表示、本教材の実行確認は安定版0.9.3)。
[3]Ward, L., et al. Matminer: An open source toolkit for materials data mining. Computational Materials Science, 152, 60–69, 2018. DOI:https://doi.org/10.1016/j.commatsci.2018.05.018 。研究グループ公開本文:https://perssongroup.lbl.gov/papers/ward-2018-matminer.pdf