
この記事で学べること
- 時系列解析とは何か、通常の表データの解析との違いと注意点
- 温度や流量の工程ログを、バッチごとの品質予測に使える表へ変換する方法
- 時刻のそろえ方、短い欠測の補間、長い欠測を保留する判断基準
- 平均・最大値・昇温速度・保持時間などの特徴量の意味と計算方法
- PythonでCSVを読み込み、過去のバッチで学習して後のバッチを予測する手順
- 予測誤差を確認し、現場で追加調査する対象を見つける方法
- 品質未測定の新規バッチを、保存済みモデルで予測する方法
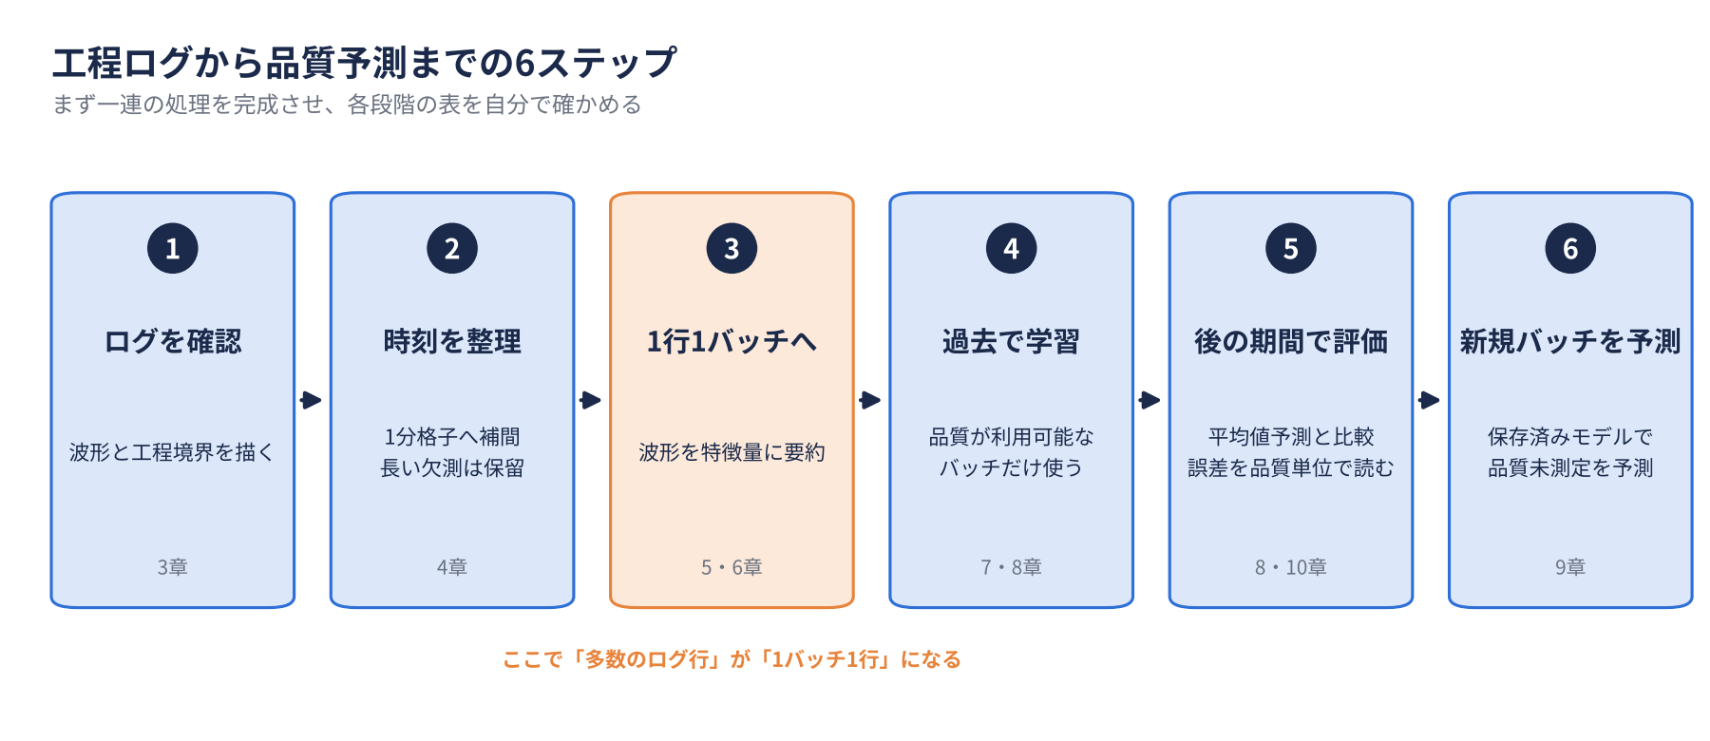
「温度や圧力のデータは残っている。しかし、どの時間帯が品質に関係するのか分からない」。製造プロセスのデータ活用では、この段階で手が止まりがちです。最初から複雑な深層学習を使う必要はありません。まず工程の区切りを確認し、波形を少数の説明しやすい数値に変えると、品質との関係を検討できます。
この記事の到達点は、工程が終わった時点で、その工程ログから最終品質を予測することです。品質測定の結果が届くまでの判断を補助する用途を想定します。運転中の先読みや装置の自動制御は扱いません。工程全体のデータを使うため、途中の時点で同じ予測を利用することはできないからです。
実装には編集部が作成した仮想の粉体熱処理データを使います。温度、流量、品質の関係を学習しやすい形で人工的に設定しており、実材料の性能や推奨製造条件を示すデータではありません。考え方の全体像は、プロセスインフォマティクスの基礎記事も参照してください。
1.時系列解析とは?時間の並びを含めてデータを読む
時系列解析は、時間の順序・間隔・変化・遅れを考慮して、データの特徴や関係を調べる解析です。温度、圧力、流量がいつ、どのように変わったかを見ます。将来値の予測だけでなく、工程の状態を把握する、異常を見つける、工程の履歴と最終品質の関係を調べることも含みます。
平均が同じでも、工程の意味は違う
同じ間隔で測った温度が、バッチAでは100・200・300℃、バッチBでは200・200・200℃だったとします。どちらの点平均も200℃ですが、Aは昇温し、Bは一定温度を保持しています。さらにAの値を300・200・100℃へ並べ替えると、平均も最大値も同じまま、工程は冷却に変わります。平均・最大値だけでは時間の順序を表せないことが分かります。これは説明用の3点で、品質差を実証する例ではありません。
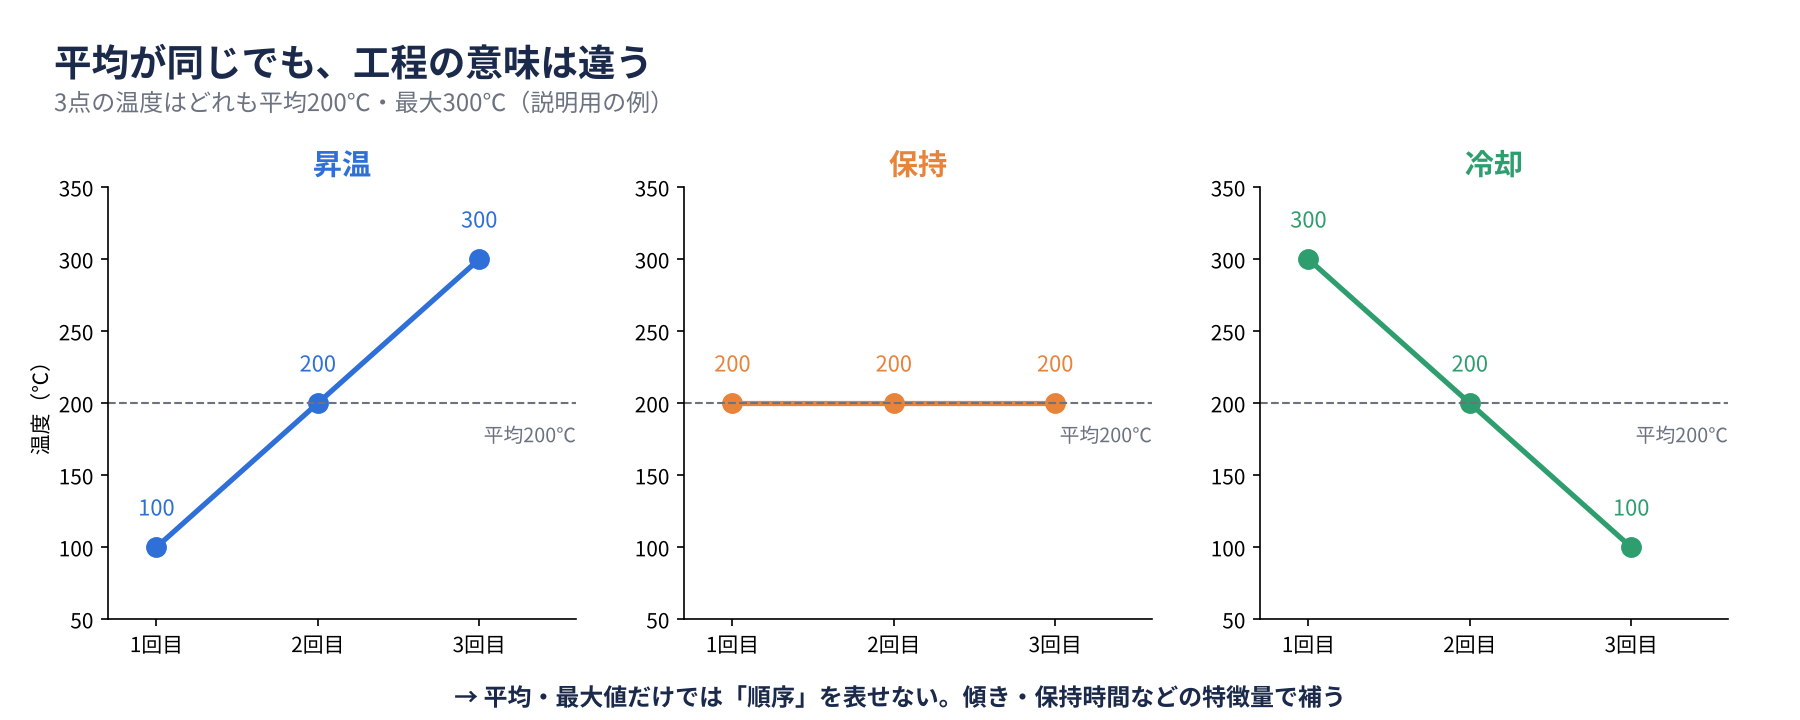
そこで、まず波形を描き、次に昇温速度、保持温度、温度域に滞在した時間などへ要約します。時系列を描くことは、変化や異常、変数間の関係を見つける入口になります。[6]
通常の表データの解析と何が違うか
| 観点 | 独立した試料を1行ずつ扱う例 | 工程ログを扱うとき |
|---|---|---|
| 行の意味 | 1行が1試料。並べ替えても試料の意味は変わらない | 1行がある時刻の観測。順序や間隔が工程の意味を持つ |
| 独立性 | 試料間の独立性を確認する | 同じバッチの近い時刻は似やすい。多数のログ行≠多数の品質サンプル |
| 説明変数 | 組成・処理条件などをそのまま使えることがある | 波形から区間の平均、傾き、滞在時間などを作る |
| 情報の利用時点 | 判断時に値を入手できるかを確認する | 後の観測による補間や工程終了後の値を、途中予測に使わない |
| 評価 | 用途に合わせて試料・グループなどで分ける | 将来製造を想定するなら、過去で学習し後の期間で評価する |
表データでも、同じロットの試料が似るなどの依存関係はあります。「表データなら独立、時系列なら必ず特別なモデル」と決めるのではなく、データが作られた単位と時間構造を確かめます。
時系列解析の目的と、本記事の位置づけ
| 目的 | 問いの例 | 本記事との関係 |
|---|---|---|
| 状態把握 | 昇温・保持・冷却が想定通りか | 波形と工程境界を確認する |
| 異常検知 | 圧力や温度に通常と違う動きがあるか | 調査の入口。異常検知器の実装は別の課題 |
| 将来の値を予測 | 10分後の温度はどうなるか | 本記事の予測対象ではない |
| 工程履歴から品質予測 | 終了した工程のログから最終品質を見積もれるか | 本記事で実装する |
本記事は、波形を1行1バッチの特徴量へ変え、その表に回帰モデルを使います。ARIMAやLSTMのように将来の信号を直接予測する方法を一通り紹介する記事ではありません。まずこの構成で、工程ログを品質へ結ぶ一連の処理を完成させます。
最初に確認したい5つの注意点
- 時間の順序:予測する時点で利用できない情報を入れない。
- 独立した単位:同一バッチの測定点を独立した品質データとして数えない。
- 時間の対応:時計のずれ、記録間隔、工程境界、信号から品質へ影響が現れるまでの遅れを確認する。
- 欠測:補間は仮定に基づく推定。長い欠測や工程切替を滑らかな線で隠さない。
- 条件の変化:原料・装置・品種・時期が変われば関係も変わり得る。残差を時間順に確認する。
目標は「ログを確認→時刻を整理→1行1バッチへ変換→過去で学習→後の期間で評価→新規バッチを予測」という順に、各段階の表を自分で確かめることです。
2.工程ログと品質データをどう結び付けるか
時系列データとバッチデータの違い
時系列データとは、観測時刻と測定値が対応したデータです。温度が1分ごとに記録されるなら、1バッチに多数の行ができます。一方、最終品質がバッチに一つなら、予測モデルの基本単位はバッチです。1バッチの60個の温度を、独立した60個の品質サンプルと考えてはいけません。
同じバッチ内の近い時刻の値は似やすく、測定点を増やしても独立した材料や製造回数が増えるわけではありません。本例は72バッチを用意します。多数のログ行があっても、品質予測の学習に使える件数は、条件を満たしたバッチの数で決まります。
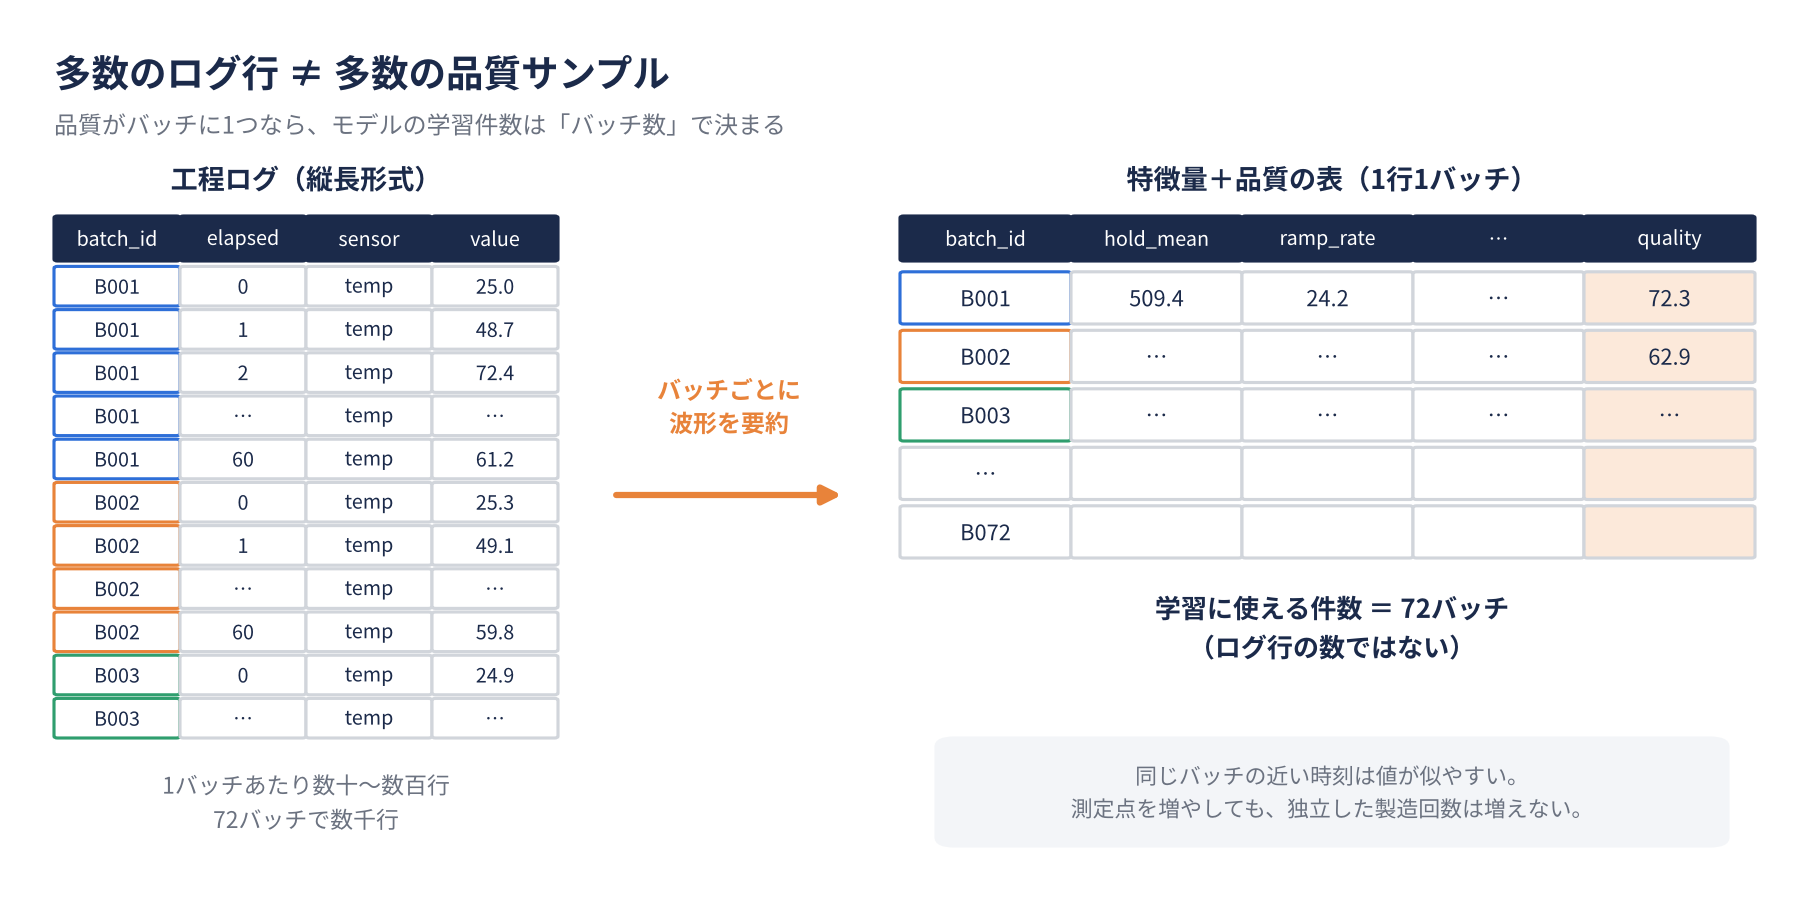
入力は二つのCSVです。工程ログは「縦長形式」にします。温度と流量の記録間隔が違っていても、センサー名の列があれば一つの表で管理できます。
| 工程ログの列 | 内容 | 仮想例 |
|---|---|---|
| batch_id | 品質表と共通のバッチID | B001 |
| timestamp | 測定時刻、タイムゾーン付き | 2026-01-01T09:00:00Z |
| sensor | 測定項目 | temperature または flow |
| value | 数値 | 25.0 |
品質表には、batch_id、工程開始start、終了end、昇温終了ramp_end、保持終了hold_end、品質が利用可能になった時刻quality_available_at、品質値qualityを置きます。昇温、保持、冷却の境界は実際の工程イベントから記録するのが基本です。波形の見た目だけで後から境界を決めると、担当者や条件によって定義が変わります。
測定時刻と「利用できた時刻」を分ける
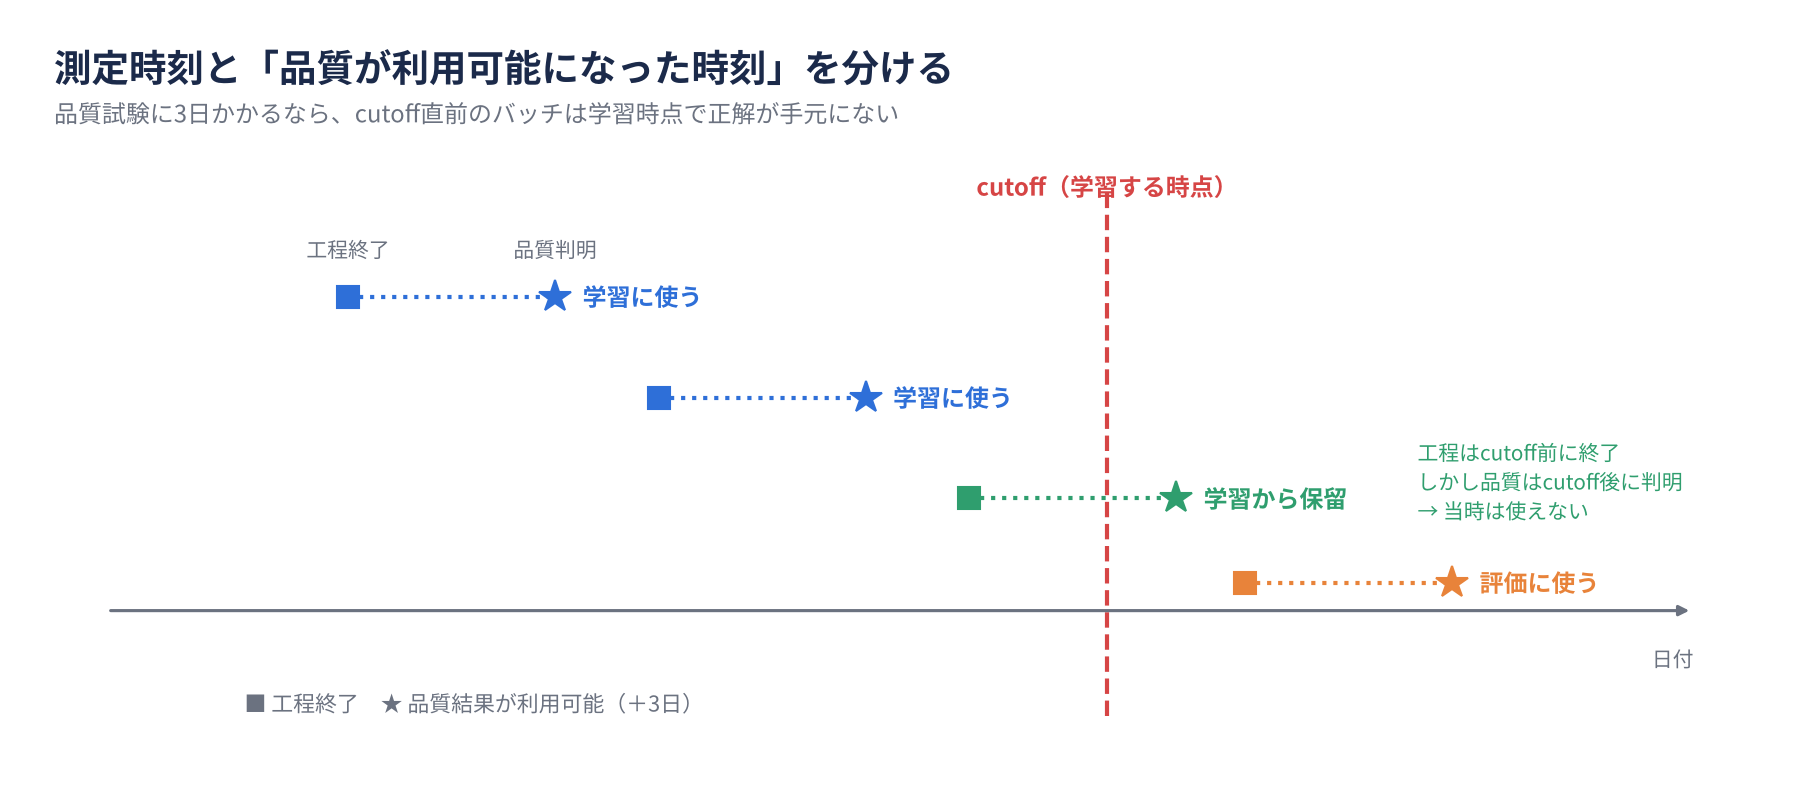
品質の試験が工程終了の3日後に完了するなら、翌日にモデルを学習する時点では、その結果を使えません。データベースには結果が存在していても、過去の判断を再現する検証では、当時の利用可能時刻を確認します。本例はquality_available_atを使って、この違いを明示します。
単位もそろえます。仮想例の温度は℃、流量はL/min、品質は任意単位a.u.です。実務ではセンサーの校正履歴、装置ID、原料ロット、品種も関連付けましょう。ただし、まずは小さな列数で一連の処理を完成させる方が、誤った結合や時刻を発見しやすくなります。
品質表も、1行1バッチで準備する
| batch_id | start | end | ramp_end | hold_end | quality_available_at | quality |
|---|---|---|---|---|---|---|
| B001 | 2026-01-01 09:00:00+00:00 | 2026-01-01 10:00:00+00:00 | 2026-01-01 09:20:00+00:00 | 2026-01-01 09:40:00+00:00 | 2026-01-04 09:00:00+00:00 | 72.257 |
| B002 | 2026-01-02 09:00:00+00:00 | 2026-01-02 10:00:00+00:00 | 2026-01-02 09:20:00+00:00 | 2026-01-02 09:40:00+00:00 | 2026-01-05 09:00:00+00:00 | 62.928 |
新規予測用の工程境界表は、ここからqualityとquality_available_atを取り除いたbatch_idと4つの工程時刻の計5列です。正解値を仮のゼロで埋める必要はありません。
3.最初に波形を描き、工程の区切りを確認する
時計の時刻より、工程開始からの経過時間で比較する
午前開始のバッチと午後開始のバッチを時計の時刻で重ねても、工程の違いは読み取りにくくなります。各バッチの開始時刻を引き、経過分に変えて描きます。本例では0~20分が昇温、20~40分が保持、40~60分が冷却です。この境界と時間は説明用で、実工程のレシピではありません。
図ではまず、温度が目標域に達しているか、保持中に大きく揺れていないか、冷却が遅れていないかを見ます。流量は、記録が途切れていないか、工程途中に変更されていないかを別の軸で確認します。図に工程境界を添えると、単なる上下動を工程上の出来事として読みやすくなります。

工程時間が違うバッチを比較するときは、経過時間のまま見る方法と、工程の進行率でそろえる方法があります。前者は「保持が長かった」という違いを残せます。後者は波形の形の比較に向きますが、時間の違いを消すため、保持時間そのものも別の特徴量として残す必要があります。
本例は工程時間が同じという簡単な条件から始めます。時間が変わる現場では、段階ごとの抽出へ拡張してください。伸び縮みさせた波形の比較や高度な整列を導入する前に、装置イベントによる境界の定義を確認することが先です。
4.時刻のずれと欠測を整える
時刻をそろえる二つの操作
pandasには、日時を扱う機能と、時系列を指定した頻度へまとめるresampleがあります。たとえば毎秒の測定を1分平均へ集約するなら、各時間区間に入った観測値を平均します。一方、測定のない時刻へ値を推定する操作は補間です。集約と補間は役割が違います。[1]
| 操作 | 何をするか | 向いている場面 |
|---|---|---|
| 時間区間ごとの集約 | 区間内の観測値を平均・最大値などにまとめる | 高頻度ログを低頻度の表へ整理する |
| 線形補間 | 前後の観測を直線で結び、間の値を推定する | 滑らかな信号の短い記録抜けを補う |
| 前の値を保持 | 次の変更まで直前の値が続くと仮定する | 実際に保持される設定値などを表現する |
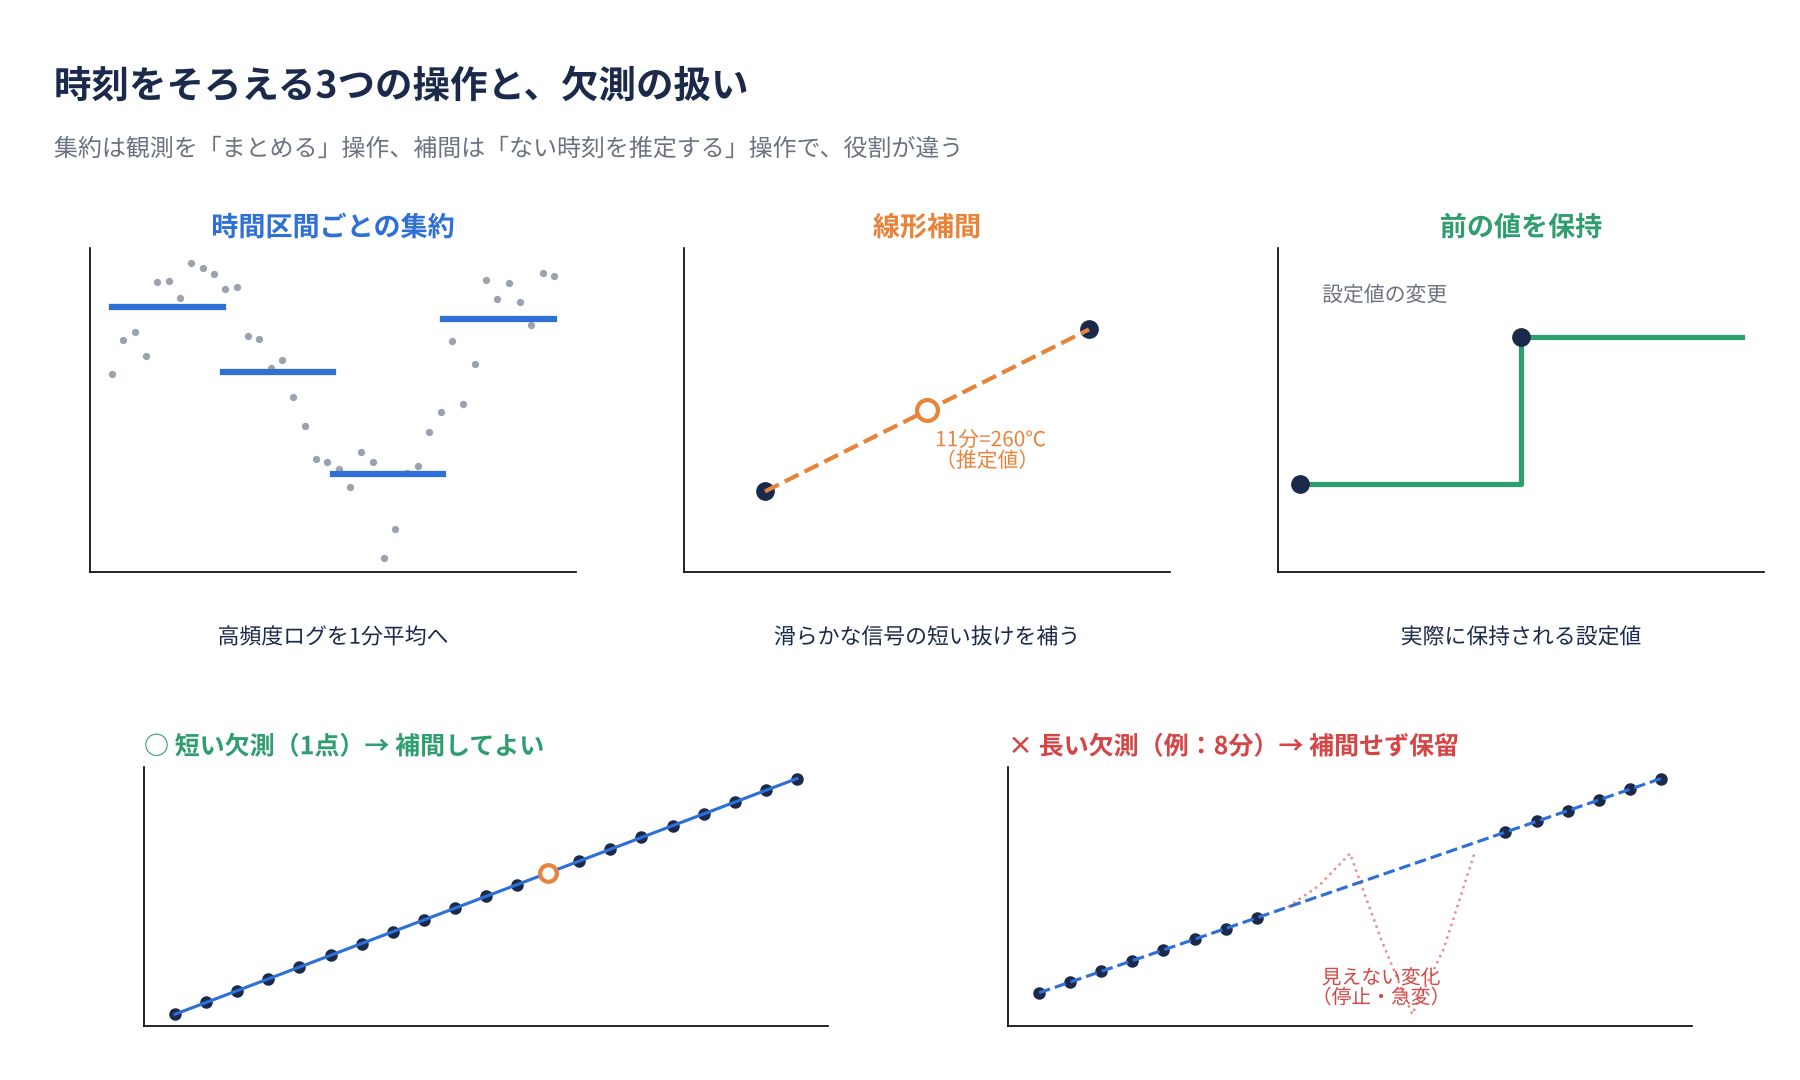
本例は温度が毎分、流量が2分間隔なので、両者を1分間隔の格子へ線形補間します。元の観測時刻と格子の時刻を合わせた表で補間し、最後に格子上の値を取り出します。先に格子へ再配置して元の値を捨てると、30秒などの格子外にある観測が失われるためです。
集約を使う場合は、区間の境界、左端・右端のどちらを含めるか、結果の時刻をどちらへ付けるかも固定しましょう。午前10時の行が「10時直前の1分」なのか「10時からの1分」なのかで、イベントとの対応が変わります。[1]
短い欠測を補い、長い欠測は保留する
線形補間の簡単な例です。10分の温度が250℃、12分が270℃なら、その間を直線と仮定した11分は260℃になります。しかし、その間に急な温度上昇や装置停止があれば、この仮定は合いません。欠測が長いほど、見えない変化を見逃す可能性も大きくなります。
サンプルコードは観測間隔が180秒を超えるバッチを除外します。この3分は教育用の設定であり、一般的な許容基準ではありません。温度の応答速度、センサーの通常の記録間隔、許容誤差を基に決めます。高速な圧力変動なら3分は長すぎることがあります。工程開始・終了に観測がない場合も、外側へ推定を延ばさず除外します。
欠測はゼロに置き換えません。0℃と「測定していない」は意味が違うからです。また、バッチをまたいで補間しません。前の運転の終了値と次の運転の開始値をつなぐと、存在しない工程が作られてしまいます。同じセンサー・同じ時刻の重複は処理を止め、元の記録を調べます。
今回の補間は、工程終了後にすべてのログがそろっている前提です。後の観測を使えるため、運転中のリアルタイム推定へそのまま移せません。工程段階の切り替えをまたぐ補間も、現場では分けて処理すべき場合があります。欠測と測定条件の管理は、材料データの品質を高める方法で詳しく整理しています。
5.波形を特徴量へ変える
特徴量は「工程について答えたい問い」を数値にしたもの
特徴量とは、モデルへ入力する説明変数です。「十分に加熱できたか」を表したいなら、最高温度や一定温度以上の時間が候補になります。「保持が安定していたか」なら、保持中の平均とばらつきを分けます。同じ全体平均でも、急速な昇温と長い保持では工程の意味が違うためです。
本例では、次の7項目を使います。すべて工程終了時点までに計算できる値です。
| 特徴量 | 計算と意味 | 単位 |
|---|---|---|
| temp_mean | 全工程の1分格子上の温度平均 | ℃ |
| temp_max | 格子上の最高温度 | ℃ |
| hold_temp_mean | 保持区間の温度平均 | ℃ |
| hold_temp_std | 保持区間の温度の標準偏差 | ℃ |
| ramp_rate | 昇温区間を直線に近似した傾き | ℃/min |
| above_threshold_min | 480℃以上だった時間の近似 | min |
| hold_flow_mean | 保持区間の流量平均 | L/min |
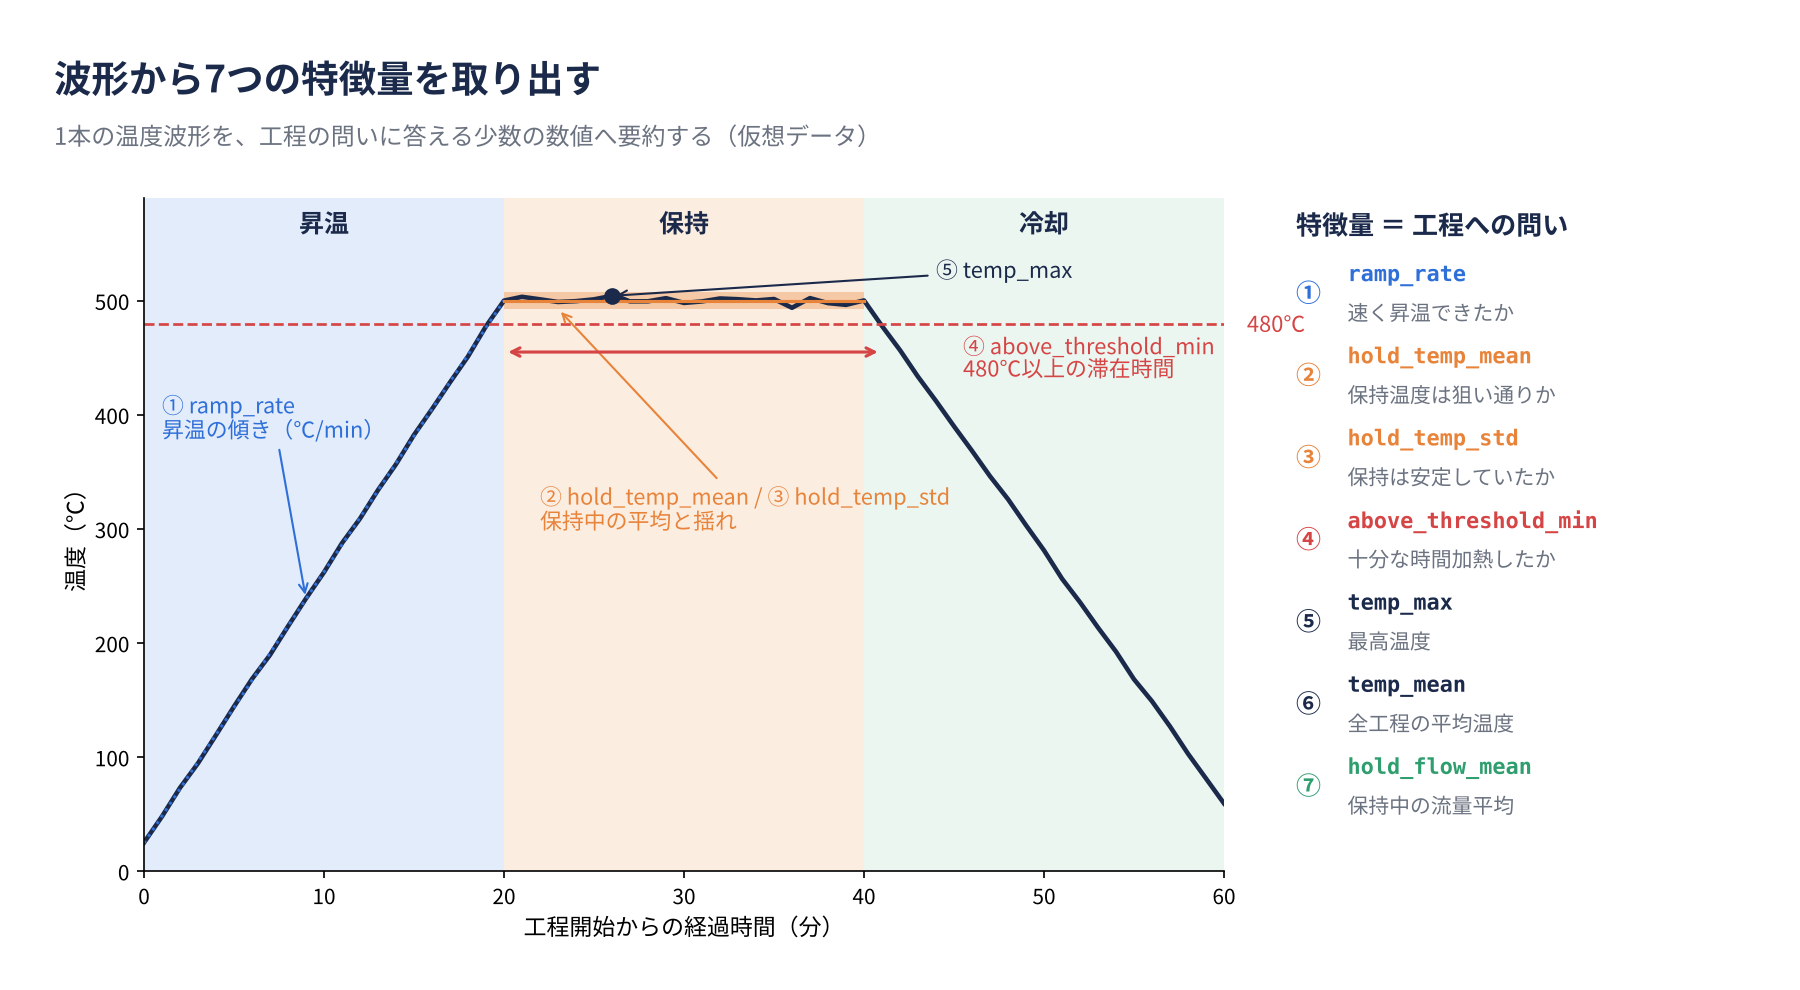
480℃という閾値は説明用です。実務では反応、相変化、乾燥などの意味がある温度を根拠付きで選びます。モデルの評価結果を見ながら多数の閾値を試すと、評価データに都合のよい選択になるため、最終評価前に決めるか、学習データ内で選びます。
平均・ばらつき・傾き・時間を手計算で理解する
保持中の温度が498、500、502℃なら、平均は500℃です。標本標準偏差は、平均との差の二乗の合計8を、点数から1を引いた2で割り、平方根を取った2℃になります。コードもddof=1を指定します。ただし、この値は波形の揺れの要約であり、独立試料間の品質ばらつきや平均の不確かさではありません。連続時刻の相関や補間も値に影響します。
昇温速度は「温度=切片+傾き×経過分」の直線を最小二乗で当てはめた傾きです。0、1、2分の温度が100、110、120℃なら、傾きは10℃/minです。曲線的な昇温では、この一つの値だけで形を表せないため、区間を分けるなどの工夫が必要です。
閾値以上の時間は、測定点数を数えるだけではなく、各区間の長さを足します。0、1、2分の温度が480、479、500℃なら、左端の値が480℃以上の区間は0~1分だけで、合計1分です。最後の2分の点に追加の1分を与えてはいけません。コードは各区間で左端の温度が続く近似を使います。閾値を横切った正確な瞬間は分からないので、格子間隔に応じた近似誤差があります。
全工程平均も、この例では開始と終了を含む61点の算術平均です。厳密な時間積分の平均とは同じではありません。工程時間や間隔が違うデータでは、時間加重平均や積分値を使うべきか検討してください。特徴量の定義は、名前だけでなく対象区間、単位、端点の扱いまで残すことが重要です。材料開発の特徴量設計も参考になります。
6.PythonでCSVからバッチ単位の表を作る
実行環境と動かし方
完全版スクリプトには仮想データ生成も含めました。記事末尾の完全版を作業用フォルダーにprocess_timeseries.pyとして保存し、必要なライブラリを入れます。動作確認環境はPython 3.12.14、NumPy 2.3.5、pandas 2.2.3、scikit-learn 1.8.0です。別の環境では実際のバージョンと出力を記録してください。
python -m pip install numpy pandas scikit-learn matplotlib joblib
python process_timeseries.py
実行するとprocess_resultsフォルダーに入力CSV、特徴量、除外理由、予測値、図、summary.json、model.joblibが出力されます。まず入力CSVを開き、B001がログと品質表の双方に存在することを確かめてください。完全版の処理では、IDの不一致や品質表のID重複を検出して止まります。除外するバッチも理由をCSVに残します。
自分のデータを使う場合は、同じ列名と形式へ整えて、二つのCSVを指定します。cutoffは学習と評価を分ける日時です。対象期間に合わせて変更してください。
python process_timeseries.py --logs process_logs.csv --quality batch_quality.csv --cutoff 2026-02-20T00:00:00Z --output my_results時刻にはZまたは+09:00などのタイムゾーンを付けます。コードはUTCへ統一します。更新版コードはタイムゾーンのない時刻をエラーにします。日本時間なら+09:00を明示してから渡してください。値の数値変換だけでは、℃とK、L/minとmL/minの混在は発見できないので、入力前の単位確認が必要です。
バッチIDで結合し、行数を確認する
特徴量の表は1行が1バッチです。品質表も同じ単位なので、batch_idで一対一に結合します。行の順番で横に並べる方法は、除外や並べ替えによって別の品質と結び付く危険があります。
data = features.merge(
    quality_table, on="batch_id", how="left",
    validate="one_to_one", indicator=True
)
assert (data["_merge"] == "both").all()
これは結合部分の概念を示す短いコードです。完全版ではquality_tableに相当するメタデータから必要な列を取り出します。全入力のID集合も事前に一致を確認し、内側結合で対応のない行を黙って落とすことを避けています。
本例は60分で終わり、終了が指定した格子に合う工程に限定しています。秒単位の終了や工程構成の違うデータを使う場合は、格子と区間の定義を先に変更します。また、品質値が欠測している入力は処理を止めます。未測定の新規バッチを予測する運用へ進む際には、更新版には予測専用モードを追加しました。後半で品質列を持たない新規入力を実行します。
同じB001が、処理ごとにどう変わるか
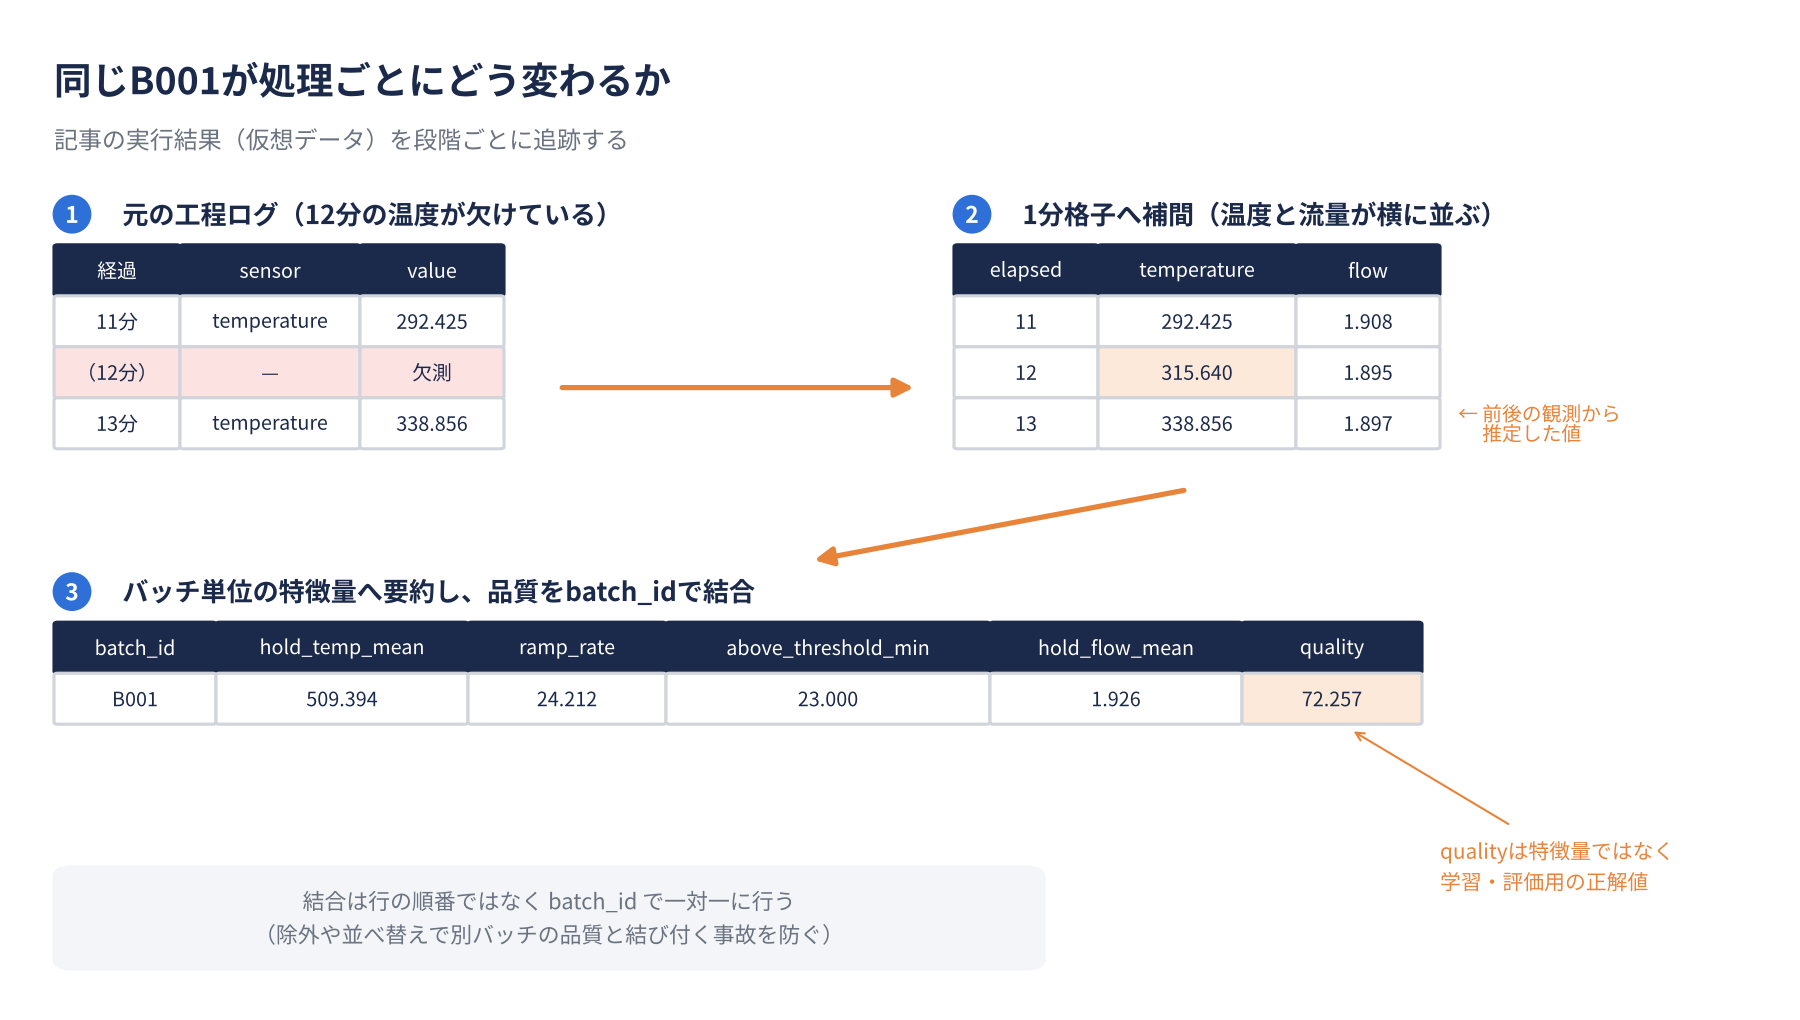
まず元ログの経過11~13分付近を見ます。12分の温度点は欠けています。以下の表は、完全版を実行して得た合成データから抜き出したものです。
| batch_id | timestamp | sensor | value |
|---|---|---|---|
| B001 | 2026-01-01 09:10:00+00:00 | temperature | 267.154 |
| B001 | 2026-01-01 09:11:00+00:00 | temperature | 292.425 |
| B001 | 2026-01-01 09:13:00+00:00 | temperature | 338.856 |
補間後は共通の格子上に温度と流量が並びます。12分の温度は観測値ではなく、前後の観測から補った値です。
| batch_id | elapsed_min | temperature | flow |
|---|---|---|---|
| B001 | 11.000 | 292.425 | 1.908 |
| B001 | 12.000 | 315.640 | 1.895 |
| B001 | 13.000 | 338.856 | 1.897 |
その波形を要約すると、1行1バッチになります。qualityは特徴量ではなく、学習・評価用の正解値です。
| batch_id | hold_temp_mean | ramp_rate | above_threshold_min | hold_flow_mean | quality |
|---|---|---|---|---|---|
| B001 | 509.394 | 24.212 | 23.000 | 1.926 | 72.257 |
7.過去で学習し、後のバッチで評価する
工程終了時刻と品質の利用可能時刻で分ける
将来の製造に使うモデルなら、過去で学習して後の製造で評価する条件をまず用意します。本例は2026年2月20日0時UTCを境界に、工程がそれより前に終了し、品質結果もその時点までに利用可能だったバッチを学習に使います。それ以後に終了したバッチを、後から品質が分かった段階で評価します。
| 処理 | バッチ数 | 意味 |
|---|---|---|
| 入力 | 72 | 仮想データの全バッチ |
| ログ不備で除外 | 1 | B008は温度の観測間隔が8分空いている |
| 学習 | 46 | 境界前に終了し、品質結果も利用可能 |
| 評価 | 22 | 境界以後に終了したバッチ |
| 学習から保留 | 3 | 境界前の工程だが、品質結果がまだ利用できない |

46+22+3=71となり、ログ不備の1件を除くバッチの扱いを追跡できます。コードの最低学習10件・評価5件という条件は、極端に小さい分割で実行しないための簡単なガードです。統計的に十分なサンプル数を保証する基準ではありません。
交差検証へ進むときも、バッチを壊さない
一回の期間分割は分かりやすい反面、境界の選び方に影響されます。実務では、複数の学習時点から後続期間を評価する方法へ進めると、運転条件や季節による変動を調べられます。scikit-learnのTimeSeriesSplitは、前のサンプルで学習して後のサンプルを評価する分割を提供します。[4]
ただし、TimeSeriesSplitへセンサーの各測定行をそのまま渡せばよいわけではありません。バッチ単位の表を並べて分け、品質結果の遅れも別に確認します。また、公式資料では評価期間を比較可能にするために等間隔のサンプルが前提とされています。不規則な製造日程では、カレンダー期間を明示した分割を設計しましょう。[4]
今回の完全版は、一回の後続期間を最終評価として残し、それより前の2期間を開発用に検証します。alphaの最適化は実施していません。分割の考え方は、材料データの交差検証も参照してください。
過去の複数期間でも誤差を確認する
完全版は、最終評価の前に二つの10日間を検証するperiod_validation.csvも出力します。各期間の開始時点で品質結果が利用できるバッチだけで学習し、次の10日間を評価します。これらは開発中の診断用です。この結果を使って特徴量やalphaを変更する場合、最終評価期間は別に残してください。
| origin | end | train | validation | mae |
|---|---|---|---|---|
| 2026-01-31 00:00:00+00:00 | 2026-02-10 00:00:00+00:00 | 26 | 10 | 0.908 |
| 2026-02-10 00:00:00+00:00 | 2026-02-20 00:00:00+00:00 | 36 | 10 | 0.493 |
この2期間は最終評価とは重ならず、最終モデルの学習期間内にあります。条件によって誤差が変わる手掛かりですが、2期間で将来の安定性が保証されるわけではありません。不規則な製造日程でも、期間の開始と終了を明示して件数とともに比べます。
8.平均値予測とRidge回帰を比較する
比較対象があると、モデルを使う意味が分かる
最初の比較対象は、学習バッチの品質平均を、すべての評価バッチの予測に使う方法です。単純ですが、工程特徴量を使うモデルが本当に役立つかを確認できます。平均値予測より悪いなら、複雑なモデルへ進む前に、入力や対象品質、評価条件を見直します。
Ridge回帰は、複数の特徴量の重み付き和で品質を予測する線形モデルです。通常の最小二乗の誤差に、係数が大きくなりすぎることを抑える項を加えます。公式実装では残差二乗和と、alphaを掛けた係数二乗和を最小化します。[2]
似た温度特徴量を複数使う今回のような場合、係数の極端な変動を抑えながら簡単なモデルを作れる点が利点です。一方、複雑な非線形関係を自動的に表現する方法ではありません。本例はalpha=1.0に固定し、最終評価データを見て調整しません。
model = make_pipeline(StandardScaler(), Ridge(alpha=1.0))
model.fit(train[FEATURES], train.quality)
prediction = model.predict(test[FEATURES])
温度と流量では数値の尺度が違うため、StandardScalerで各特徴量の学習データ内の平均を引き、標準偏差で割ります。この平均と標準偏差は学習側だけから計算します。評価側にも同じ変換を適用します。Pipelineは変換と予測器をまとめ、こうした前処理の使い方をそろえるのに役立ちます。[3]
誤差は品質の単位で読む
MAEは、実測値と予測値の差の絶対値を平均したものです。実測が70、予測が72なら、その誤差は2です。評価バッチ全体で平均し、「通常どの程度ずれるか」を品質の単位で読みます。RMSEは差を二乗して平均した後に平方根を取り、大きな誤差の影響を強く受けます。
仮想データでの実行結果は、平均値予測のMAEが約3.00 a.u.、Ridge回帰が約0.54 a.u.、RidgeのRMSEが約0.63 a.u.でした。これは品質を温度と流量の線形関係から生成した教育用データでの結果です。実工程でも同程度の誤差になることや、出荷判定に使えることを意味しません。
9.品質未測定の新規バッチを予測する
工程が終了し、ログはそろっているが品質試験はまだ終わっていないバッチを予測します。学習時のStandardScalerとRidgeはPipelineごと保存しています。新規バッチから平均や標準偏差を学び直さず、同じ特徴量定義で変換します。
品質列のない二つのCSVを使う
入力はnew_logs.csvとnew_batches.csvです。後者はbatch_id、start、end、ramp_end、hold_endだけを持ちます。仮想例の学習を実行すると、操作練習用として翌日のNEW001の2ファイルも生成します。NEW001は最後の合成バッチの波形を複製して時刻を翌日へずらしたもので、独立した性能評価データではありません。
python process_timeseries.py --mode predict --logs process_results/new_logs.csv --batches process_results/new_batches.csv --model process_results/model.joblib --output new_results実行結果はnew_results/new_predictions.csvです。練習用NEW001の予測は約73.65 a.u.です。正解値を入力していないため、この値から予測精度を計算することはできません。品質が判明した後、IDで結び付けて誤差を追跡します。
| status | 意味 | 次の対応 |
|---|---|---|
| predicted | ログが基準を満たし、各特徴量が学習時の最小最大内 | 定めた補助判断用途で確認する |
| review_feature_range | 少なくとも1特徴量が学習時の最小最大外 | 条件差を調べる。予測値は参考値として扱う |
| held_log_quality | ログの欠測・区間不備などで特徴量を作れない | 予測値を空欄にし、reasonを確認する |
最小最大の確認は簡単な注意信号で、検証済みの適用領域ADではありません。各特徴量が範囲内でも、組合せ、品種、原料や装置が未知なら外れる可能性があります。モデルの適用範囲ADも参照してください。予測モードはログ基準で保留したバッチも元のID一覧へ戻して記録します。
保存したjoblibは、自分で作成した信頼できるものだけを読み込み、学習時と同じライブラリ環境を使います。保存形式と環境互換性の扱いは公式資料で確認できます。[7]
10.予測が外れたバッチから、次の調査を決める

散布図の点が対角線に近いほど、予測と品質が近いことを示します。しかし、図がきれいに見えるだけでは十分ではありません。残差、すなわち実測から予測を引いた差を時間順にも描きます。最近のバッチだけ同じ方向に外れるなら、原料、装置、測定、条件域の変化を疑う手掛かりになります。
test_predictions.csvを絶対誤差の大きい順に並べ、該当バッチの波形へ戻ります。保持温度が通常と違う、流量が途中で変わった、測定器を交換した、といった記録と照合します。平均にまとめることで失われた局所的な変化があれば、その工程上の意味を確認して特徴量を追加します。
Ridgeの係数は特徴量と予測の関係を表します。出力される係数は標準化した尺度なので、℃当たりの品質変化とそのまま読んではいけません。似た特徴量同士で重みが分かれることもあります。係数が正だから、その条件を上げれば品質が改善するという因果関係は結論できません。
実務での次の判断は、「モデルをさらに複雑にする」だけではありません。測定方法を確認する、原料ロットを記録する、保持区間を分ける、特定条件で確認実験を行う、といった選択があります。評価データを見て変更した場合、そのデータは改善の参考に使ったことになります。改良後の最終性能は、別の後続期間で改めて確認します。
公開データから学べる、異なる記録間隔の扱い
公開例として、UCIのCondition monitoring of hydraulic systemsがあります。油圧試験設備の60秒サイクルを2,205回記録し、圧力や電力は100Hz、流量は10Hz、温度は1Hzという異なる頻度の測定を収録しています。サイクル単位で設備の状態を扱う学習用データです。[5]
これは材料の最終品質データではありません。ただ、装置ログでも「測定点が多数あること」と「サイクル単位のラベル件数」は分けて考える必要があること、信号ごとに時間軸を整える必要があることを学べます。この記事のCSV形式へ直接入力できるデータでもないので、公開データを使う場合は別途、単位と構造を確認して変換してください。
許容誤差を決め、確認対象を一覧にする
完全版の–toleranceは、評価バッチの絶対誤差が指定値を超えたときreview_errorを付けます。初期値2.0 a.u.は説明用で、品質試験の再現性と業務判断から最終評価前に決めます。新規バッチは品質未測定なので、この誤差フラグは計算できません。
errors = pd.read_csv("process_results/test_predictions.csv")
review = errors.loc[errors["review_error"]]
print(review[["batch_id", "quality", "prediction", "absolute_error"]])
今回の合成データでは2.0を超える評価バッチは0件でした。良好な結果になるような線形関係を生成した教材であり、実工程の採用基準にはできません。品質規格の境界付近や重要な品種・装置・原料ロット別の誤差も、実データでは別途確認してください。
11.現場に持ち込む前の確認事項
よくある失敗と、改善の方向
| 失敗 | 何が起きるか | 改善の方向 |
|---|---|---|
| 測定行をランダムに分ける | 同一バッチの情報が学習と評価へ入る | 1行1バッチにして期間で分ける |
| 終了後の測定値を途中予測に使う | 運用時には入手できない情報が入る | 予測時点を固定し、使える区間を限定する |
| 長い欠測を補間する | 異常や停止を滑らかな線で隠す | 信号と工程に応じた許容間隔を決める |
| 悪いログを除外した結果だけ見る | 安定した運転だけで性能を評価する | 除外率と対象条件を併記する |
| 平均誤差だけで採用する | 重要な品質域での大きな外れを見逃す | 条件別誤差と業務上の許容値を確認する |
限界・不確かさ・責任範囲
今回のモデルは、不確かさの区間や適用領域ADを計算していません。学習にない原料、装置、温度域へ予測を広げても、数値は出ますが信頼できるとは限りません。まず学習データとの条件の違いを確認し、必要なら適用領域や予測区間の評価を追加します。範囲内というだけで正確さが保証されるわけでもありません。
また、除外したバッチに異常運転が集中していれば、残ったデータの性能は実際の全運転を代表しません。欠測時に予測を保留する手順、担当者への連絡、再測定の可否を決めましょう。品質検査の置き換え、出荷、安全に関わる判断は、この教育用コードの結果だけで行わず、既存の承認手順と実測確認を維持します。
コードはローカルで実行する構成です。実データを扱う際はアクセス権、保存場所、記録の利用権限を確認します。解析担当者は、入力・特徴量・分割日時・ライブラリのバージョン・モデル変更を残し、現場側は工程上の意味と判断への利用範囲を確認します。
実行前後のチェックリスト
- 何を、いつの時点で予測するかを一文で説明できる
- バッチID、工程境界、単位、タイムゾーンがそろっている
- 欠測、重複、除外理由と除外率を確認した
- 特徴量の区間と端点、補間の仮定を記録した
- 学習時点で利用できた品質だけを学習に使った
- 平均値予測と比較し、品質単位で誤差を読んだ
- 大きな誤差の波形と工程記録を確認した
- 未知の条件や欠測時に予測を保留する方法を決めた
FAQ
Q.最初から深層学習を使うべきですか?
まずは特徴量と簡単な回帰で、データを結ぶところから評価まで完成させる方法が取り組みやすいです。波形の細かな形が重要で、十分な独立バッチがあり、単純な特徴量では表現できないことが分かってから、他の方法を比較します。
Q.1分間隔はどの工程にも使えますか?
使えません。急速な変化を評価するなら、もっと短い間隔が必要です。今回の仮想データは緩やかな温度変化を前提にしています。間隔を粗くすると瞬間的な最大値も取り逃すため、元の高頻度ログから別途最大値を残す設計も考えます。
Q.欠測バッチはすべて削除してよいですか?
探索用の最初の例では、明確な規則で保留して理由を残す方法が分かりやすいです。実務では削除が品質不良や特定装置に偏っていないか調べます。ログの改善や、欠測を許容する別モデルを検討する余地もあります。
Q.これをソフトセンサーとして運転中に使えますか?
今回の完成後予測をそのまま使うことはできません。予測時点までの特徴量へ変更し、後の観測を使う補間を避け、通信遅れや欠測、モデル更新も含めて再検証します。完成後予測を小さく始める利点は、こうした運用へ進む前にデータの対応関係を確認できることです。
まとめ
工程ログの品質予測は、波形を描き、時刻と工程境界をそろえ、意味のある特徴量へまとめるところから始められます。次に、過去の利用可能なデータで学習し、後のバッチで平均値予測と比較します。誤差の大きいバッチを工程記録へ戻して調べることで、追加の特徴量や確認実験を判断できます。
最初の目標は、一つのCSVから高い精度を出すことだけではありません。どのバッチを使い、どの仮定で値を作り、いつ利用できた情報で評価したかを説明できる、一通りの解析を完成させることです。仮想データで動作を確認した後、対象工程に合わせて定義を変え、小さな実データで確かめてください。
12.自分のデータへの変更箇所と完全版コード
最初は1品種・1工程に絞り、単位とセンサーの対応を確認します。ログと品質表のバッチIDは一致させます。複数の最終品質や連続プロセスを扱う場合は、実験単位と対応する工程区間から設計し直してください。
| 設定・入力 | 初期値 | 変更する根拠 |
|---|---|---|
| –grid-seconds | 60秒 | 信号の応答速度と必要な時間分解能 |
| –max-gap-seconds | 180秒 | 通常の記録間隔、工程変化、許容誤差 |
| –threshold-c | 480℃ | 反応・乾燥・相変化などの工程上の意味 |
| –tolerance | 2.0 a.u. | 品質測定の再現性と判断上の許容誤差 |
| start/ramp_end/hold_end/end | 工程イベント時刻 | 自社工程の実際の区切り |
| sensor/value | temperature/flow、℃/L/min | 入力前にセンサー名と単位を変換 |
| –cutoff | 2026-02-20T00:00:00Z | 学習時点と最終評価の後続期間 |
above_threshold_minは設定した温度以上の滞在時間です。旧版のabove_threshold_minから名前を変更しました。予測時には保存済みモデルの格子・補間基準・温度閾値を使うため、学習と予測で設定が変わりません。変更したい場合は再学習し、評価し直します。
温度は滑らかな信号を想定して線形補間します。段階的な設定値には前値保持が合う場合がありますが、実測流量へ機械的に適用してよいとは限りません。秒単位の終了や昇温・保持・冷却以外の工程は、extract関数の格子と区間定義を変更してください。生ログの最大値や時間加重平均、工程別積分へ拡張する場合も、単位と端点を記録します。
python process_timeseries.py --logs process_logs.csv --quality batch_quality.csv --grid-seconds 60 --max-gap-seconds 180 --threshold-c 480 --tolerance 2 --cutoff 2026-02-20T00:00:00Z --output my_results途中の出力が想定と違うときは、batch_features.csvで対象IDを確認し、regularized_logs.csvへ戻ります。excluded_batches.csvはログ不備の理由、summary.jsonは件数・除外率・設定・実行環境を記録します。品質結果が学習時点に未到着のバッチ数も記録し、入力72件の扱いを追跡できます。
完全版Pythonコードを表示(保存名:process_timeseries.py)
"""Synthetic batch-log tutorial. Numeric settings are not process recipes."""
from pathlib import Path
import argparse, json, platform
import joblib
import numpy as np
import pandas as pd
import sklearn
import matplotlib
matplotlib.use('Agg')
import matplotlib.pyplot as plt
from sklearn.pipeline import make_pipeline
from sklearn.preprocessing import StandardScaler
from sklearn.linear_model import Ridge
from sklearn.dummy import DummyRegressor
from sklearn.metrics import mean_absolute_error, mean_squared_error

FEATURES=['temp_mean','temp_max','hold_temp_mean','hold_temp_std',
          'ramp_rate','above_threshold_min','hold_flow_mean']

def synthetic(out):
    rng=np.random.default_rng(42); rows=[]; batches=[]
    for i in range(72):
        bid=f'B{i+1:03d}'; start=pd.Timestamp('2026-01-01 09:00',tz='UTC')+pd.Timedelta(days=i)
        target=rng.uniform(455,525); flow=rng.uniform(1.4,2.6)
        elapsed=np.arange(61)
        temp=np.where(elapsed<20,25+(target-25)*elapsed/20,
             np.where(elapsed<40,target,target-(target-60)*(elapsed-40)/20))
        temp=temp+rng.normal(0,1.0,61)
        q=70+.12*(target-490)+7*(flow-2)+rng.normal(0,.8)
        for t,v in zip(elapsed,temp):
            # One isolated gap; B008 additionally has an unacceptable long gap.
            if t==12 or (i==7 and 25<=t<=31):continue
            rows.append([bid,start+pd.Timedelta(minutes=int(t)),'temperature',float(v)])
        for t in range(0,61,2):
            rows.append([bid,start+pd.Timedelta(minutes=t),'flow',float(flow+rng.normal(0,.025))])
        batches.append([bid,start,start+pd.Timedelta(minutes=60),
                        start+pd.Timedelta(minutes=20),start+pd.Timedelta(minutes=40),
                        start+pd.Timedelta(days=3),float(q)])
    logs=pd.DataFrame(rows,columns=['batch_id','timestamp','sensor','value'])
    meta=pd.DataFrame(batches,columns=['batch_id','start','end','ramp_end','hold_end','quality_available_at','quality'])
    logs.to_csv(out/'process_logs.csv',index=False);meta.to_csv(out/'batch_quality.csv',index=False)
    return logs,meta

def prepare(logs,meta,require_quality=True):
    logs=logs.copy();meta=meta.copy()
    if not {'batch_id','timestamp','sensor','value'}<=set(logs):raise ValueError('Missing log columns')
    if not {'batch_id','start','end','ramp_end','hold_end'}<=set(meta):raise ValueError('Missing batch columns')
    if logs[['batch_id','timestamp','sensor']].isna().any().any() or meta.batch_id.isna().any():raise ValueError('Missing identity/time')
    if meta.batch_id.duplicated().any():raise ValueError('Duplicate batch ID in metadata')
    if set(logs.batch_id)!=set(meta.batch_id):raise ValueError('Log/metadata batch IDs do not match')
    def parse_time(values):
        for value in values:
            if pd.isna(value) or pd.Timestamp(value).tzinfo is None:
                raise ValueError('Timezone must be explicit: Z or +09:00')
        return pd.to_datetime(values, utc=True, errors='raise')
    logs['timestamp'] = parse_time(logs.timestamp)
    for c in ['start','end','ramp_end','hold_end']:
        meta[c] = parse_time(meta[c])
    if require_quality:
        if not {'quality','quality_available_at'} <= set(meta):
            raise ValueError('Training requires quality and quality_available_at')
        meta['quality_available_at'] = parse_time(meta.quality_available_at)
    else:
        meta['quality'] = np.nan
        meta['quality_available_at'] = meta.end
    if logs.duplicated(['batch_id','sensor','timestamp']).any():raise ValueError('Duplicate sensor timestamp')
    for c in ['value']:
        logs[c]=pd.to_numeric(logs[c],errors='raise')
        if not np.isfinite(logs[c].dropna()).all():raise ValueError('Infinite sensor value')
    meta['quality']=pd.to_numeric(meta.quality,errors='raise')
    if require_quality and not np.isfinite(meta.quality).all():raise ValueError('Missing/nonfinite quality')
    if not ((meta.start<meta.ramp_end)&(meta.ramp_end<meta.hold_end)&(meta.hold_end<meta.end)&(meta.quality_available_at>=meta.end)).all():raise ValueError('Invalid phase/availability order')
    if not set(logs.sensor)<= {'temperature','flow'}:raise ValueError('Unknown sensor; adapt schema explicitly')
    return logs.sort_values(['batch_id','sensor','timestamp']),meta

def regularize(g,grid,max_gap_s=180):
    s=g.set_index('timestamp').value.dropna().sort_index()
    if len(s)<2:raise ValueError('Insufficient observed sensor data')
    if s.index[0]>grid[0] or s.index[-1]<grid[-1]:raise ValueError('Missing boundary; no extrapolation')
    if np.max((s.index[1:]-s.index[:-1]).total_seconds())>max_gap_s:raise ValueError(f'Observed gap exceeds {max_gap_s} seconds')
    # Retain off-grid observations before time interpolation; never join batches.
    merged=s.reindex(s.index.union(grid)).sort_index().interpolate(method='time',limit_area='inside')
    out=merged.reindex(grid)
    if out.isna().any():raise ValueError('Unfilled grid value')
    return out.to_numpy()

def extract(logs,meta,out,config=None,allow_empty=False):
    config = config or {"grid_seconds":60,"max_gap_seconds":180,"threshold_c":480.0}
    rows=[];errors=[];curves=[]
    for r in meta.itertuples(index=False):
        try:
            g=logs[logs.batch_id==r.batch_id]
            if ((g.timestamp<r.start)|(g.timestamp>r.end)).any():raise ValueError('Log outside batch interval')
            grid=pd.date_range(r.start,r.end,freq=pd.Timedelta(seconds=config['grid_seconds']))
            if len(grid)<4 or grid[-1]!=r.end:raise ValueError('End must align to configured grid')
            temp=regularize(g[g.sensor=='temperature'],grid,config['max_gap_seconds'])
            flow=regularize(g[g.sensor=='flow'],grid,config['max_gap_seconds'])
            minutes=(grid-r.start).total_seconds().to_numpy()/60
            ramp_end=(r.ramp_end-r.start).total_seconds()/60
            hold_end=(r.hold_end-r.start).total_seconds()/60
            ramp=minutes<ramp_end;hold=(minutes>=ramp_end)&(minutes<hold_end)
            if ramp.sum()<2 or hold.sum()<2:raise ValueError('Insufficient phase points')
            slope=np.polyfit(minutes[ramp],temp[ramp],1)[0]
            # Left-endpoint approximation; endpoint itself carries no duration.
            duration=float(np.sum(np.diff(minutes)*(temp[:-1]>=config['threshold_c'])))
            rows.append(dict(batch_id=r.batch_id,start=r.start,end=r.end,
                temp_mean=float(np.mean(temp)),temp_max=float(np.max(temp)),
                hold_temp_mean=float(np.mean(temp[hold])),hold_temp_std=float(np.std(temp[hold],ddof=1)),
                ramp_rate=float(slope),above_threshold_min=duration,hold_flow_mean=float(np.mean(flow[hold]))))
            curves.append(pd.DataFrame({'batch_id':r.batch_id,'timestamp':grid,'elapsed_min':minutes,'temperature':temp,'flow':flow}))
        except ValueError as e:errors.append({'batch_id':r.batch_id,'reason':str(e)})
    pd.DataFrame(errors,columns=['batch_id','reason']).to_csv(out/'excluded_batches.csv',index=False)
    if not rows:
        if allow_empty:
            return pd.DataFrame(columns=['batch_id','start','end','quality',*FEATURES]),pd.DataFrame(),errors
        raise ValueError('No valid batches; inspect excluded_batches.csv')
    features=pd.DataFrame(rows)
    # Every retained batch has exactly one label row; never an inner join that hides loss.
    data=features.merge(meta[['batch_id','quality','quality_available_at']],on='batch_id',how='left',validate='one_to_one',indicator=True)
    if not (data['_merge']=='both').all():raise ValueError('Unmatched retained batch')
    data.drop(columns='_merge').to_csv(out/'batch_features.csv',index=False)
    clean=pd.concat(curves,ignore_index=True);clean.to_csv(out/'regularized_logs.csv',index=False)
    return data,clean,errors

def plots(logs,clean,data,train,test,pred,out):
    ids=clean.batch_id.drop_duplicates().iloc[:3]
    fig,ax=plt.subplots(1,2,figsize=(10,3.5))
    for bid in ids:
        d=clean[clean.batch_id==bid];ax[0].plot(d.elapsed_min,d.temperature,label=bid)
    for boundary in [20,40]:
        ax[0].axvline(boundary, color='gray', linestyle=':', linewidth=1)
    ax[0].set(xlabel='Elapsed time / min',ylabel='Temperature / C',title='Synthetic batch profiles');ax[0].legend()
    bid=ids.iloc[0];start=data.set_index('batch_id').loc[bid,'start']
    raw=logs[(logs.batch_id==bid)&(logs.sensor=='temperature')]
    d=clean[clean.batch_id==bid];ax[1].scatter((raw.timestamp-start).dt.total_seconds()/60,raw.value,s=12,label='Observed')
    ax[1].plot(d.elapsed_min,d.temperature,label='1 min grid');ax[1].set(xlim=(9,15),xlabel='Elapsed time / min',ylabel='Temperature / C',title='Short gap: synthetic interpolation');ax[1].legend()
    fig.tight_layout();fig.savefig(out/'process_profiles.png',dpi=140);plt.close(fig)
    fig,ax=plt.subplots(figsize=(8,2.5));ax.scatter(train.end,np.zeros(len(train)),label='Train: labels available');ax.scatter(test.end,np.ones(len(test)),label='Test: later batches')
    unavailable=data[(data.end<test.end.min())&(~data.batch_id.isin(train.batch_id))]
    if len(unavailable):ax.scatter(unavailable.end,np.full(len(unavailable),.5),marker='x',label='Excluded: label unavailable at cutoff')
    ax.set(yticks=[],xlabel='Batch end date / UTC',title='Chronological holdout');ax.legend(fontsize=7,loc='lower left',bbox_to_anchor=(0,1.15),ncol=3);fig.autofmt_xdate();fig.tight_layout();fig.savefig(out/'process_split.png',dpi=140);plt.close(fig)
    fig,ax=plt.subplots(1,2,figsize=(9,3.5));ax[0].scatter(test.quality,pred);v=np.r_[test.quality,pred];ax[0].plot([v.min(),v.max()],[v.min(),v.max()],'k--');ax[0].set(xlabel='Synthetic measured quality / a.u.',ylabel='Predicted quality / a.u.')
    ax[1].plot(test.end,test.quality-pred,'o-');ax[1].axhline(0,color='k');ax[1].set(xlabel='Batch end date / UTC',ylabel='Residual / a.u.');fig.autofmt_xdate();fig.tight_layout();fig.savefig(out/'process_predictions.png',dpi=140);plt.close(fig)

def main():
    parser = argparse.ArgumentParser()
    parser.add_argument('--mode', choices=['train','predict'], default='train')
    parser.add_argument('--logs')
    parser.add_argument('--quality', help='Training batch metadata including measured quality')
    parser.add_argument('--batches', help='Prediction metadata: batch_id,start,end,ramp_end,hold_end')
    parser.add_argument('--model', default='process_results/model.joblib')
    parser.add_argument('--cutoff', default='2026-02-20T00:00:00Z')
    parser.add_argument('--output', default='process_results')
    parser.add_argument('--grid-seconds', type=int, default=60)
    parser.add_argument('--max-gap-seconds', type=int, default=180)
    parser.add_argument('--threshold-c', type=float, default=480.0)
    parser.add_argument('--tolerance', type=float, default=2.0,
                        help='Educational review tolerance in quality units; choose before final evaluation')
    args = parser.parse_args()
    out = Path(args.output)
    out.mkdir(parents=True, exist_ok=True)
    config = dict(grid_seconds=args.grid_seconds,max_gap_seconds=args.max_gap_seconds,threshold_c=args.threshold_c)
    if args.grid_seconds <= 0 or args.max_gap_seconds <= 0 or args.tolerance < 0:
        parser.error('Grid/gap must be positive and tolerance nonnegative')
    if args.mode == 'predict':
        if not args.logs or not args.batches:
            parser.error('Prediction requires --logs and --batches')
        # Load only a trusted model saved by this script in the same environment.
        bundle = joblib.load(args.model)
        config = bundle['config']
        logs, meta = prepare(pd.read_csv(args.logs),pd.read_csv(args.batches),require_quality=False)
        data, clean, errors = extract(logs,meta,out,config,allow_empty=True)
        result = meta[['batch_id','end']].copy()
        valid = data[FEATURES]
        outside = ((valid < pd.Series(bundle['feature_min'])) | (valid > pd.Series(bundle['feature_max']))).any(axis=1)
        predictions = data[['batch_id']].copy()
        predictions['prediction'] = bundle['model'].predict(valid) if len(valid) else np.array([])
        predictions['status'] = np.where(outside,'review_feature_range','predicted')
        # A range check is a review signal, not a validated applicability domain.
        result = result.merge(predictions,on='batch_id',how='left',validate='one_to_one')
        result['status'] = result.status.fillna('held_log_quality')
        reason = {r['batch_id']:r['reason'] for r in errors}
        result['reason'] = result.batch_id.map(reason).fillna('')
        result.to_csv(out/'new_predictions.csv',index=False)
        print(result.to_string(index=False))
        return
    if bool(args.logs) != bool(args.quality):
        parser.error('Provide both --logs and --quality, or neither for demo')
    if args.logs:
        logs,meta = pd.read_csv(args.logs),pd.read_csv(args.quality)
        mode = 'User data; physical validity requires review'
    else:
        logs,meta = synthetic(out)
        mode = 'Synthetic educational data, not material measurements'
        # Make a label-free, later batch for end-to-end prediction practice.
        newest = meta.iloc[[-1]].copy()
        newest['batch_id'] = 'NEW001'
        for c in ['start','end','ramp_end','hold_end']:
            newest[c] = newest[c] + pd.Timedelta(days=1)
        new_logs = logs[logs.batch_id == meta.iloc[-1].batch_id].copy()
        new_logs['batch_id'] = 'NEW001'
        new_logs['timestamp'] += pd.Timedelta(days=1)
        new_logs.to_csv(out/'new_logs.csv',index=False)
        newest[['batch_id','start','end','ramp_end','hold_end']].to_csv(out/'new_batches.csv',index=False)
    logs,meta = prepare(logs,meta)
    data,clean,errors = extract(logs,meta,out,config)
    cutoff = pd.Timestamp(args.cutoff)
    if cutoff.tzinfo is None:
        raise ValueError('Cutoff timezone must be explicit')
    cutoff = cutoff.tz_convert('UTC')
    train = data[(data.end<cutoff)&(data.quality_available_at<=cutoff)].sort_values('end')
    test = data[data.end>=cutoff].sort_values('end')
    if len(train)<10 or len(test)<5:
        raise ValueError('Need >=10 train and >=5 test batches; review cutoff')
    baseline = DummyRegressor(strategy='mean').fit(train[FEATURES],train.quality)
    model = make_pipeline(StandardScaler(),Ridge(alpha=1.0)).fit(train[FEATURES],train.quality)
    pred = model.predict(test[FEATURES])
    bp = baseline.predict(test[FEATURES])
    predictions = test[['batch_id','end','quality']].copy()
    predictions['prediction'] = pred
    predictions['baseline'] = bp
    predictions['absolute_error'] = np.abs(test.quality-pred)
    predictions['review_error'] = predictions.absolute_error > args.tolerance
    predictions.sort_values('absolute_error',ascending=False).to_csv(out/'test_predictions.csv',index=False)
    pd.DataFrame({'feature':FEATURES,'coefficient_in_standardized_units':model[-1].coef_}).to_csv(out/'ridge_coefficients.csv',index=False)
    versions = dict(python=platform.python_version(),numpy=np.__version__,pandas=pd.__version__,sklearn=sklearn.__version__)
    joblib.dump(dict(model=model,features=FEATURES,config=config,cutoff=str(cutoff),versions=versions,
                     feature_min=train[FEATURES].min().to_dict(),feature_max=train[FEATURES].max().to_dict()),out/'model.joblib')
    # Earlier rolling calendar windows are development diagnostics; final test remains separate.
    reports = []
    for delta in [20,10]:
        origin = cutoff-pd.Timedelta(days=delta)
        tr = data[(data.end<origin)&(data.quality_available_at<=origin)]
        va = data[(data.end>=origin)&(data.end<origin+pd.Timedelta(days=10))]
        if len(tr)>=10 and len(va)>=5:
            m = make_pipeline(StandardScaler(),Ridge(alpha=1.0)).fit(tr[FEATURES],tr.quality)
            reports.append(dict(origin=str(origin),end=str(origin+pd.Timedelta(days=10)),train=len(tr),validation=len(va),mae=float(mean_absolute_error(va.quality,m.predict(va[FEATURES])))))
    pd.DataFrame(reports,columns=['origin','end','train','validation','mae']).to_csv(out/'period_validation.csv',index=False)
    summary = dict(mode=mode,cutoff=str(cutoff),input_batches=len(meta),retained_batches=len(data),
                   excluded_log_batches=errors,excluded_rate=len(errors)/len(meta),training_batches=len(train),test_batches=len(test),
                   unavailable_label_batches=int(((data.end<cutoff)&(data.quality_available_at>cutoff)).sum()),
                   features=FEATURES,alpha_fixed=1.0,config=config,versions=versions,
                   tolerance=args.tolerance,review_error_batches=int(predictions.review_error.sum()),
                   baseline_mae=float(mean_absolute_error(test.quality,bp)),ridge_mae=float(mean_absolute_error(test.quality,pred)),
                   ridge_rmse=float(np.sqrt(mean_squared_error(test.quality,pred))))
    (out/'summary.json').write_text(json.dumps(summary,ensure_ascii=False,indent=2))
    plots(logs,clean,data,train,test,pred,out)
    print(json.dumps(summary,ensure_ascii=False,indent=2))

if __name__ == '__main__':
    main()
参考文献
[1]pandas development team. Time series / date functionality. pandas公式ドキュメント、継続更新、2026年10月8日確認。https://pandas.pydata.org/docs/user_guide/timeseries.html
[2]scikit-learn developers. sklearn.linear_model.Ridge. scikit-learn公式APIドキュメント、継続更新、2026年10月8日確認。https://scikit-learn.org/stable/modules/generated/sklearn.linear_model.Ridge.html
[3]scikit-learn developers. Common pitfalls and recommended practices. scikit-learn公式ドキュメント、継続更新、2026年10月8日確認。https://scikit-learn.org/stable/common_pitfalls.html
[4]scikit-learn developers. sklearn.model_selection.TimeSeriesSplit. scikit-learn公式APIドキュメント、継続更新、2026年10月8日確認。https://scikit-learn.org/stable/modules/generated/sklearn.model_selection.TimeSeriesSplit.html
[5]Helwig, N., Pignanelli, E., & Schütze, A. (2015). Condition monitoring of hydraulic systems [Dataset]. UCI Machine Learning Repository. DOI: 10.24432/C5CW21. https://archive.ics.uci.edu/dataset/447/condition+monitoring+of+hydraulic+systems (2026年10月8日確認)
[6]Hyndman, R. J. & Athanasopoulos, G. Forecasting: Principles and Practice, 3rd ed., Chapter 2. Time series graphics(2026年10月9日確認)。
[7]scikit-learn developers. Model persistence(2026年10月9日確認)。